#前沿研究
共 6835 篇相关文章

递归语言模型如何实现真正推理:跳出分布外泛化困境
一篇 arXiv 新论文提出反直觉观点:限制语言模型的可见范围反而能提升分布外推理能力。递归语言模型通过上下文隔离排除捷径依赖,挑战了经典学习理论中'覆盖正确规则即可学会'的假设。
传音的说话人归属多语种ASR系统:MLC-SLM 2026挑战赛亚军方案解析
传音语音团队在MLC-SLM 2026挑战赛提交的说话人归属多语种ASR系统解析。基于DiariZen说话人日志、Qwen3-Omni多语种ASR与CTC对齐的级联框架,以15.41%的tcpMER排名第二。
TatBLiMP:首个鞑靼语语法能力评测基准解读
TatBLiMP是首个针对鞑靼语的语法能力评测基准,覆盖16种形态句法现象、1248对最小对立句。研究发现针对性训练比参数规模更能提升低资源语言模型的语法能力。
Reviser:让文本生成模型学会像人一样修改草稿
Reviser 是一种支持修改能力的文本生成模型,通过在可变画布上执行光标动作(插入、移动、停止)实现非单调生成。它在质量上优于扩散模型基线,推理算力更低,为文本生成提供了新范式。

DischargeBench:让LLM学会向病人讲清出院医嘱
arXiv最新研究提出DischargeBench,一个以病人理解为核心的LLM出院教育评测框架。通过人格锚定的虚拟病人模拟和四维评分,揭示大模型在困难病人场景下的覆盖失败与理解鸿沟。
SAGE:用Schema引导LLM做拨款评审,人机协作达成中高一致性
arXiv 最新研究提出 SAGE 系统,用 Schema 引导大语言模型进行拨款评审。通过结构化检查与证据链接,SAGE 在人机协作模式下达成 kappa=0.58 的中高一致性,显著优于简单提示基线,为 AI 辅助专业评审提供可审计范式。
TALON框架:时序感知让放射学报告生成更懂"变化"
TALON是一个时序感知的纵向放射学报告生成框架,通过双通道时序融合模块(DCTFM)自适应整合可变长度患者病史,在MIMIC-CXR数据集上超越现有最先进方法,且病史越长表现越好。

HERMES:用知识图谱从临床文本预测患者结局
arXiv 新论文提出 HERMES 框架,完全基于临床文本构建个性化知识图谱,通过对比逻辑建模与图注意力网络进行患者结局预测。在 MIMIC-III/IV 上的院内死亡率与再入院预测任务中持续超越纯文本基线。
SpecOpt:用智能体优化药物分子的靶向特异性
SpecOpt 提出了一项全新的分子设计任务:通过智能体框架结合残基感知接触分析与大语言模型推理,优化现有药物的靶向特异性。在 915 个化合物上,84.8% 获得结合选择性改善。

小语言模型知道自己不知道什么吗?语义熵是关键
一篇 arXiv 研究揭示:小语言模型(SLM)的 token 级熵几乎失效,但语义熵能有效捕捉不确定性,并通过路由给专家模型带来最高 +50 个百分点的准确率提升,跨家族路由效果远超同家族路由。
AI精神科问诊质量如何把关?临床验证平台给出答案
arXiv最新研究提出InterviewPlayground平台,用记忆增强模拟患者对AI精神科问诊进行质量评估。试点显示LLM信息挖掘率达88%远超医生,但临床幻觉更多、安全隐患刻画不足,为AI医疗部署提供质量把关框架。
AI智能体设计芯片:高层抽象HLS工作流实现2.6倍加速
最新arXiv论文提出AHRR工作流,让AI智能体在HLS高层抽象层设计芯片并结合RTL细化,在11任务基准上实现2.6倍加速,为智能体驱动的芯片设计提供新范式。

微调如何重塑大模型内部机制:表征变化与因果重要性的解耦研究
一篇 arXiv 研究揭示大语言模型微调如何重塑内部机制:表征变化最剧烈的层与真正起因果作用的关键组件并不重合,且跨任务组件重叠不等于性能迁移,甚至可能导致相互干扰。
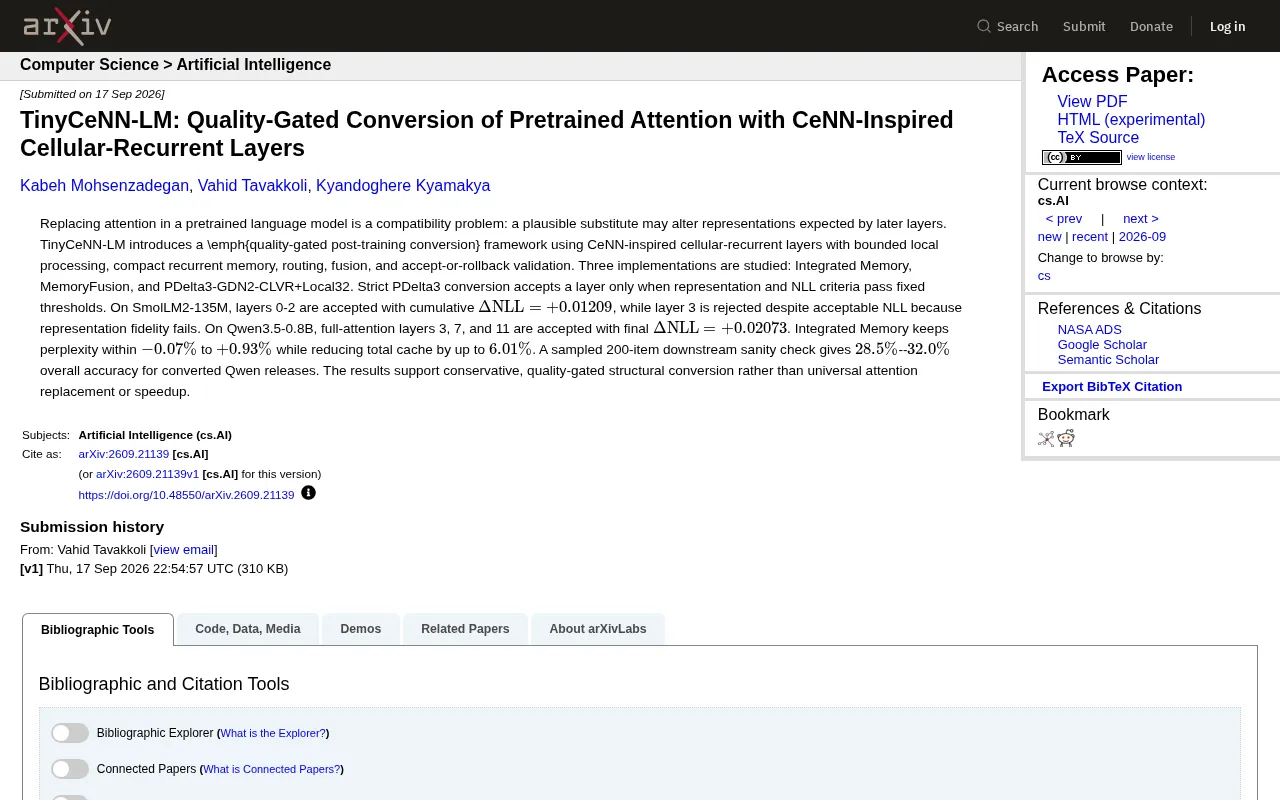
TinyCeNN-LM:用质量门控替换预训练注意力层
TinyCeNN-LM 提出质量门控的后训练转换框架,用 CeNN 启发的细胞循环层替换预训练模型的注意力层。在 SmolLM2-135M 与 Qwen3.5-0.8B 上逐层验证,缓存最多减少 6.01%,主张保守的质量门控结构转换。

拓扑视角揭示大模型幻觉:注意力图中的信息流失真信号
一篇 arXiv 新研究提出用注意力图的拓扑结构检测大模型幻觉,通过 Forman-Ricci 曲率识别信息瓶颈,仅需单次前向传播即可判别幻觉,并揭示过度自注意力、上下文弥散与信息挤压三种失真机制。
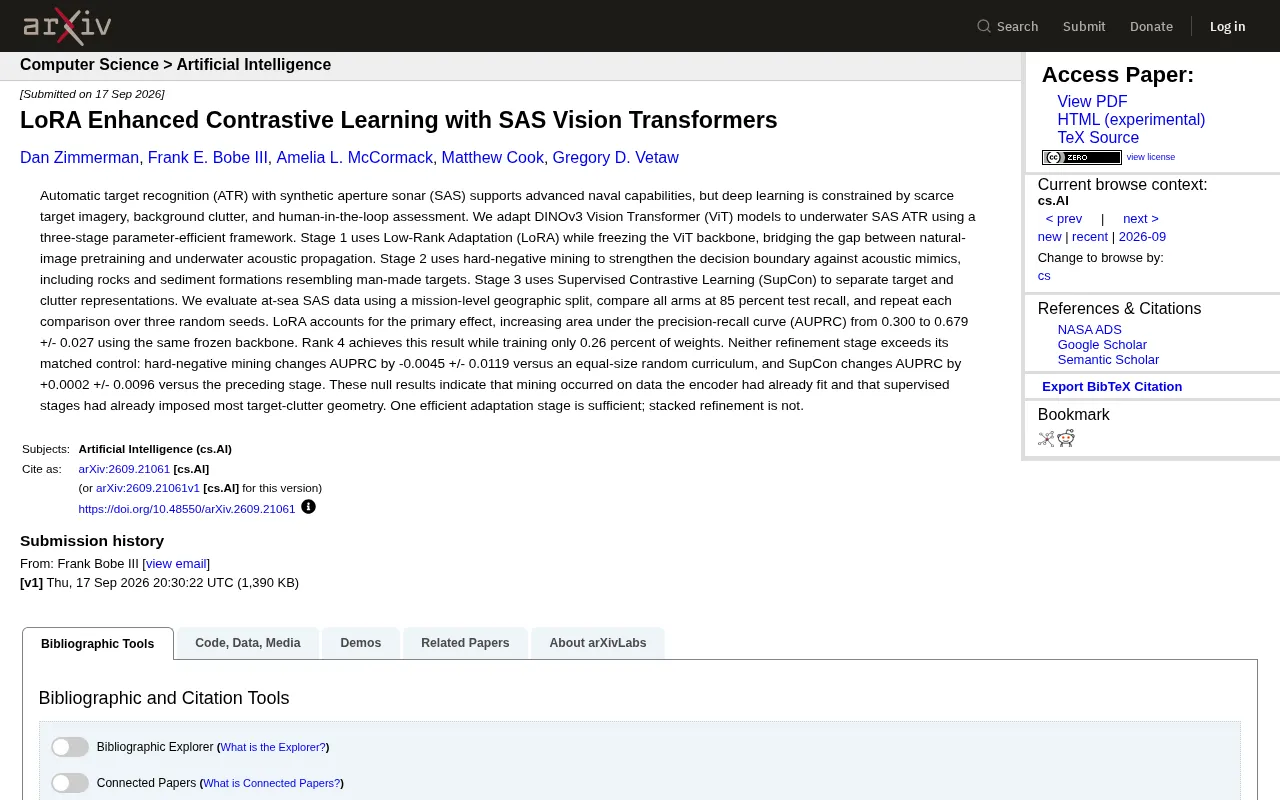
LoRA微调DINOv3实现声呐目标识别:一次高效适配足矣
arXiv最新论文将DINOv3视觉Transformer迁移到合成孔径声呐目标识别,通过LoRA低秩适配仅训练0.26%权重就让AUPRC从0.300提升至0.679,而难负样本挖掘与监督对比学习几乎无额外增益,揭示一个高效适配阶段已足够。

知识蒸馏详解:如何让小模型学会大模型的本领
知识蒸馏(Knowledge Distillation)是让小模型学习大模型能力的关键模型压缩技术。本文详解软标签、温度参数、损失函数等核心机制,以及它为何有效和实际应用场景。
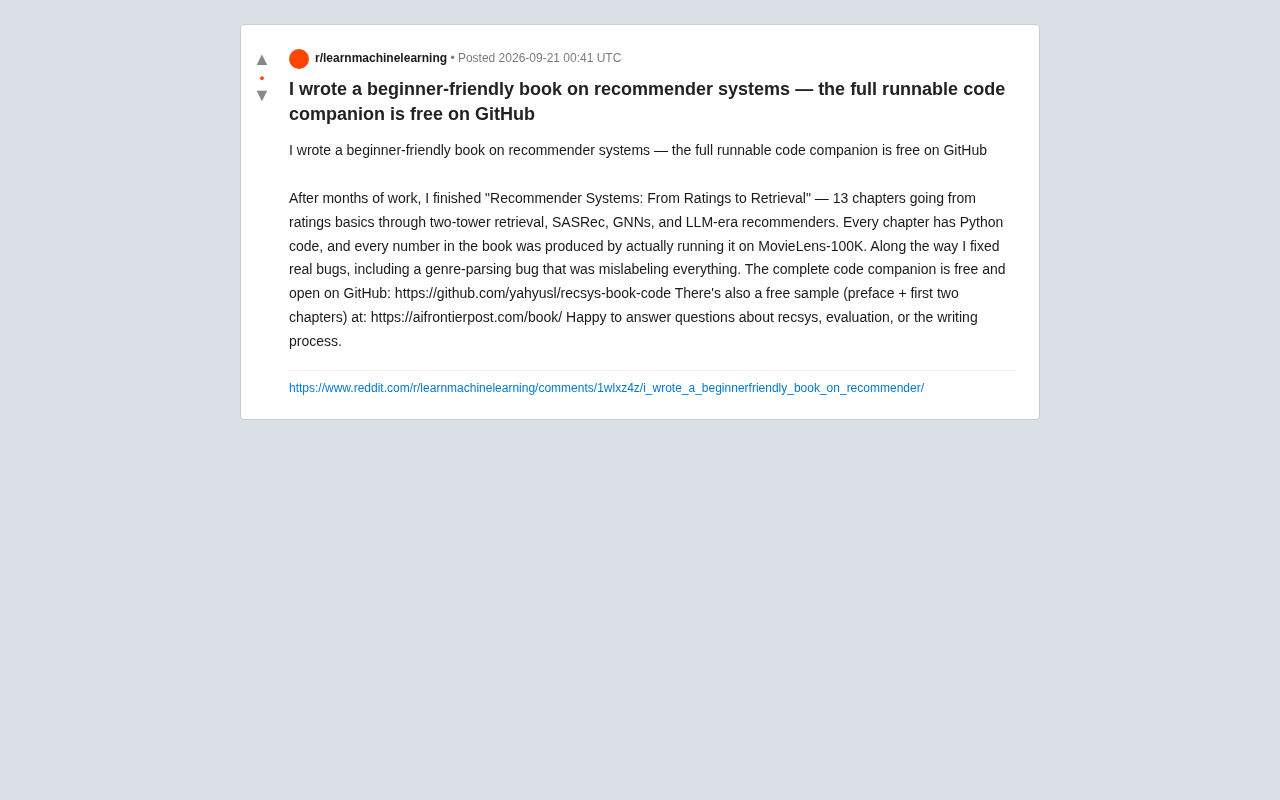
从评分到检索:一本面向初学者的推荐系统实战书籍与免费代码
一位开发者开源了推荐系统入门书《From Ratings to Retrieval》的完整可运行代码,涵盖评分预测、双塔检索、SASRec、GNN 到 LLM 推荐系统,所有数据基于 MovieLens-100K 实测,GitHub 免费获取。

