#前沿研究
共 8684 篇相关文章
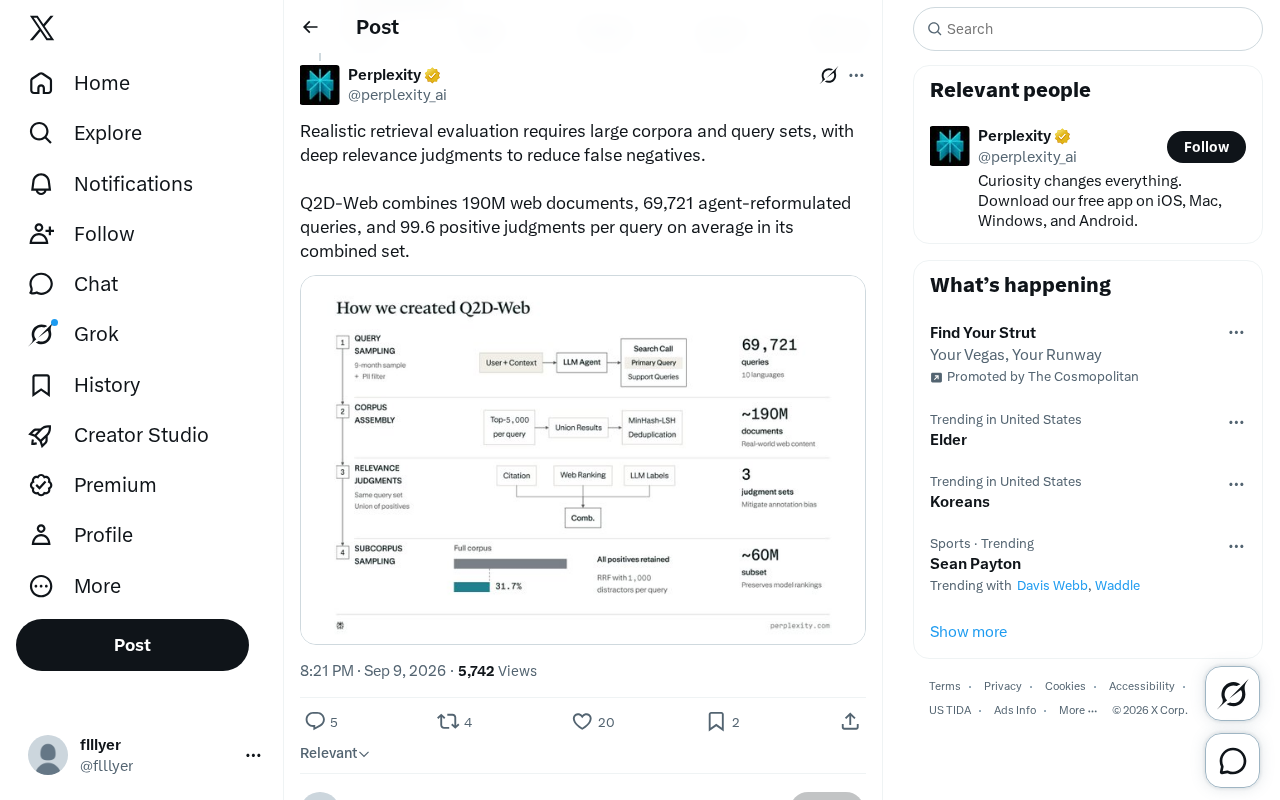
Q2D-Web:用1.9亿网页重构检索评测的真实性标准
Q2D-Web 检索评测数据集结合 1.9 亿网页文档、6.9 万条 agent 重构查询与平均每查询 99.6 个正相关判断,通过大规模语料与深度相关性标注减少假阴性,为检索与 RAG 研究提供更真实的评测基准。
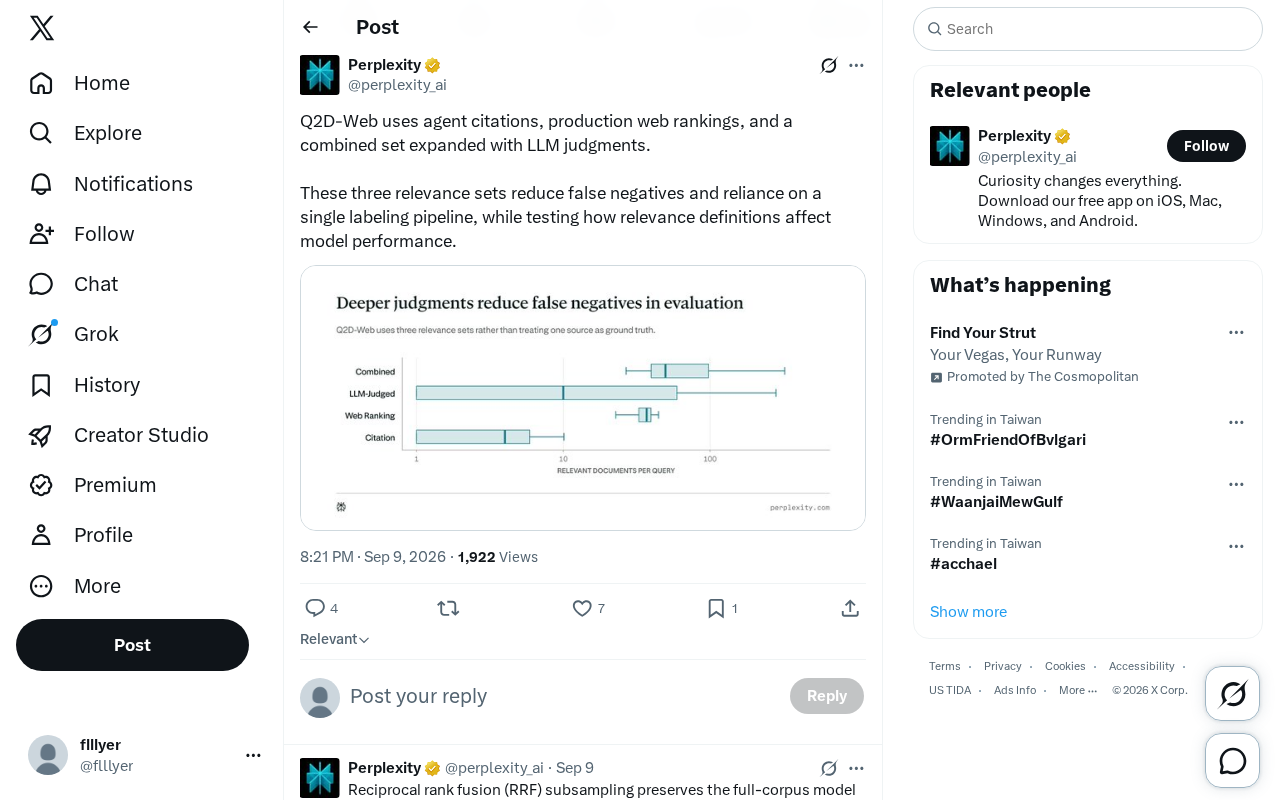
Q2D-Web:多重相关性标注如何重塑检索评测
Q2D-Web 采用智能体引用、生产网页排名与 LLM 扩展的三套相关性集合,减少检索评测中的假阴性和单一标注依赖,并检验相关性定义如何影响模型表现。
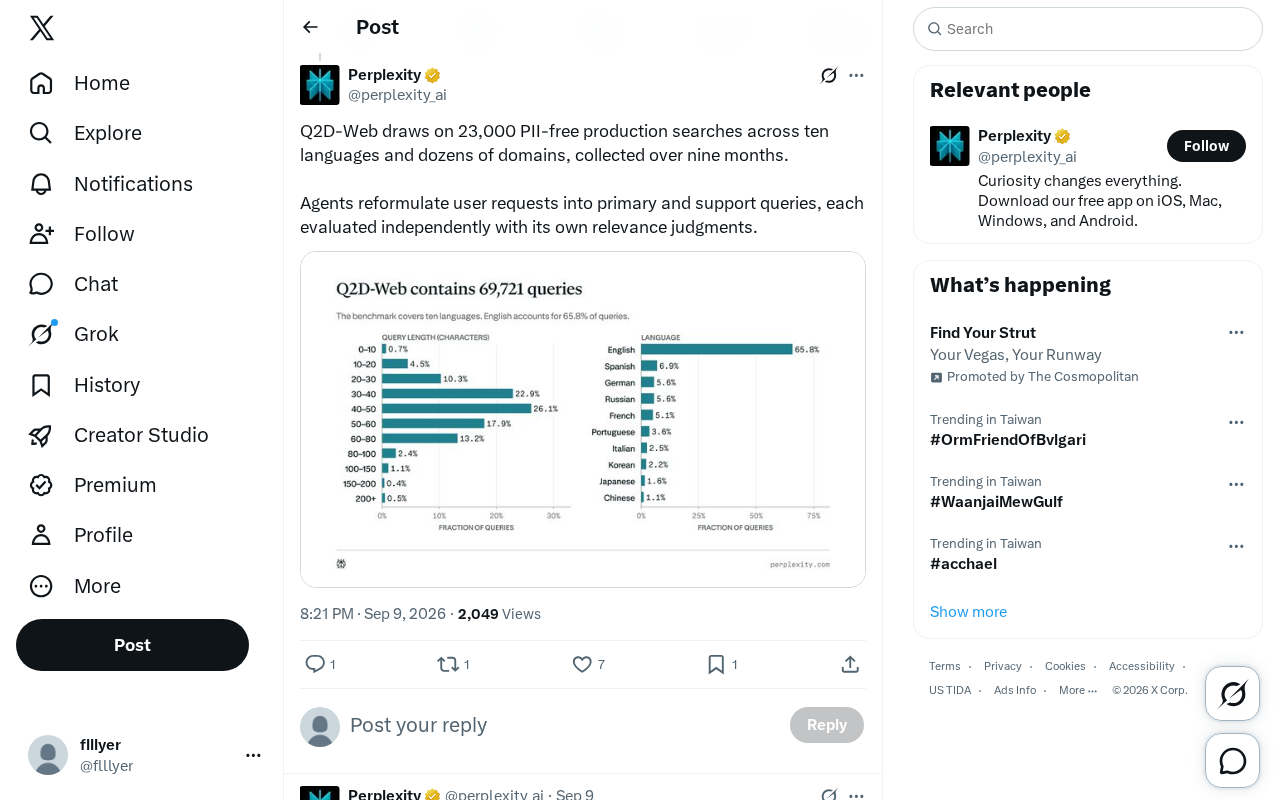
Q2D-Web数据集:23000条真实搜索背后的Agent查询重构评测
Q2D-Web数据集汇集23000条无PII生产搜索,覆盖十种语言和数十个领域,历时九个月采集。它通过将用户请求重构为主查询与支持查询并独立评估相关性,为检索式Agent的查询重构能力提供了贴近真实的评测基准。
抽取式摘要新框架:CNN-BiLSTM如何解决医疗文本的事实幻觉难题
一篇arXiv论文提出Hybrid Hierarchical CNN-BiLSTM抽取式摘要框架,通过移除生成环节、直接从原文选句,解决生物医学与临床文本的事实幻觉难题,在PubMed、MIMIC等数据集上验证效果与局限。
临床时序推理中的后见之明偏差:未来数据如何扭曲大模型判断
arXiv最新研究揭示临床语言模型的后见之明偏差:当模型接触包含结局的完整时间线时会产生系统性判断偏移,而时间遮蔽能在不降低准确率的前提下减少偏差。文章解析171病例配对基准与四项评估指标。
全双工语音大模型的"抢话"难题:因果分析与实时抑制方法
全双工语音大模型 Moshi 和 PersonaPlex 在用户沉默时会不当开口。本文解析虚假开口的因果成因,介绍一种基于反事实干预、无需重训练、可实时运行的抑制方法,实测完美抑制虚假发声并保留真实回应。
CVSS-X:覆盖28种语言的大规模语音翻译语料库
CVSS-X 是一个覆盖 28 种语言、12 个语系的大规模合成语音到语音翻译语料库,总时长超 16000 小时,是原始 CVSS 的八倍,支持双向多语言语音翻译研究,已开源发布。
锥形束CT报告生成:部分可观测目标下的临床推理陷阱
一篇arXiv新论文揭示锥形束CT(CBCT)报告生成中的评估陷阱:追逐词汇重叠指标会拉低事实准确性,模型学到的往往是各医疗机构的口述习惯而非解剖结构,为医学AI评估提供了重要方法论警示。
RFCLLM:大模型真能读懂网络协议状态机吗?
arXiv 新论文 RFCLLM 系统评测大语言模型对网络协议状态机(FSM)的推理能力,覆盖 16 种协议、4 类任务、1482 条查询,揭示 LLM 在协议规范理解上的真实边界。
TestHallVQA:冗余上下文下大视觉语言模型的文档级推理新基准
TestHallVQA 是一个面向大视觉语言模型(LVLMs)的多图 VQA 新基准,融合文档级规模与科学考试难度,并提出 F1-R² 指标量化模型在冗余上下文下的推理与证据检索鲁棒性,揭示主流模型的潜在缺陷。
无需训练的Prompt压缩:CPU即可运行的确定性词法方案
arXiv新研究提出无需训练、纯CPU运行的确定性Prompt压缩管线,通过十一种词法变换在1242条Prompt上实证:最激进配置削减40.3%token,仅停用词方案保真度达0.913,并揭示常识推理为激进压缩下的系统性失效点。

PhysMent:用交互式物理仿真评测大模型的物理推理能力
PhysMent 是一个基于 MuJoCo 仿真器的交互式基准测试,通过施力、观测、推进时间等工具调用评测大语言模型的物理推理能力。研究发现模型在定性任务表现尚可,但定量多步实验任务准确率骤降,瓶颈在于流程性工具使用而非物理知识本身。
Token Merging:让多语种语音识别更快更省的实用方案
一项 arXiv 研究系统评测了 Token Merging 词元合并技术在 Whisper 多语种语音识别上的效果,覆盖 16 种语言与 3 种模型规模,证明它能在几乎不损失准确率的前提下大幅提升推理效率,且与 DoRA 微调兼容。
OrchSLM:小语言模型协同编排的机制探究
OrchSLM 是一个用于探究小语言模型(SLM)非交互式协同编排机制的路由框架,将编排的设计选择转化为可控参数,系统分析任务结构、模型池组成与多智能体共识如何影响编排行为,为 agentic 系统部署提供新视角。

机器速度下的AI治理:AGIL自适应架构解析
arXiv论文提出AGIL自适应治理智能层,一个五层架构用机器学习实现实时AI政策执行。文章解析企业AI治理中的"认证赤字"问题,及基于斯坦福AI Index等三份权威报告的数据洞察。
AI智能体故障归因:把根因分析变成一个搜索问题
arXiv新论文提出Continual Search框架,将AI智能体的根因归因重新定义为搜索问题,通过多轮迭代让LLM持续追查故障证据。在MegaRCA-Mix基准上将GPT-5.5的F1分数提升超40%,且低配模型可超越高配模型。
LabAgent:为科研实验室打造可复现的AI智能体系统
arXiv新论文提出LabAgent,一套面向科研实验室的AI智能体系统,通过可执行验证和经验记录两大机制解决科研方法传承难题,在药物预测、蛋白质变异等生命科学领域超越通用智能体。

TimeThink:让时序大模型学会组合式推理的合成框架
TimeThink 是一个用于激发时序大模型组合式推理能力的合成框架,通过确定性生成可验证的问答数据与 RLVR 训练策略,仅用合成数据即在真实基准上超越强基线,为医疗等高风险场景的可解释时序推理提供新思路。