#大模型评测
共 54 篇相关文章
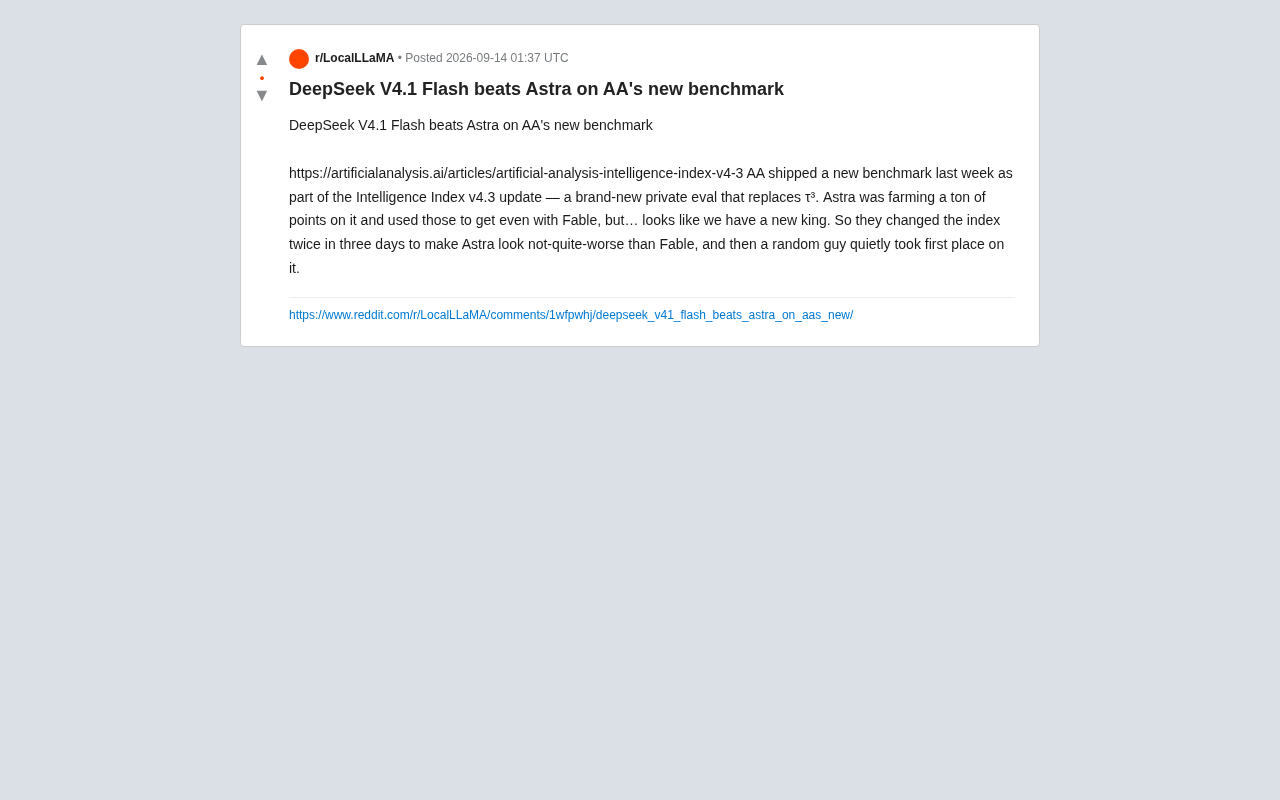
DeepSeek V4.1 Flash登顶AA新基准,超越Astra引热议
DeepSeek V4.1 Flash在Artificial Analysis新推出的Intelligence Index v4.3私有基准上超越Astra登顶,同时引发社区对评测体系三天两改的争议讨论。
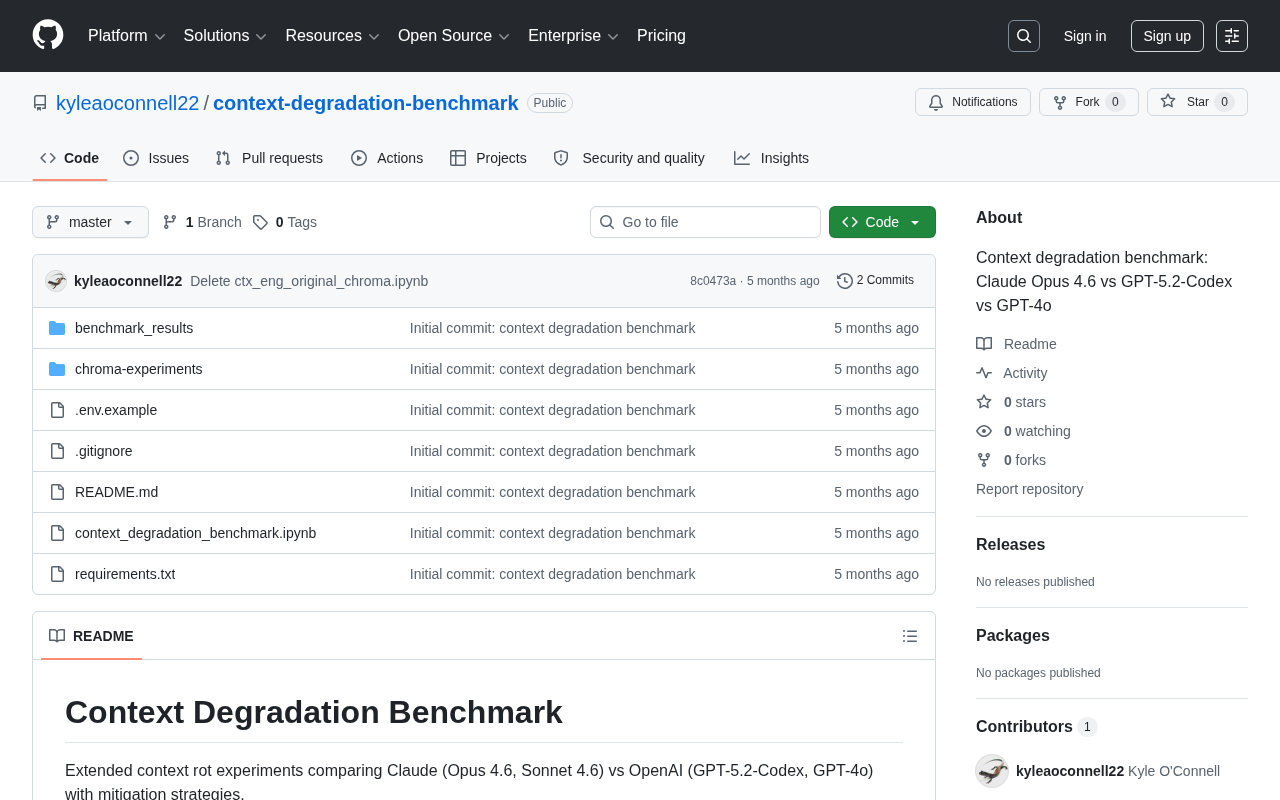
上下文退化基准测试:主流大模型的长文本短板
开源项目 context-degradation-benchmark 对比 Claude Opus、GPT-Codex 与 GPT-4o 的长上下文退化表现,本文解读上下文退化现象及其对 RAG、代码助手等应用的实践影响。
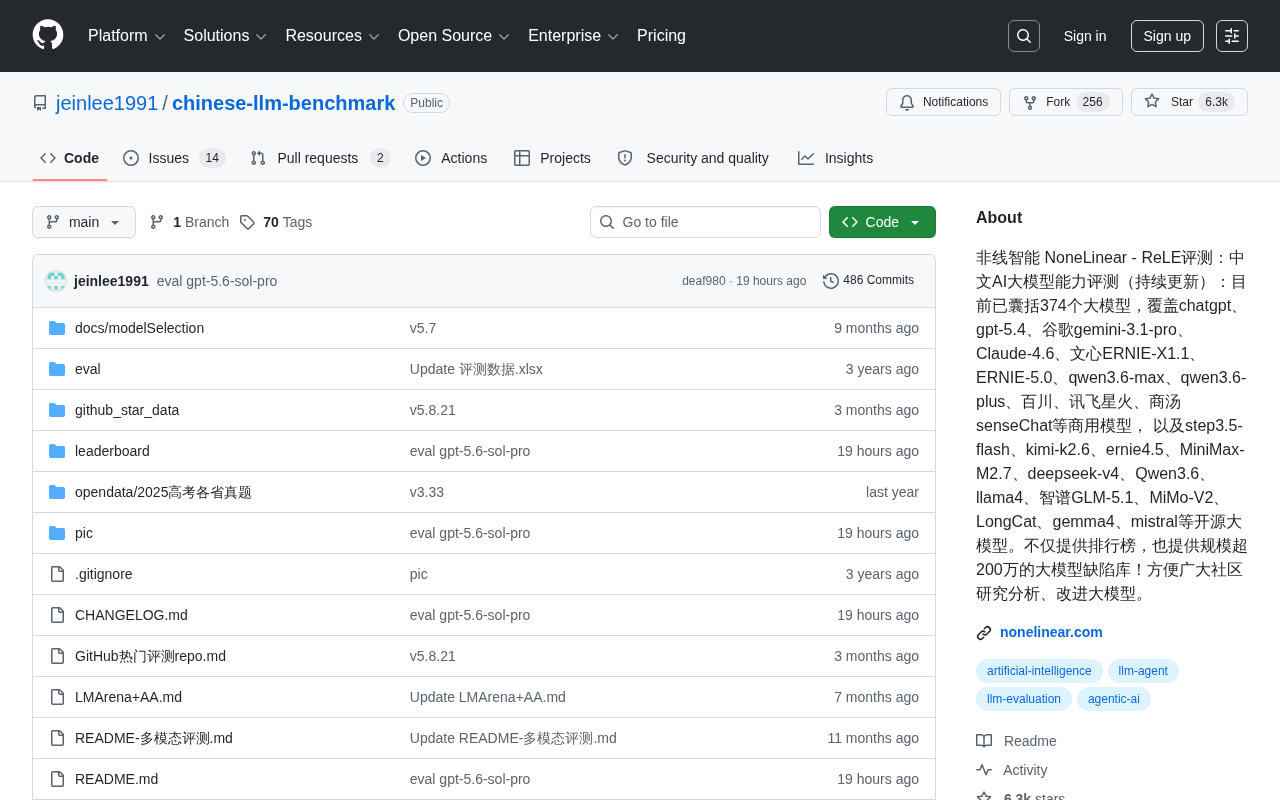
ReLE中文大模型评测:374个模型的能力排行榜与缺陷库
ReLE中文大模型评测项目已收录374个大模型,覆盖ChatGPT、Gemini、Claude、文心、通义千问、DeepSeek等商用与开源模型,并提供200万级缺陷库,是中文AI模型选型与研究的重要参考。
 科技前沿
GLM-5.2登顶全球开源模型榜首:前端编码能力领跑业界
智谱AI发布GLM-5.2模型,在Artificial Analysis Intelligence Index评测中登顶全球开放权重模型榜首,同时被评为顶级前端编码模型。深入解析GLM-5.2的突破性表现与开源模型竞争格局变化。
 产品体验
实测15款大模型开发B站首页:GPT登顶,国产模型差距明显
用同一套提示词让15款主流大模型一次性开发B站视频平台应用,实测ChatGPT、Claude、Gemini及国产模型的真实编程能力。详细对比前后端表现、指令遵循度与架构设计,附分层使用策略推荐。
 前沿研究
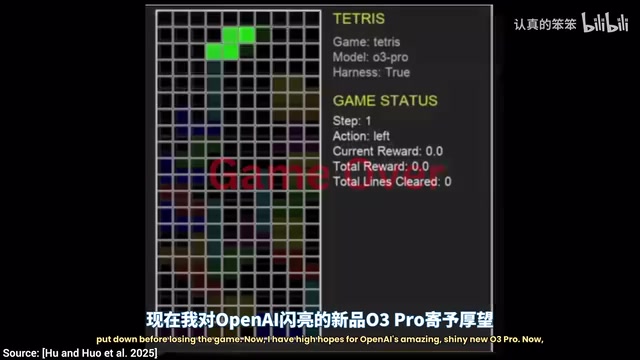
AI玩游戏实力大比拼:O3 Pro展现惊人规划能力
研究者用俄罗斯方块、超级马里奥、推箱子等经典游戏测试各大AI模型,O3 Pro展现出前所未有的规划能力,成为唯一通关全部关卡的模型。游戏测试揭示AI正从模式匹配向真正的战略思维演进。
 科技前沿
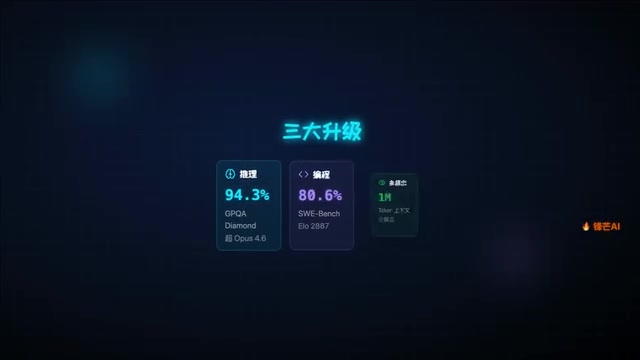
Gemini 3.1 Pro深度横评:ARC-AGI-2得分77.1%,真的最强吗?
Google Gemini 3.1 Pro发布,ARC-AGI-2抽象推理得分77.1%断档领先,GPQA Diamond 94.3%、编程ELO 2887多项登顶。本文从推理、编程、搜索等维度横向对比o4和GPT-5.2,揭示其真实实力与短板。
 产品体验
Gemini 3.5 Flash实测对比Qwen3.6:排行榜高分与真实体验差多远?
深度实测Gemini 3.5 Flash在UI生成、编程、Agent能力等维度的真实表现,与Qwen3.6-27B横向对比,揭示大模型排行榜分数与实际体验之间的落差,帮你理性选择AI模型。
 产品体验
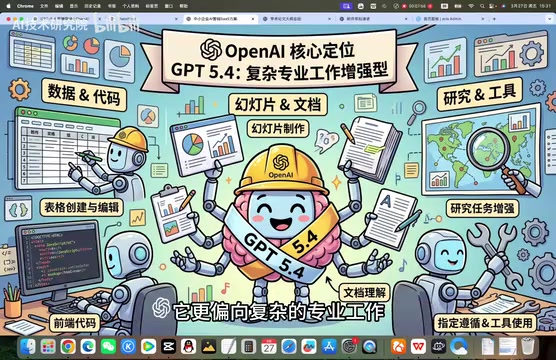
GPT-4 Thinking深度评测:编程、Agent与写作能力实测对比
深度评测GPT-4 Thinking模型在编程修Bug、AI Agent行业研究、学术论文写作等场景的实际表现,对比Gemini和Claude,解析其深度推理与结构化输出能力的核心优势。
 科技前沿
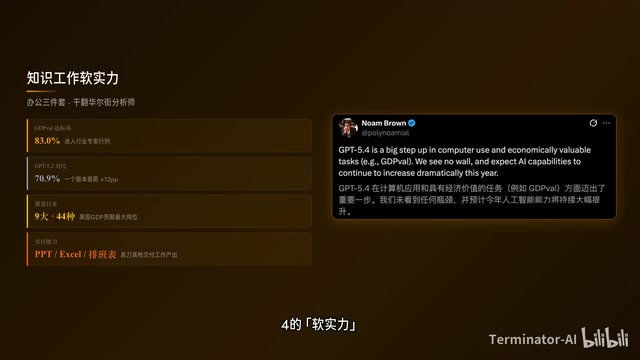
GPT-5.4深度评测:原生计算机使用、推理编程合体,OpenAI重回王座
GPT-5.4全面评测:OSWorld超越Claude Opus 4.6,原生计算机使用能力炸裂,推理编程合体Token效率提升50%,幻觉率暴降33%,搜索能力刷新纪录。OpenAI首个全能通用模型深度解析。
 科技前沿
Claude Opus 4.5工程测试碾压人类:AI编程能力全面超越顶尖工程师
Anthropic最新发布的Claude Opus 4.5在内部两小时工程考试中击败所有人类候选人,SWE-Bench得分创历史新高。深度解析Opus 4.5的基准测试表现、创造性问题解决能力、安全对齐突破及企业级应用场景。
 产品体验
GPT-5.2、Claude 4.5、Gemini 3 Pro实测对比:2025选购指南
2025年实测对比GPT-5.2、Claude Sonnet 4.5、Gemini 3 Pro、Grok 4.1四大AI模型,覆盖图像生成、深度研究、写作推理等核心场景,附各模型优劣势总结与低成本体验方案。
 产品体验
Claude Haiku 4.5前端实测:三分之一价格吊打GPT-5?
实测对比Claude Haiku 4.5、Sonnet 4.0、Gemini 2.5 Pro和GPT-5在SaaS落地页、3D魔方、天气动效三个前端场景的表现。Haiku 4.5仅三分之一价格,多数场景接近甚至超越旗舰模型。
 科技前沿
GPT 5.5 vs DeepSeek V4 实测对比:逻辑推理、前端生成、3D场景谁更强?
通过逻辑推理、前端页面生成、3D场景动画三项实战任务,深度对比GPT 5.5与DeepSeek V4的真实表现。涵盖生成速度、代码质量、视觉效果及性价比分析,帮你选出最适合的AI编程模型。