#开源工具
共 11995 篇相关文章

GitHub三周未下架恶意仿冒软件,开发者信任危机浮现
一位开发者举报GitHub上的恶意仿冒软件长达三周仍未被下架,事件登上Hacker News引发热议。本文剖析平台内容审核滞后的原因、对开源生态信任的冲击,以及开发者可采取的防护措施。

OpenTandem实测:手机远程操控Claude Code等AI编码工具
OpenTandem 让你在手机浏览器上远程操控电脑上运行的 Claude Code、Codex、OpenCode、Cursor 等 AI 编码工具,随时查看进度、切换模型、预览图片视频与 HTML 结果,告别 SSH 折腾。
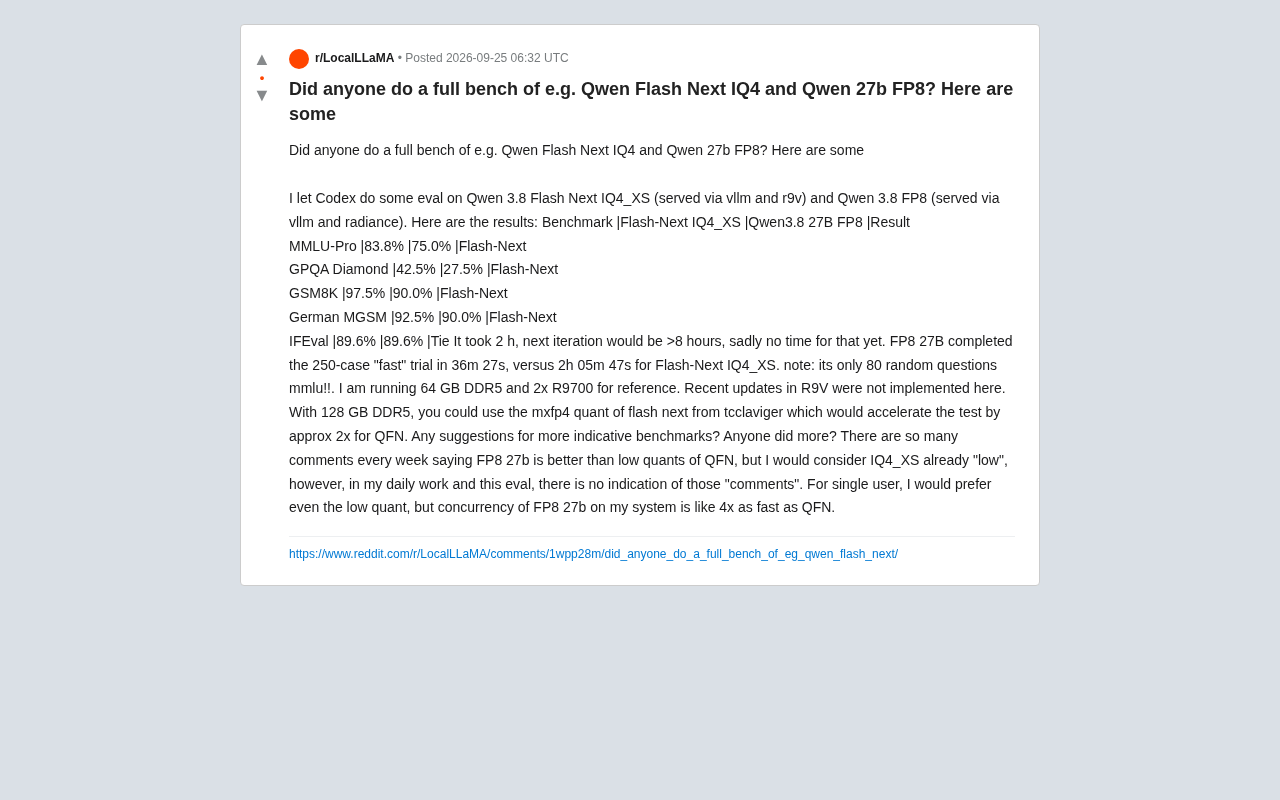
Qwen Flash Next IQ4量化实测:低量化真的不如FP8吗?
Reddit 用户实测 Qwen Flash Next IQ4_XS 与 Qwen3 27B FP8 的跑分对比,涵盖 MMLU-Pro、GPQA、GSM8K 等基准。结果显示低量化 Flash Next 精度反超 FP8,但 FP8 并发速度快约 4 倍。
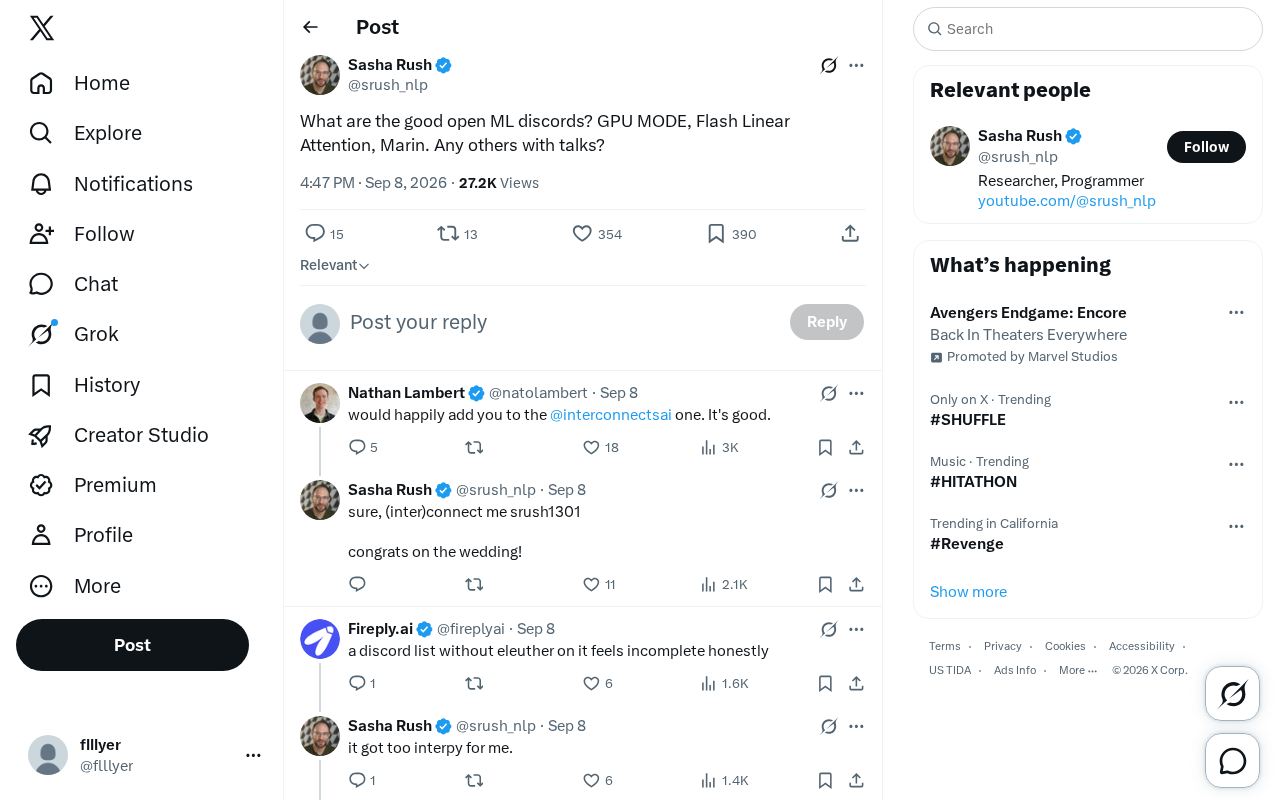
机器学习开源社区去哪找?盘点值得加入的技术Discord
盘点值得加入的开源机器学习 Discord 社区,包括 GPU MODE、Flash Linear Attention、Marin 等,解析各社区的技术侧重与选择方法,帮助 AI 从业者高效获取前沿知识。

用Lean形式化验证Transformer:从零证明模型不变量
Lean Verified Transformers 项目尝试用 Lean 定理证明器从零证明 Transformer 的一系列不变量,并探讨将形式化验证推广到更广泛代码的难度。本文解析其思路、Lean 的适用性及对 AI 可靠性的启示。
Jev:颠覆ChatGPT架构的超高速AI决策引擎
Jev是ChatGPT联合发明者推出的全新AI决策引擎,采用RLCD架构,速度最高达传统大模型200倍、成本仅400分之一,输出token免费且声称零幻觉。本文解析其定位、优劣势与实时Demo。

Whiteboard:为AI时代软件设计而生的开源IDE
Whiteboard是YC W26孵化的开源IDE,让人类与AI编码代理在共享画布上协同设计软件。它基于CodeOSS构建,提供AST语义diff、决策日志等功能,专为解决AI辅助开发时代的'认知负债'问题而生。

n8n实战工作坊:如何用低代码搭建真正可用的AI智能体
一场聚焦n8n实战的两天线上工作坊,教你零基础搭建面向真实工作流的AI智能体,涵盖AI Assistant、Skills新功能及自动化决策框架,由企业级AI公司CEO主讲。

Jev是什么?8个惊艳应用揭秘这款极速AI决策引擎
Jev是一款专注极速、廉价结构化决策的新型AI。本文解析Jev是什么、擅长与不擅长什么,并盘点AI垃圾检测、网页净化、邮件排序、动态建站、视频切片等8个惊艳实战应用。

上下文优化的隐藏风险:被丢弃的证据谁来测试?
上下文优化不只是压缩问题。本文剖析大模型 context 裁剪中的隐性风险——被丢弃的关键证据如何被平均指标掩盖,并介绍 Reef Infra 的实验闭环、选择策略与覆盖率测试思路。
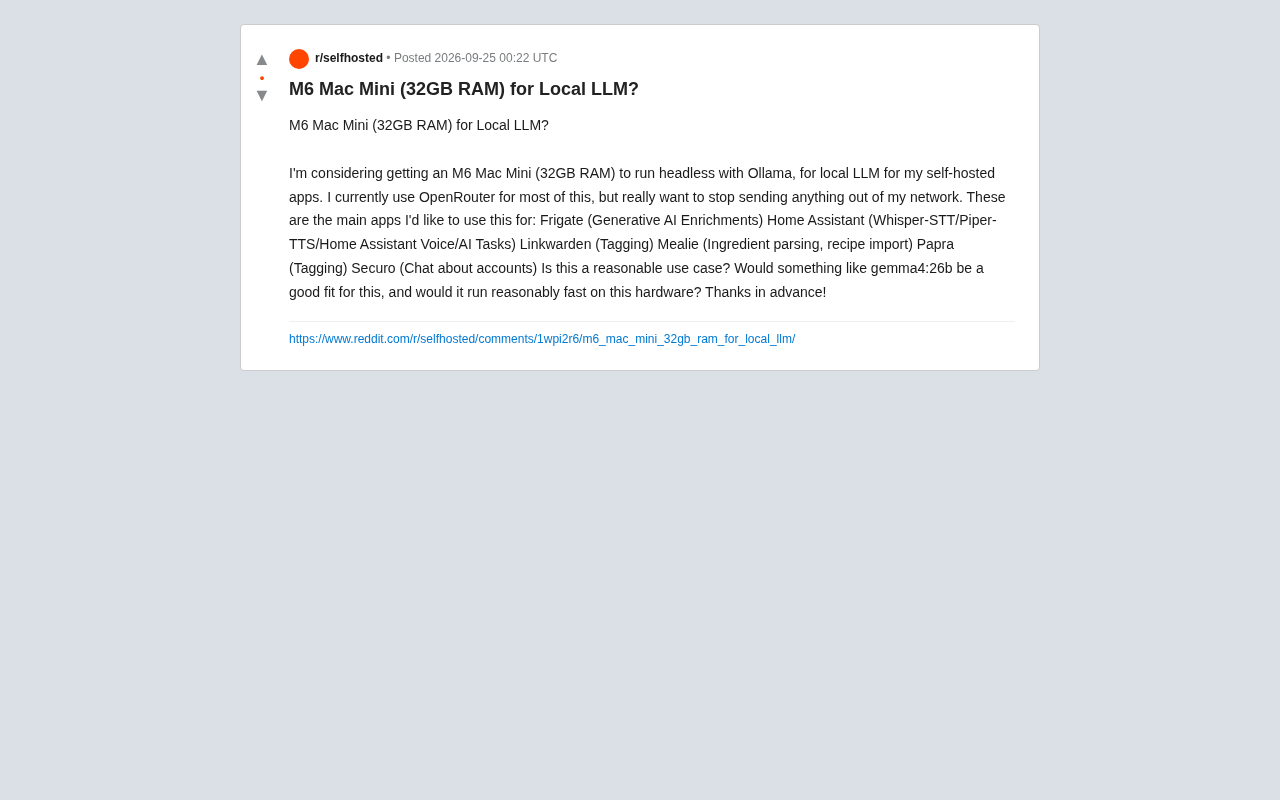
M6 Mac Mini 32GB 跑本地大模型:自托管场景实战分析
M6 Mac Mini 32GB 内存能否胜任本地大模型推理?本文结合 Home Assistant、Frigate、Ollama 等自托管场景,分析模型选型、内存占用与速度表现,帮你判断这套本地 LLM 方案是否合理。
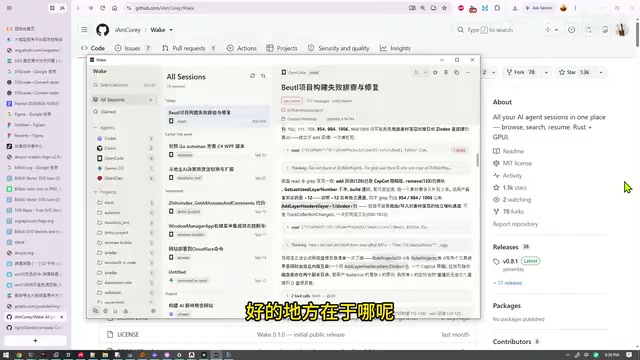
Wake:聚合Codex、Cursor等AI Agent历史会话的Rust单文件工具
Wake 是一款用 Rust 编写的单文件 AI 会话聚合工具,可统一管理电脑上 Codex、OpenCode、Cursor 等多个 AI Agent 的历史对话记录,体积仅约 81MB,轻巧快速、即开即用。

COILD:以印度语言为核心的机器翻译平行语料库与基准
COILD 是一个以印度语言为核心的平行语料库,包含超过116万条人工校验句对,覆盖20个印度语言对和四大语系,并配套2000句专家评测基准,为印度语言机器翻译与多语言大模型提供高质量训练与评估资源。

剖析大模型置信度:微调虚构语料检验"自信"是否等于"知道"
arXiv 发布开源工具包技术手册,通过在虚构加法语料上微调小型语言模型,直接检验"置信度是否等于知识"这一常见假设。文章解析其实验设计、token 长度校正与混杂因素排除等方法学细节。

模型压缩如何加剧Whisper语音识别的群体偏差
arXiv最新研究发现,Whisper语音识别模型经过剪枝和INT4量化等后训练压缩后,会显著加剧不同人群间的错误负担差异,黑人/非裔群体的时间税差距翻倍以上,而蒸馏则能缩小群体差距。全精度公平性审计无法反映部署时的真实偏差。

可解释仇恨言论检测:DistilBERT-BiLSTM-注意力框架解析
一项 arXiv 最新研究提出可解释的仇恨言论检测框架,融合 DistilBERT、Bi-LSTM 与注意力机制,并用 LIME 解释预测,在二分类与多分类任务上 F1 分数最高达 99.53%,为内容审核系统提供准确且透明的解决方案。

AI审计90万条法国新闻标题:措辞与选择如何双重塑造舆论框架
一项 arXiv 最新研究用 LLM 对 90 万条法国新闻标题进行大规模审计,提出显著性框架与选择性框架的二维分析法,揭示媒体措辞与选题如何双重塑造舆论,并警示分类阈值失真与群体提及的不平等语境。

训练世界模型的"物体恒存性":WROP数据集与PWM模型解析
arXiv 新论文提出 WROP 数据集与 16B 世界模型 PWM-WROP,探讨视频生成模型是否具备物体恒存性。文章解析其认知科学数据设计、Elo 盲测排名及完全开源的训练栈,适合关注世界模型与物理智能的研究者。

