#本地部署
共 437 篇相关文章
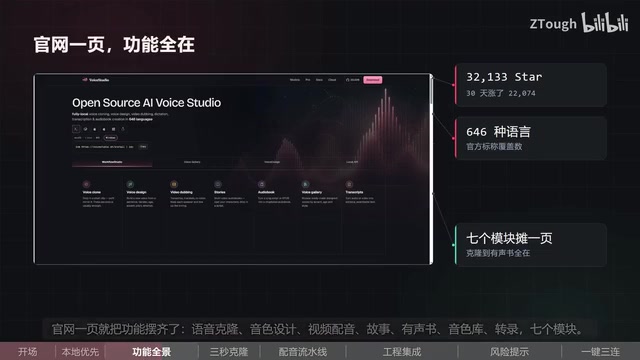
OmniVoice Studio:3秒克隆声音的全本地开源语音工作室
OmniVoice Studio 是一款全本地运行的开源语音工作室,3秒即可克隆声音、免API Key、支持646种语言,集成语音克隆、视频配音、有声书等七大模块,30天狂揽2.2万Star。本文详解其功能、配音流水线与硬件限制。
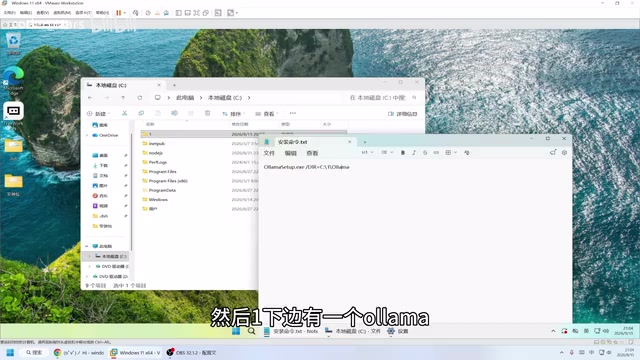
Ollama 换盘安装指南:告别默认C盘占用
Ollama 默认安装到 C 盘怎么办?本文详解通过命令行参数指定安装路径、配置环境变量实现命令全局调用,以及用 where 命令定位软件安装位置的完整方法,适用于 Windows 10/11。
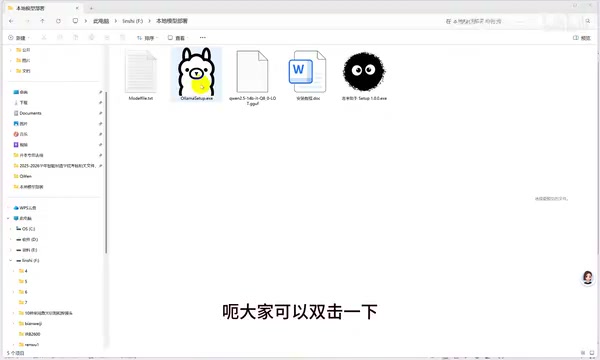
本地部署大模型完全教程:Ollama+Qwen 隐私免费方案
手把手教你在本地免费部署大模型:通过 Ollama 运行引擎加载 Qwen 通义千问开源模型,搭配图形客户端实现类豆包体验,数据不外泄、零费用,附完整安装步骤与硬件建议。

警惕AI教程套路:本地大模型部署的真相与误区
网络流传的"GPT-6本地免费使用教程"暗藏套路。本文拆解其命名造假、性能夸大等硬伤,并说明本地部署开源大模型的真实可行路径与风险防范。

警惕"GPT-6免费使用"骗局:本地部署AI的真相
网传《GPT-6 Astra国内免费使用教程》宣称旧电脑也能跑满血AI,本文从产品事实与技术常识拆解其中漏洞,揭示"免费大模型"引流套路,并给出理性本地部署AI的正确方式。

本地部署AI大模型:轻薄本也能跑的可行性分析
针对网络流传的“轻薄本本地部署满血AI”教程,本文从量化技术、模型规模、安全风险等角度理性分析其可行性与陷阱,并给出正规的本地大模型部署建议。
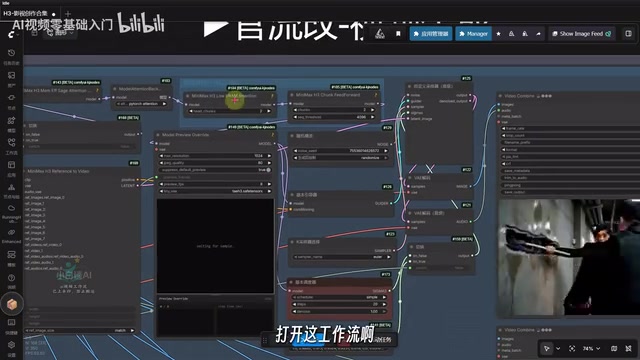
16GB显存跑27B大模型:Qwen3与MiniMax H3本地视频生成实测
实测16GB显存跑27B开源大模型:结合Qwen3与MiniMax H3的ComfyUI工作流集合,涵盖文生图、图像编辑与视频生成,8GB显存起步即可本地部署,媲美付费闭源方案。
MiniMax开源视频模型本地部署:8G显存也能跑,速度惊人
MiniMax最新开源AI视频加速模型支持8G显存本地运行,生成速度极快。本文详解ComfyUI本地部署流程、模型文件存放路径、五种工作流选择及文生视频、图生视频实测效果。

本地大模型变笨了?揭开Q4量化陷阱与自测指南
本地大模型跑起来变笨?问题可能出在你从未主动选择的Q4量化版本。本文解析量化陷阱、KV cache影响与运行器差异,并给出五分钟自测指南,帮你分清是量化还是模型本身的问题。

本地大模型选型指南:Qwen与DeepSeek怎么选?
本地大模型选型极简指南:Qwen与DeepSeek如何选择、7B/14B参数与Q4量化含义、按显存对号入座下载合适尺寸,以及LM Studio、Cherry Studio等零代码部署工具推荐,助你断网也能流畅跑本地AI。
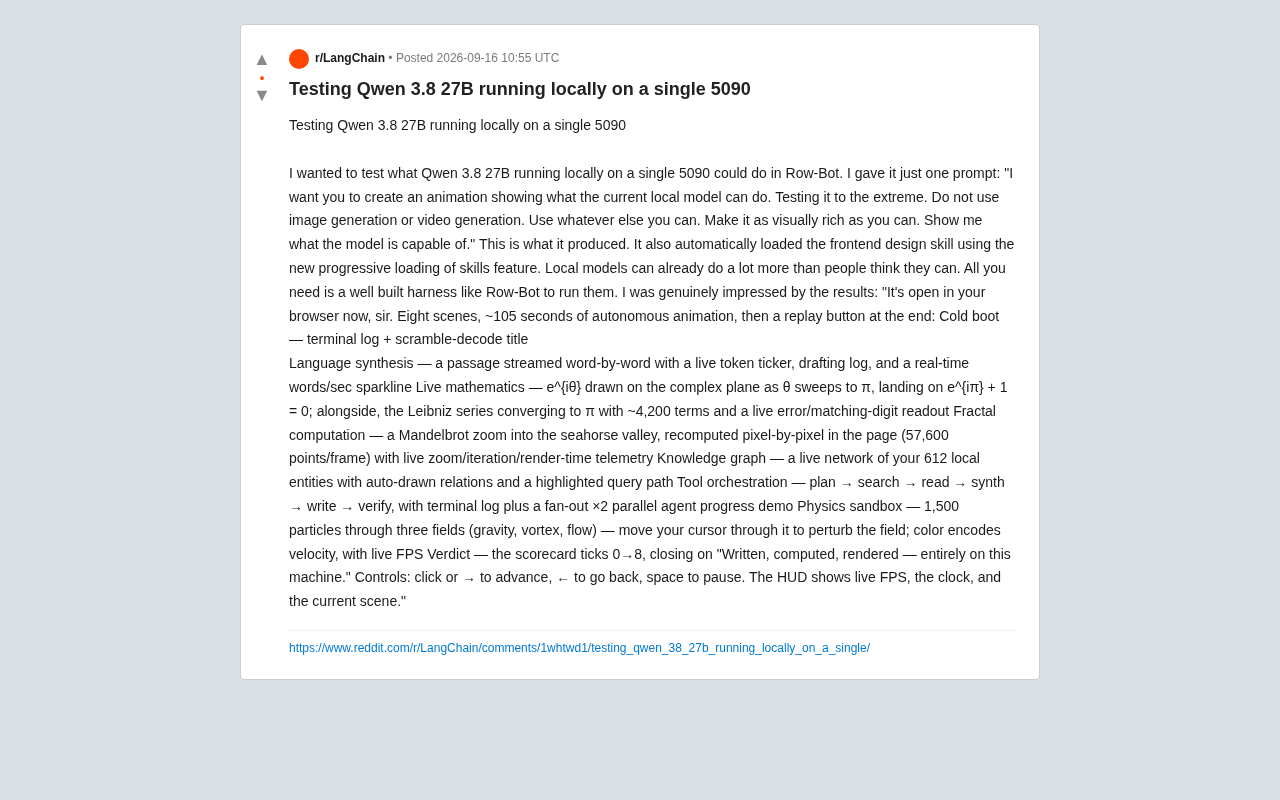
本地部署Qwen3 27B实测:单张5090能跑出什么效果?
开发者用单张RTX 5090本地运行Qwen3 27B模型,通过Row-Bot框架仅凭一条提示词生成了包含8个场景、105秒的交互式动画,涵盖实时数学、分形计算、物理沙盒等。实测揭示本地中型模型的真实能力与Agent框架的关键作用。

Qwen 3.8 27B本地大模型实测:小体积如何逼近顶级闭源模型
Qwen 3.8 27B开源模型实测:仅17GB即可在家用硬件本地运行,在部分基准挑战Opus 4.6 Max等顶级模型。本文结合发票生成、待办应用两组实测与Hacker News社区反馈,剖析其惊艳输出与过度思考的短板。

DeepSeek+RAGFlow本地部署个人知识库完整教程
详解如何用 Ollama 本地部署 DeepSeek 大模型,并通过 Docker 部署 RAGFlow 构建个人知识库。涵盖 RAG 技术原理、Embedding 作用、环境变量配置、完整部署三步流程及在线模型简化方案,小白也能上手。

Ollama 是什么?本地部署开源大模型的入门指南
Ollama 是一个开源免费的大语言模型管理平台,支持在 macOS、Windows、Linux、Docker 上本地部署 DeepSeek 等开源模型。本文讲解 Ollama 是什么、如何降低部署门槛、CPU/GPU 混合利用及私有知识库等应用场景。

NVIDIA DGX Spark 实战:Ollama 本地模型部署与对接教程
NVIDIA DGX Spark 实战教程:手把手教你安装 Ollama、下载本地大模型(如通义千问 3.5 9B),并对接自动化工具执行任务。含 -V1 接口配置等关键避坑细节。
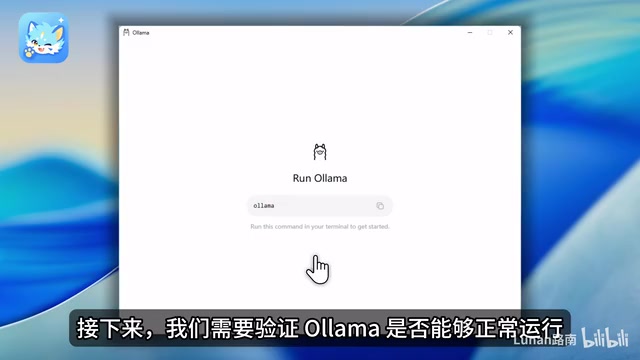
Ollama + Chatbox 教程:把大模型装进自己的电脑
手把手教你用 Ollama 部署本地大模型,再用 Chatbox 套上图形聊天界面。从环境安装、模型筛选到本地对话全流程详解,让 AI 完全跑在自己的电脑上,兼顾隐私与零成本。

本地模型别乱下:用llmfit先筛后测的完整流程
本地大模型选型难?llmfit(LMF8)1.1.15 版把盲选变成先筛后测:读取硬件、按真实任务筛出三个候选、反向规划硬件缺口、再用真实代码任务实测速度与准确率。附与 Ollama、LM Studio 的配合建议。

Ollama本地部署大模型全攻略:零成本实现Token自由
Ollama本地部署大模型完整教程:从安装、模型选型到OpenAI API调用一次讲清。零成本、数据不外传、离线可用,Windows/Mac/Linux全平台支持,附新手避坑指南。
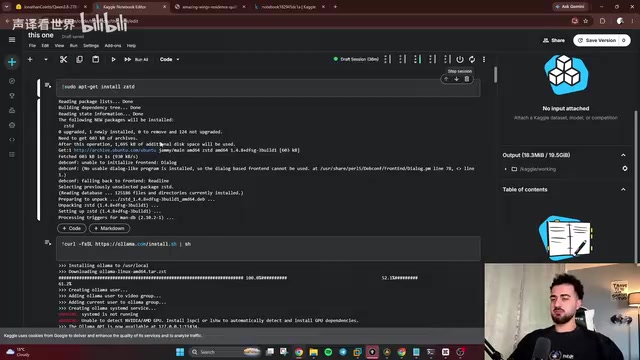
白嫖Kaggle 32GB显存GPU:免费运行本地AI模型全教程
手把手教你白嫖Kaggle的双T4 GPU(32GB显存),通过Ollama部署本地AI模型,再用Cloudflare隧道打通外网,接入Hermes Agent等客户端。完全免费,每周30小时额度,适合无高端显卡用户体验本地大模型。
Ollama 入门指南:本地部署开源大模型的利器
Ollama 是一款免费开源的本地大模型管理工具,支持将 DeepSeek 等开源模型部署到本地。本文介绍 Ollama 是什么、跨平台特性、CPU/GPU 支持及本地部署的应用场景,适合零基础入门 AI 大模型开发。