#本地部署
共 439 篇相关文章

本地16GB跑赢云端:开源模型Laya速度碾压Jev引热议
开源权重模型 Laya 在 16GB MacBook Air 本地运行,玩 Tetris 决策速度比云端 Jev 快 11 倍。本文解析本地推理为何能在延迟敏感任务中击败云端大模型,以及端侧 AI 的现实意义与局限。

Qwen3.8-27B本地部署全攻略:8G显存也能跑的AI视频神器
阿里 Qwen3.8-27B 开源模型本地部署教程:8G/6G 显存也能运行,通过 LM Studio 部署并接入 ComfyUI 视频生成工作流,附量化版本选择建议,AI 视频创作者福音。
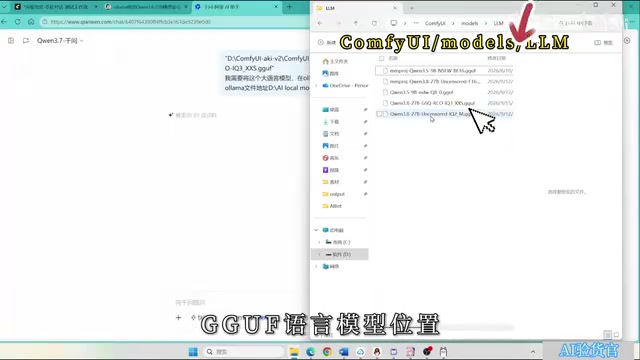
本地GGUF模型导入Ollama:复用ComfyUI模型免重复下载
已经在 ComfyUI 下载了 GGUF 大语言模型,却在 Ollama 重复下载?本教程手把手教你通过 Modelfile 将本地 GGUF 模型导入 Ollama,实现模型共享,免除重复下载和下载失败的烦恼。

LangChain文档为何劝退新手?本地模型与产品推广之痛
一位初学者吐槽 LangChain 文档对新手极不友好:本地模型(Ollama、llama.cpp)集成信息难找、LangSmith 产品推广充斥入门页、示例过度依赖云端 API。本文剖析这些痛点背后的开源文档维护困境。

本地部署AI大模型:低显存电脑跑大模型的可行性辨析
网传低显存电脑免费跑「GPT-6」「Gemini 3.8」教程是否可信?本文辨析本地部署大模型的量化技术真相,拆解「满血AI」「留言领工具包」等营销话术,并给出正确的本地AI部署方法。

ROCmFix与InferBench:AMD显卡本地大模型部署实测
ROCmFix 与 InferBench 项目聚焦 AMD 显卡本地大模型部署,简化 ROCm 环境配置并对比 Vulkan 与 HIP 两种推理后端的性能差异,为本地 LLM 用户提供实用参考。
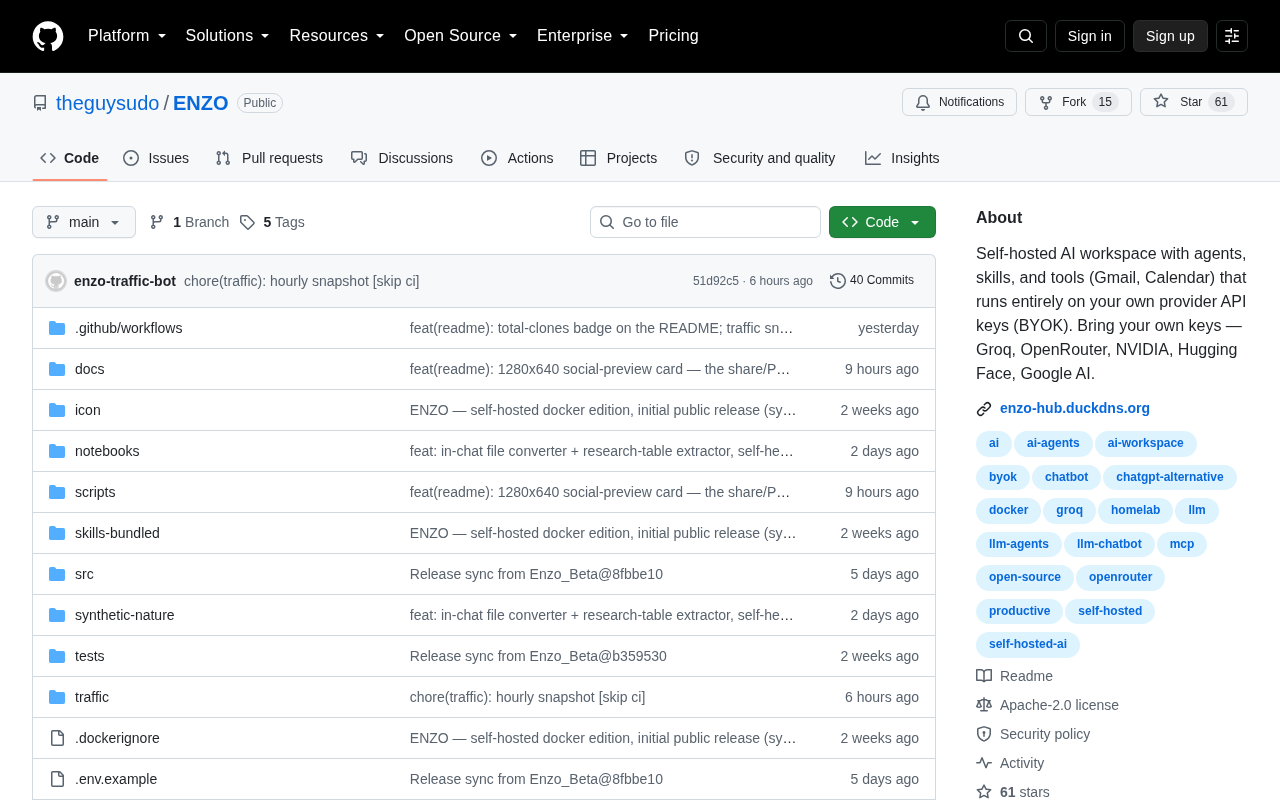
开源本地AI平台亮相Show HN:数据自主的新选择
一位开发者在Hacker News发布开源、可本地运行的完整AI平台。本文分析本地部署AI在数据隐私、成本可控与开源自由方面的价值,以及早期项目需要关注的现实问题。

MiniCPM 2B小钢炮本地部署与Agent工具调用实战教程
面壁智能MiniCPM 2B小钢炮开源模型本地部署完整教程,通过LM Studio加载GGUF量化版本,仅需4G显存即可运行,并接入DeepSeek Hermes实现工具调用、文档翻译与联网搜索,附详细配置步骤与实测能力分析。

512GB DDR5内存仅16瓦功耗:本地大模型的想象空间
一张512GB DDR5内存仅16瓦功耗的截图在Reddit引发热议。本文解析大容量低功耗内存对本地AI大模型的意义,以及价格为何仍是普通用户的最大门槛。
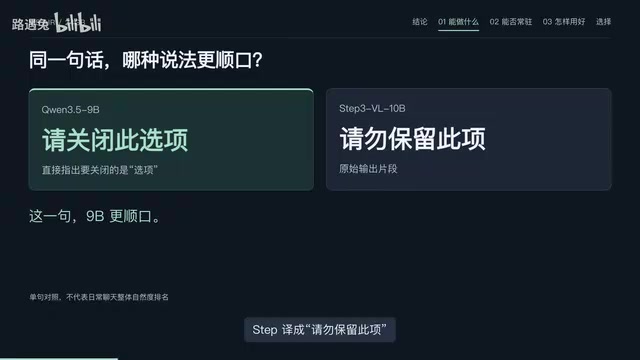
24GB MacBook Air 跑本地 AI:为什么我选 Qwen 9B?
在 24GB M5 MacBook Air 上跑本地大模型,为什么选千问 3.5 的 9B?实测对比内存占用、翻译自然度、看图能力与工作流配置,给出务实的本地 AI 选型建议。

KoboldCpp能取代Ollama吗?本地AI工具控制权深度对比
KoboldCpp与Ollama都基于llama.cpp引擎,本文深度对比两者在控制权、性能默认设置、context shifting及独有功能上的差异,帮你判断本地运行AI大模型该选哪个工具。
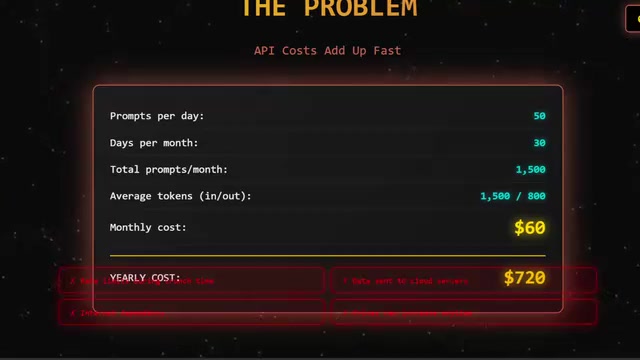
Qwen 27B 本地部署实测:开源大模型能否替代 GPT-4?
Qwen 27B 开源大模型本地部署实测:一条命令用 Ollama 安装,混合注意力支持 262K 长上下文,代码审计任务响应快于 GPT-4,三年成本对比显示本地方案更省钱。开发者本地 AI 部署完整指南。
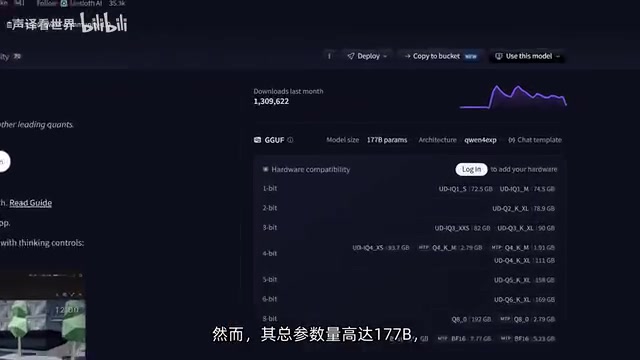
177B大模型跑在廉价显卡上?Qwen3 Flash Next本地部署实测
B站UP主实测用两块廉价显卡加32GB内存本地运行177B参数的Qwen3 Flash Next模型,通过将51B Ngram表卸载到SSD,实现22 tokens/s推理速度。本文解析其架构拆分、llama.cpp部署参数与性能表现。

本地大模型运行器怎么选?五大工具横评指南
llama.cpp、Ollama、LM Studio、vLLM 和 Lemonade Server 五大本地大模型运行器全面对比。搞懂模型文件、量化和显存三个概念,按硬件和场景选对工具,附完整决策路径。

Ollama+Cline本地部署Qwen3编码模型全教程
本教程详解如何用Ollama、VSCode与Cline在本地免费部署Qwen3编码大模型,涵盖硬件选型、模型下载、Context设置及MCP集成,实现无限制、高隐私的本地AI编程。

LM Studio vs Ollama:本地AI运行器怎么选?
LM Studio 和 Ollama 是两大主流本地AI运行工具。本文从界面、性能、开发者集成、模型发现等维度对比二者差异,帮你根据新手或开发者需求选择合适的本地大模型运行方案。

768GB显存低于单张RTX 6000:多卡拼装本地大模型实录
一位极客用12张CMP170HX矿卡拼出768GB显存,成本低于单张RTX 6000 Pro,可本地运行GLM、Qwen、DeepSeek等主流大模型。本文解析这套多卡方案的配置、性能与本地部署的成本争议。
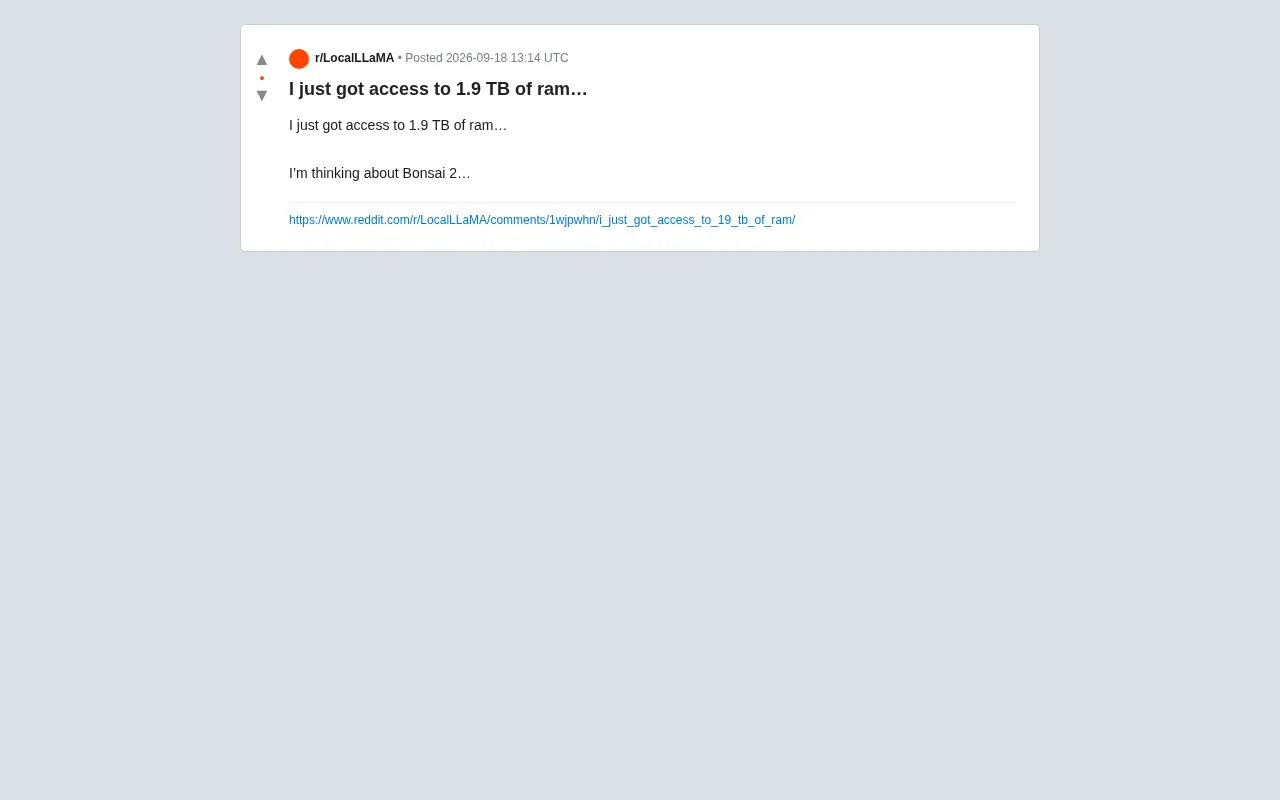
1.9TB内存能跑什么大模型?聊聊本地部署的算力天花板
一位Reddit用户获得1.9TB内存访问权限并计划运行大模型。本文从本地大模型部署角度,分析海量内存对运行超大参数模型的意义、内存推理的性能局限以及本地AI部署的现实门槛。

