#本地部署
共 439 篇相关文章
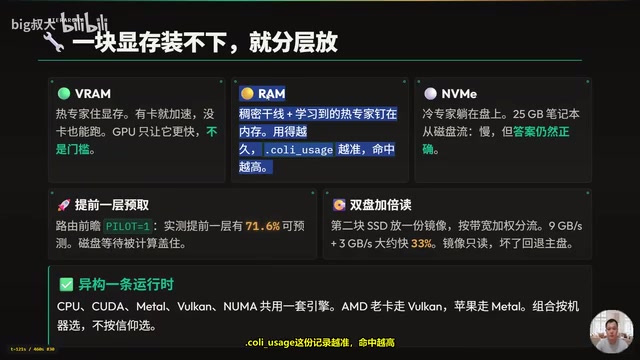
Colibri纯C引擎爆火:25GB内存跑744B大模型
开源项目Colibri(蜂鸟)纯C编写、零依赖,已获约3.6万星标,通过VRAM/内存/磁盘三级调度,让744B参数MoE大模型在25GB内存的消费级机器上流式运行,支持GLM、Kimi、DeepSeek等9大模型家族本地部署。
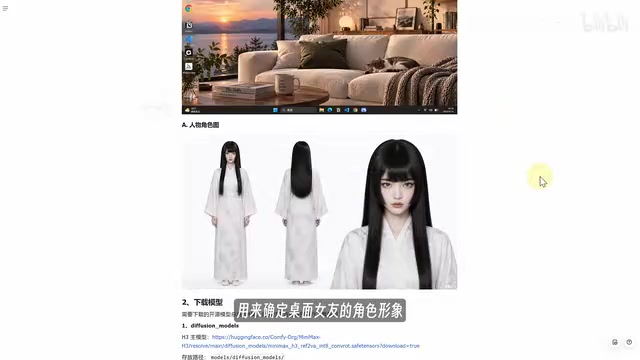
8G显存本地跑通MiniMax H3:ComfyUI整合包实测
MiniMax H3 海螺开源视频模型 8G 显存本地部署实测,基于秋叶 ComfyUI 整合包和 4步 Lora 提速,附四类模型下载、关键参数设置与效果分析,一键解压即用,免费无排队。

开源本地决策模型:比云端API快近20倍
开源本地决策模型Laya专注快速判断,实测速度比云端API快近20倍,延迟低至9毫秒,一条命令即可部署,数据不出本机,采用MIT协议免费开源,适合工单分类、流失预警等高频决策场景。
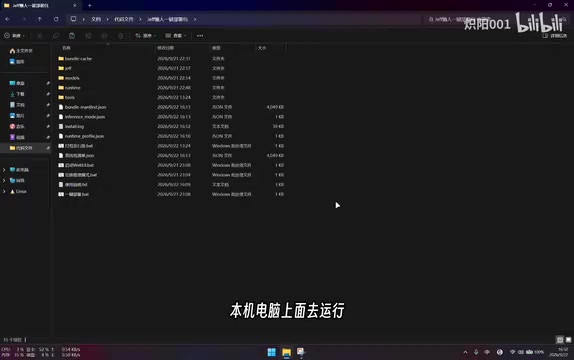
Jev模型开源平替:CPU/GPU本地一键部署实测
Jev(Jave)概率预测模型社区开源平替本地部署教程:支持 CPU/GPU 推理、离线运行、一键部署包安装流程与 Web UI 实测,并可通过 API 接入集成。
ComfyUI+Seedance本地部署AI漫剧:素材评估与避坑指南
本文解析一则以ComfyUI+Seedance本地部署AI漫剧为卖点的B站教程视频,剖析其本地智能体自动化工作流的真实内容、价值与局限,并给出面对此类引流教程的避坑建议。
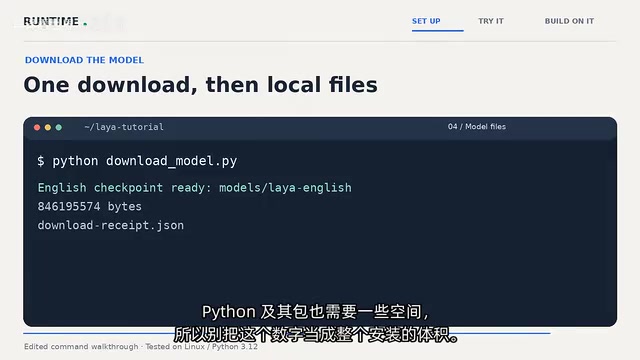
本地部署开源Laya实战:搭建环境并运行三个AI客服分类演示
开源项目 Laya 本地部署完整实战:从虚拟环境搭建、模型下载到三个客服文本分类演示,涵盖置信度阈值判断与接入本地大模型生成草稿回复,全程 CPU 运行无需 API 密钥。
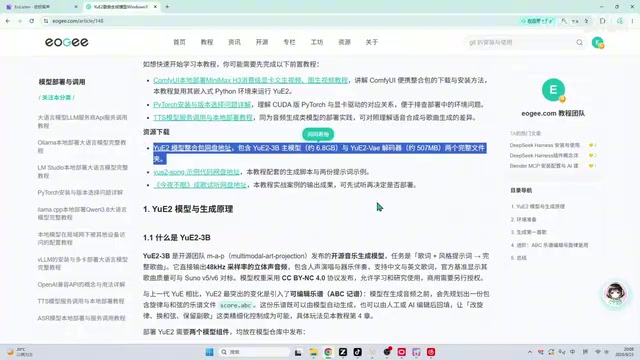
YuE2歌曲生成模型Windows本地部署完整教程
YuE2(月二)是香港团队推出的开源AI歌曲生成模型,对标Suno。本教程详解如何在Windows系统用ComfyUI便携版配合低显存消费级显卡(如2080Ti)本地部署YuE2,包含硬件要求、生成管线、冒烟测试及常见问题解答。
Qwen3 27B本地实测:小模型智能体能力反超Opus旗舰
海外博主深度实测Qwen3 27B本地开源模型,在SWE-bench Pro、OS World等智能体任务上反超Opus旗舰闭源模型。本文详解其架构特性、部署方案(Ollama/LM Studio)及与Hermes Agent组合的本地智能体栈搭建。
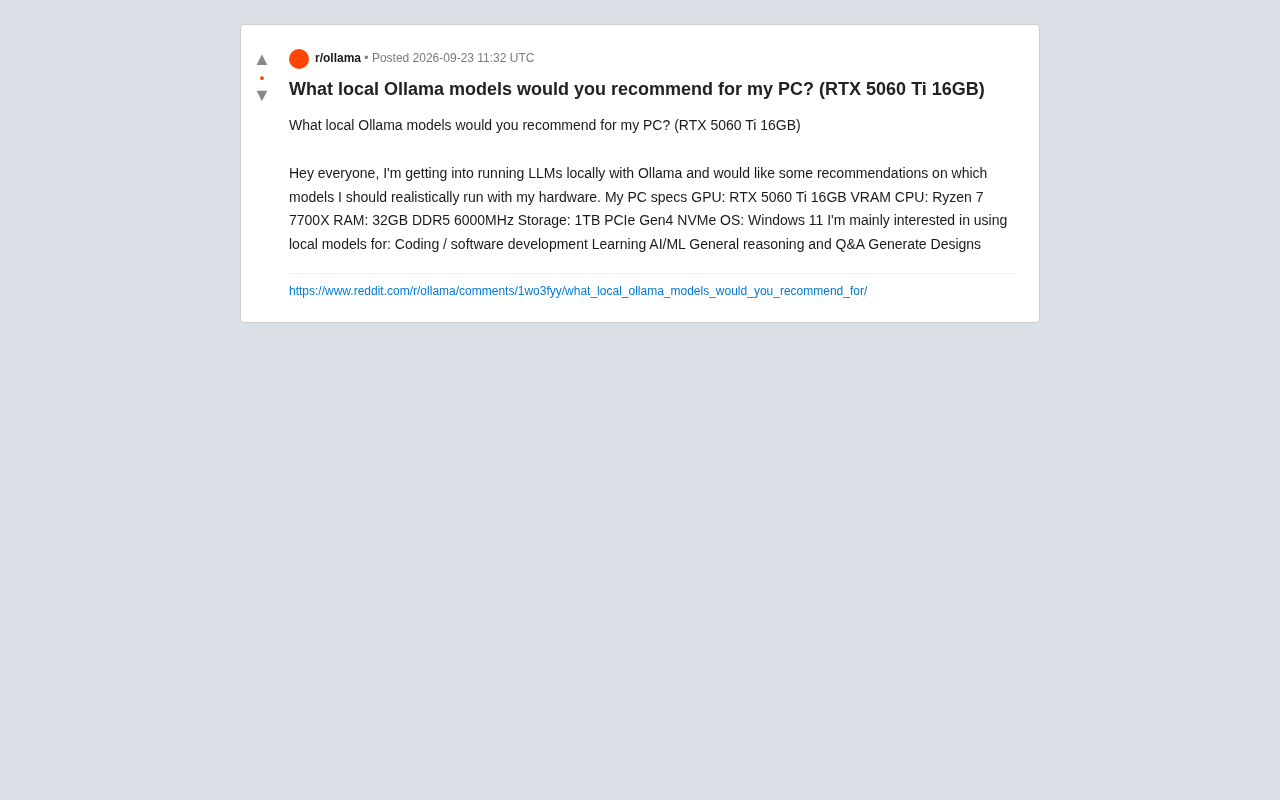
RTX 5060 Ti 16GB 本地 LLM 选型指南:Ollama 模型实测推荐
RTX 5060 Ti 16GB 显卡能跑哪些本地大模型?本文结合 Ollama 部署场景,从显存承载能力到编程、推理、设计生成的模型推荐,给出实用的本地 LLM 选型与调优指南。
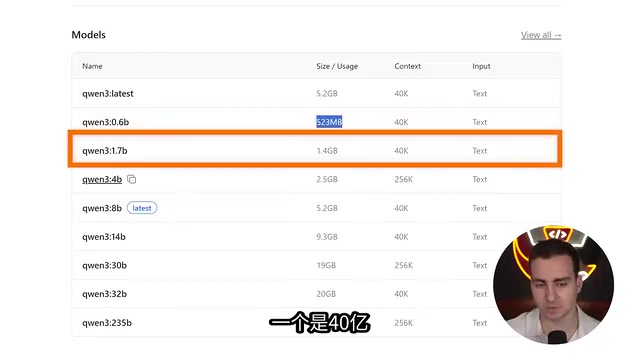
10分钟用Python搭建完全本地的AI智能体教程
本教程演示如何用 Ollama 和 Pydantic AI,几十行 Python 代码搭建完全本地运行的AI智能体,涵盖模型选择、工具函数定义和主循环编写,实现离线、免费、隐私安全的智能体应用。

M5 Ultra 512GB内存为何跑不快?带宽才是AI性能瓶颈
M5 Ultra 拥有 512GB 统一内存却只有 1.2TB/s 带宽,本文拆解为何内存带宽才是本地大模型推理的真正瓶颈,并对比 NVIDIA RTX Pro 6000,分析这台苹果 AI 神机的尴尬之处。

DGX Spark 对决 Mac Studio M5 Ultra:本地跑AI该选谁?
DGX Spark 与 Mac Studio M5 Ultra 谁更适合本地跑AI大模型?本文从内存带宽、Pre-Fill/Decode推理阶段、MoE模型、多机扩展与软硬件生态五个维度深度对比,帮你做出选择。
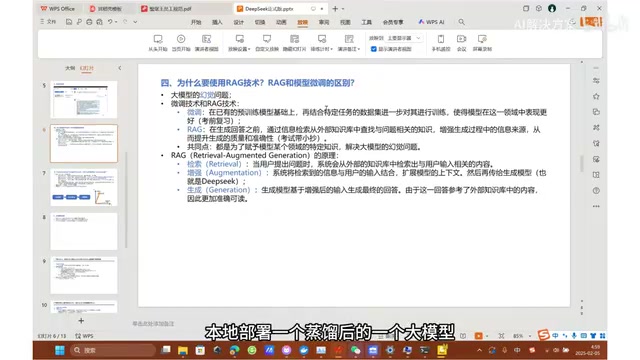
DeepSeek+RAGFlow本地部署个人知识库全流程教程
手把手教你用 Ollama+DeepSeek+RAGFlow 在本地部署个人知识库,涵盖 RAG 与 Embedding 原理、环境变量配置、Docker 部署及在线模型切换方案,零基础也能上手。
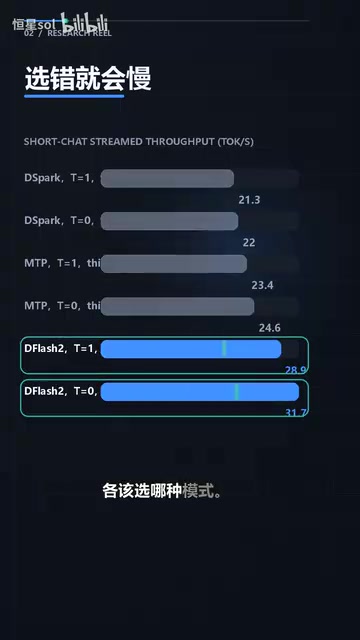
DGX Spark部署Qwen3 27B实测:三种模式怎么选
DGX Spark部署Qwen3 27B实测:D-Spark、MPP、D-Flash2三种模式在代码、短聊、长文场景下的吞吐对比。D-Spark代码51.5,D-Flash2长文25.4、16路并发总吞吐227.6,MIT开源可一行Curl调用。
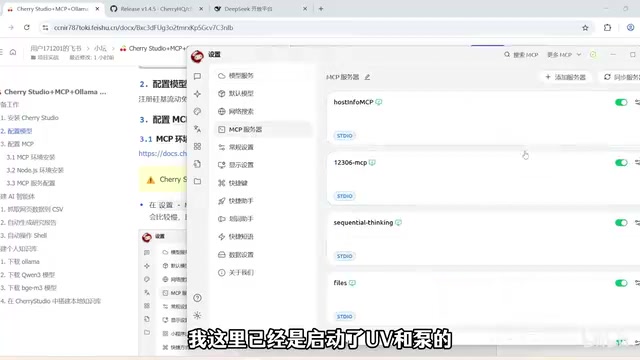
Cherry Studio + MCP 实战:搭建本地知识库与自动化AI智能体
本文详解如何用开源客户端 Cherry Studio 结合 MCP 协议和 Ollama,搭建自动化 AI 智能体与本地知识库,涵盖 DeepSeek 模型配置、UV/Bun 环境、Function Call 限制及网页抓取、Shell 控制等实战场景。

本地大模型改配置翻车?聊聊vLLM运维的真实门槛
一条Reddit梗图揭示本地LLM运维痛点:让大模型自动修改vLLM服务配置为何高风险?本文分析环境变量的静默失败问题,并给出验证、版本控制和功耗优化的实用建议。

Claude Code本地化部署指南:用本地模型跑CC省Token
Claude Code本地化部署入门指南:讲解如何将CC与本地大模型整合,实现离线运行、节省Token成本。涵盖模型体积与显卡显存的配套关系、量化模型优化及云服务器方案选择。

Unsloth新版发布:本地运行Qwen-Image-2.1并支持自定义Agent技能
Unsloth发布v0.1.813-beta版本,支持本地运行Qwen-Image-2.1图像生成模型,新增自定义Agent Skills技能机制,推理速度翻倍,并改进训练可靠性与Linux/ARM64/AMD硬件适配。

