#本地部署
共 439 篇相关文章
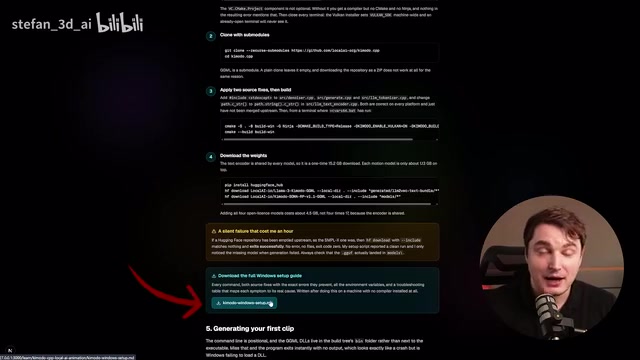
英伟达 Kimodo AI 动画生成器 CPU 本地部署完全指南
英伟达 Kimodo AI 动画生成器现已支持 CPU 及低显存本地部署。本文详解 Kimodo CPP 的硬件要求、Windows 安装流程、Soma/G1 骨架选择与授权、GLB 导出及导入 Unreal Engine 的完整方法。

本地AI小白部署指南:Gemma、LM Studio与Ollama实战
本地AI小白入门完整指南:从Gemma模型、LM Studio、Ollama到Hugging Face,讲清本地与云端AI的区别、核心术语、三条部署路径和硬件建议,并给出三个可落地的本地AI创业点子。

AI MAX+ 395部署Qwen3大模型:GFX1151引擎实测优化解析
B站UP主防暴键盘更新GFX1151 engine引擎,针对AMD AI MAX+ 395平台部署Qwen3大模型。本文解析MOE内核优化、HGN/GGUF双格式支持、分页KV与并发能力及本机实测数据。

显卡涨疯了怎么办?统一内存+独显异构加速部署大模型
RTX 5090和Pro 6000显卡价格翻倍,本地部署大模型成本飙升。本文解析统一内存+独显异构加速开源方案,拆解Prefill与Decode分工原理,实测三条路径数据,4万美元跑DeepSeek V4.1 Flash成本降至五分之一。
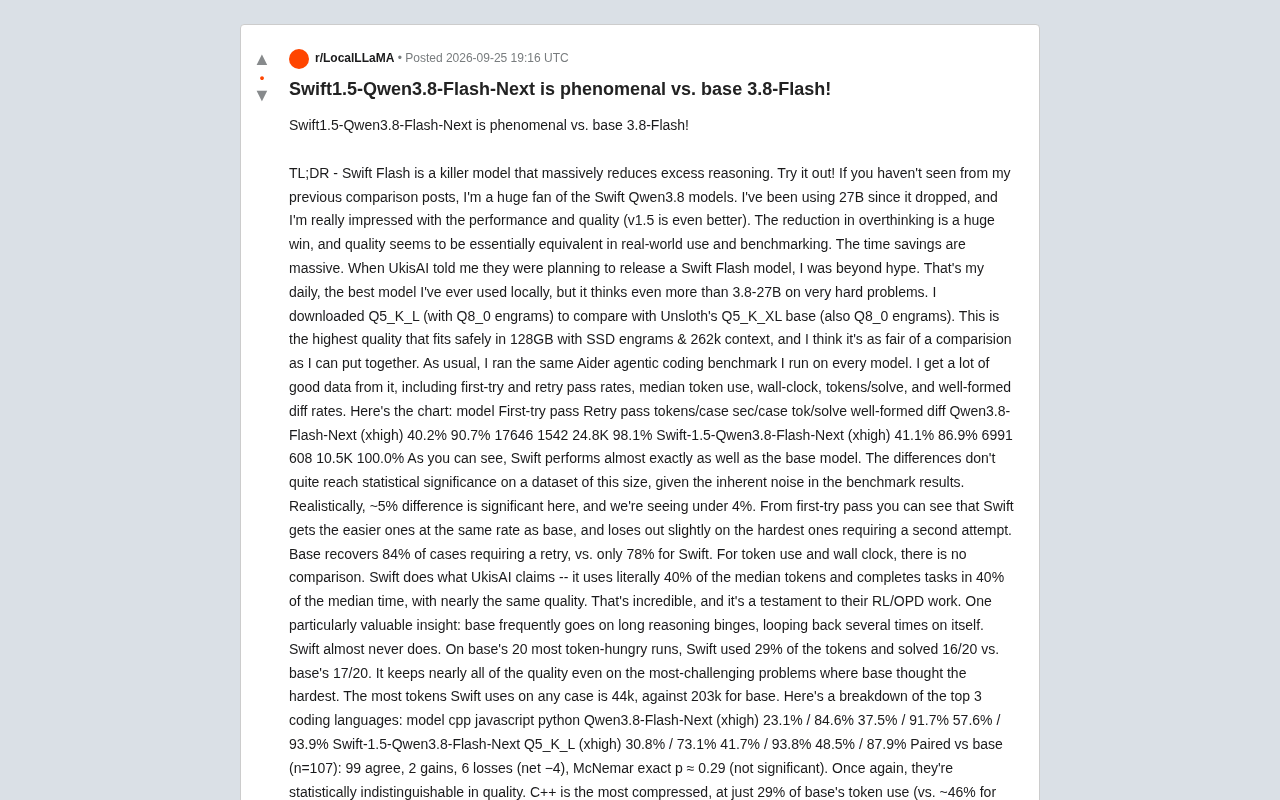
Swift1.5-Qwen3.8-Flash-Next实测:推理提速60%,质量几乎无损
Swift-1.5-Qwen3.8-Flash-Next实测对比基础版Qwen3.8-Flash:Aider编程基准显示其推理token和耗时降至40%,质量几乎无损,C++场景需留意。本地大模型效率优化实录。
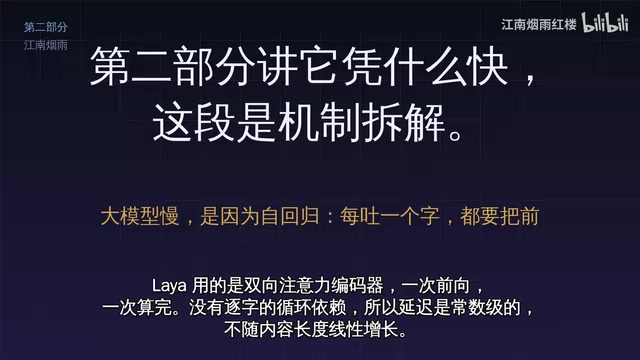
开源判断模型实测:为什么它中文只有20分却值得部署
开源判断模型实测:非自回归架构带来常数级延迟,中文仅20分却是速度与确定性利器。含小主机 OOM 排查、三档量化内存账、Cloudflare 边缘网关部署踩坑全记录。
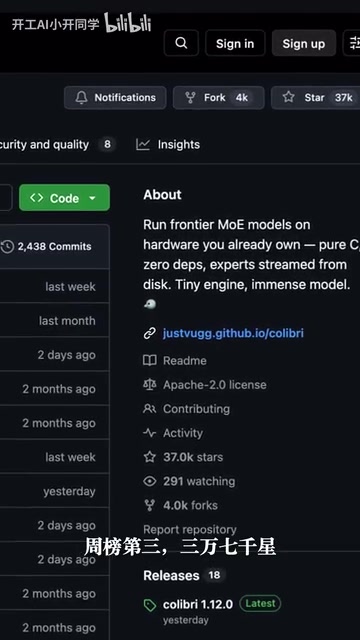
Colibri开源引擎:普通电脑也能跑2.8T大模型
开源推理引擎 Colibri 把硬盘当内存用,专家按需读取,让普通消费级电脑也能运行从 744B 到 2.8T 的大模型,支持 GLM、Kimi、DeepSeek 等九大家族,三条命令即可上手,Apache 2.0 开源。
Qwen3+RAGFlow零成本搭建本地知识库全流程教程
手把手教你用Ollama、Qwen3和RAGFlow零成本搭建本地知识库智能助手,从Docker环境配置、模型集成到向量检索全流程详解,消除大模型幻觉,数据隐私可控,小白也能上手。

MiniMax H3长视频工作流实测:6G显存跑2分钟高清动画
MiniMax H3长视频ComfyUI工作流实测分享:通过Motion Context机制突破15秒时长上限,配合分块处理和显存清理节点,让6G-12G低显存显卡也能本地生成2分钟高清动画,附操作流程与提示词技巧。

7000美元本地AI全套配置揭秘:硬件、模型与提速技巧
一位B站UP主分享其耗资7000美元搭建的本地AI全套配置:NVIDIA GB超级芯片硬件、Qwen/Nemotron模型选型、llama.cpp与vLLM推理引擎,以及量化、推测解码等提速技巧,实测大模型提速64%。

ADM本地大模型部署工具:一键启动开箱即用
ADM是一款支持Windows、Linux和macOS的开源本地大模型部署工具,主打一键部署、开箱即用、图形化界面,内置Agent可执行命令读写文件,支持60K上下文与MTP推测解码,数据全本地存储保护隐私。

本地部署Laya决策模型:45ms响应、零成本的开源替代方案
开源决策模型Laya本地部署实测:421MB模型体积、单次决策仅45ms、可跑60fps,对比云端Jev的300ms延迟优势明显。本文详解通过Panel AI一键部署Laya的完整流程与注意事项。
A卡+Win11本地部署MiniMax H3:文生图/图生图/多图生图实战教程
AMD显卡+Windows 11本地部署MiniMax H3完整教程,涵盖ComfyUI安装、文生图、图生图、多图生图三大功能实测与参数调优,附整合包使用与手动部署步骤,A卡AI绘图用户必看。

Ollaya:面向开源决策模型的Ollama式本地运行工具
Ollaya 是一个新兴开源项目,定位为“决策模型领域的 Ollama”,旨在简化 Jev 风格决策模型的本地运行。本文解析其定位、应用价值与当前局限。
Ollama本地大模型部署入门:中文手册助你少走弯路
不会安装 Ollama 本地大模型?本文介绍一份覆盖安装部署、模型下载、Modelfile 定制、OpenAI 兼容接口和 GGUF 量化的中文手册,帮新手和开发者快速上手本地大模型,少走弯路。
Ollama本地部署教程:加速下载与AI角色提示词实践
本地部署Ollama大模型完整教程:解决海外服务器下载缓慢问题,并分享一套前后台分离的AI角色扮演提示词设计思路,含DeepSeek实测效果与人设改写技巧。

NVIDIA PAIR:把家里闲置算力串成本地AI集群
NVIDIA PAIR 是一款免费软件,能把家中闲置电脑的算力整合成本地AI算力池,自动调度智能体任务,支持Apple设备,主打本地运行与隐私保护。
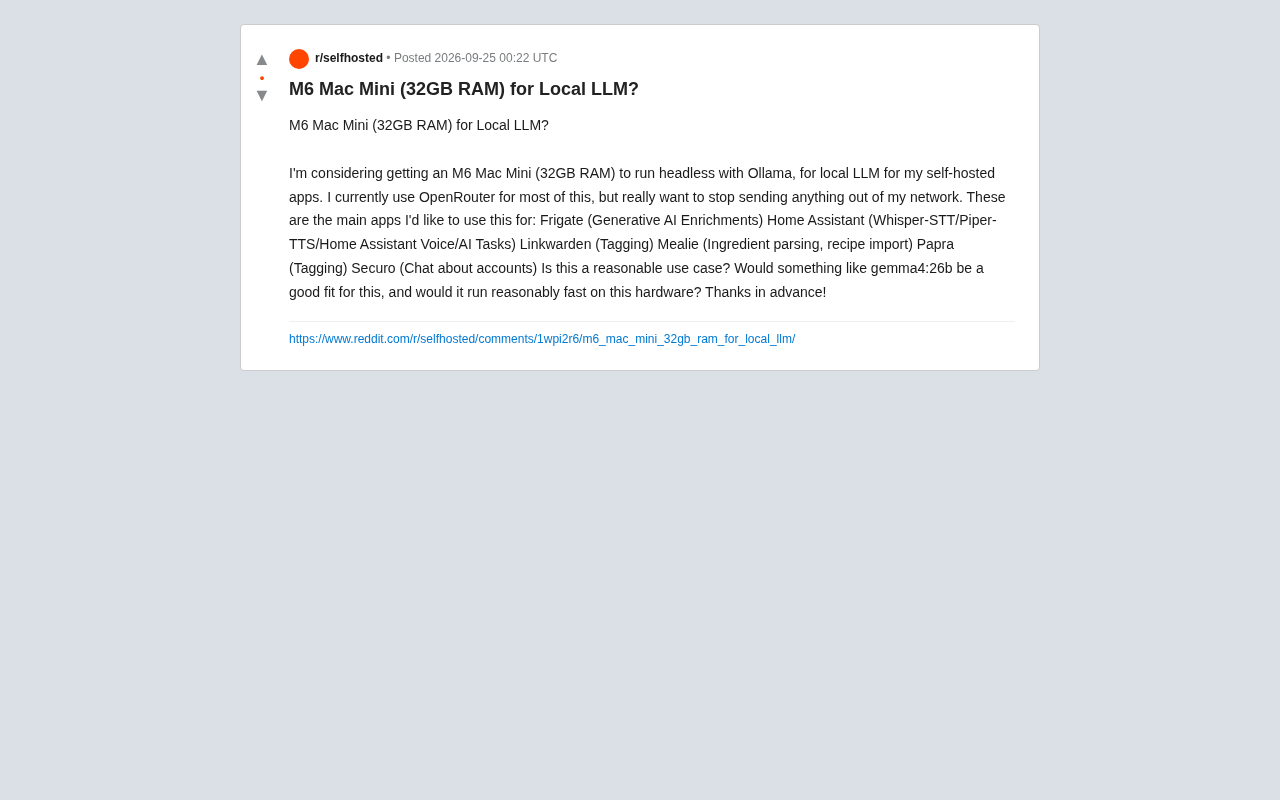
M6 Mac Mini 32GB 跑本地大模型:自托管场景实战分析
M6 Mac Mini 32GB 内存能否胜任本地大模型推理?本文结合 Home Assistant、Frigate、Ollama 等自托管场景,分析模型选型、内存占用与速度表现,帮你判断这套本地 LLM 方案是否合理。
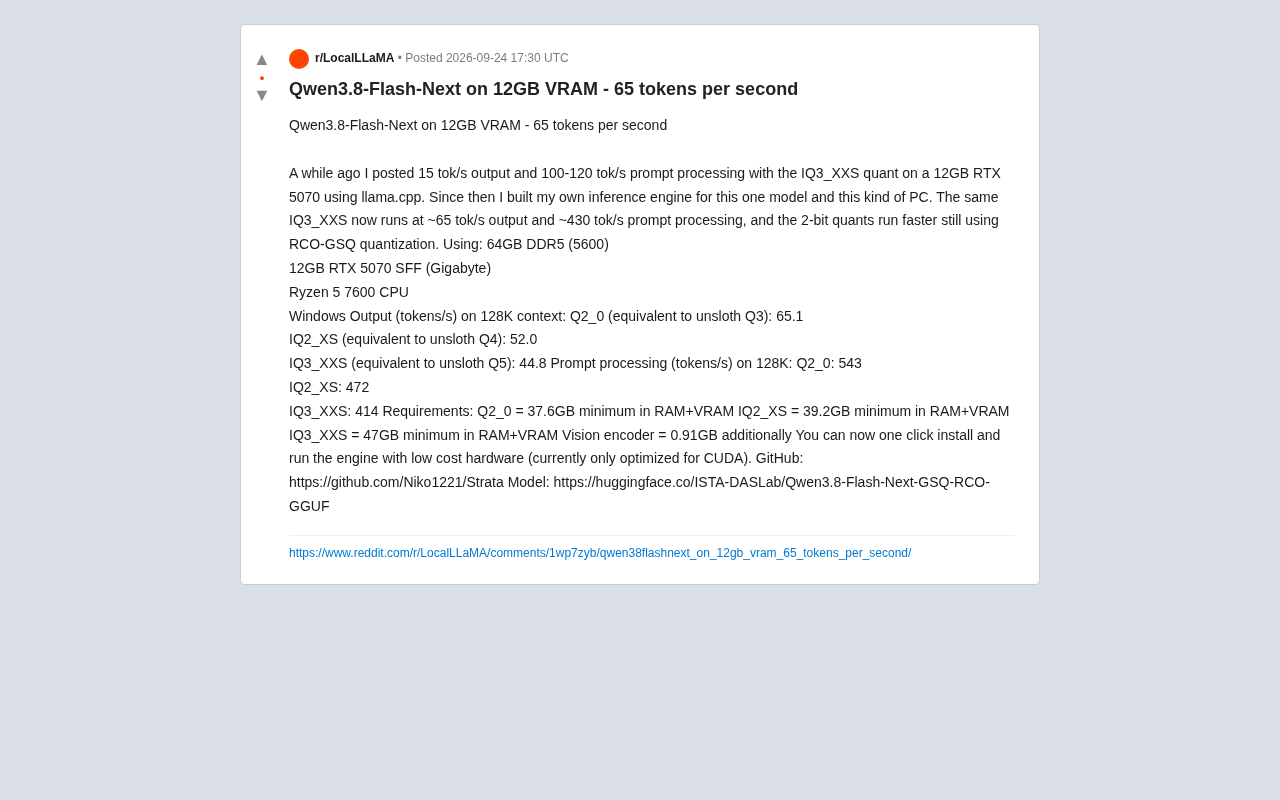
12GB显卡跑Qwen3.8-Flash-Next:自研引擎实现65 tok/s
开发者用自研Strata推理引擎在12GB RTX 5070上运行Qwen3.8-Flash-Next,输出速度达65 tok/s,比llama.cpp提升近4倍。附完整量化性能数据、硬件配置与开源地址。
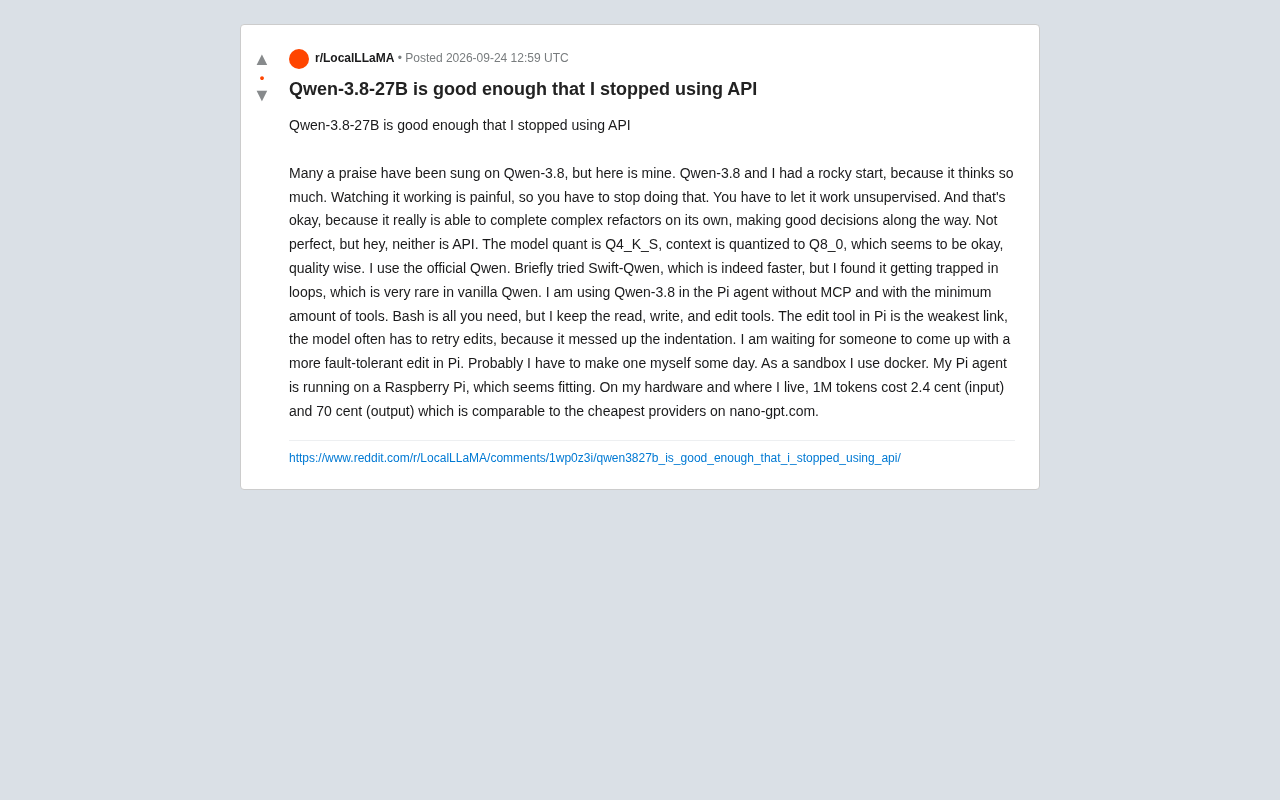
本地跑 Qwen-3.8-27B 替代 API:一位开发者的实战体验
一位 Reddit 开发者分享用本地 Qwen-3.8-27B 完全替代云端 API 的实战经验,涵盖 Q4_K_S 量化、Pi agent 极简工具链、树莓派部署与详细成本核算,探讨开源大模型「够用」的临界点。