#本地部署
共 439 篇相关文章
Ollama本地决策模型来了:Nimble如何实现实时任务路由
Ollama宣布支持本地运行的决策模型,并推出Nimble模型与全新/v1/systemone API,可用于工单分流、模型路由和内容审核等实时决策任务。本文解析其功能、应用场景与落地价值。

4张Tesla T4组建64GB本地AI推理主机实战解析
一位Reddit用户分享用4张Tesla T4显卡(共64GB显存)搭建本地AI推理主机的完整配置,涵盖硬件选型、llama.cpp+OpenWebUI软件栈,以及CPU并非推理瓶颈的实测经验。

本地跑AI每小时0.12欧,调用前沿模型API反而更划算?
本地跑大模型每小时电费仅0.12欧,是否意味着直接调用前沿模型API反而更贵?本文拆解每小时成本与每百万token成本的换算误区,分析硬件折旧、速度与质量等隐性成本,帮你算清本地推理与云端API的真实性价比。
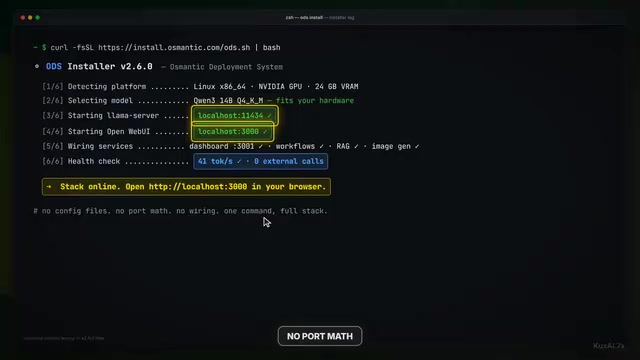
一条命令搭建本地AI服务器:ODS开源部署LLM/RAG/绘图全攻略
ODS(Osmatic部署系统)是一个Apache 2.0开源项目,一条命令即可在本地部署LLM推理、RAG、图像生成、语音智能体等完整AI技术栈,支持Linux/Windows/macOS。本文解析其功能、端口约定、可信度与实操建议。
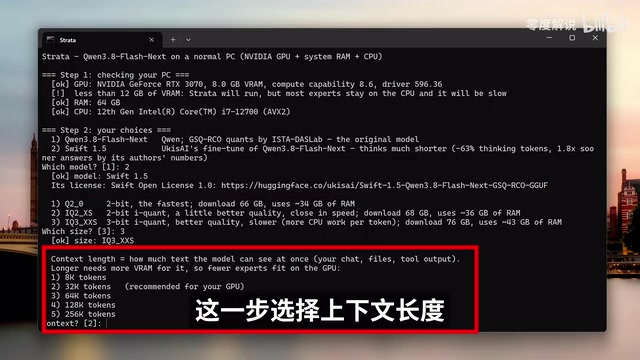
8G显存本地跑125B大模型:Qwen3.8-Flash-Next部署实测
零度解说实测开源项目在8G显存消费级显卡上本地运行125B参数的Qwen3.8-Flash-Next大模型,N卡A卡通用。涵盖量化部署流程、代码生成、多模态识别与Agent应用全过程。
带模型商店的AI硬件:本地大模型部署真能零门槛?
一位B站UP主分享带「模型商店」的本地AI硬件算力舱体验:一键部署语音转文字、图像识别、文生图等模型,设备显存与运行状态全透明,探讨本地大模型零门槛部署是否真能实现。

AI视频入门第一课:云端还是本地部署?成本速度质量全解析
同一条AI视频云端近100元、本地仅8毛,差距100多倍。本文解析2026年AI视频入门第一道选择题:云端还是本地部署,从成本、速度、质量三方面全面对比,附主流模型天梯图与新手/个人/团队选择建议。

Ollama入门指南:零基础本地部署开源大模型
Ollama 是一款开源免费的本地大模型管理工具,支持 Windows、Mac、Linux 和 Docker,可自动调度 GPU/CPU 资源,轻松部署 DeepSeek 等开源模型。本文带你零基础了解 Ollama 的核心功能与特点。
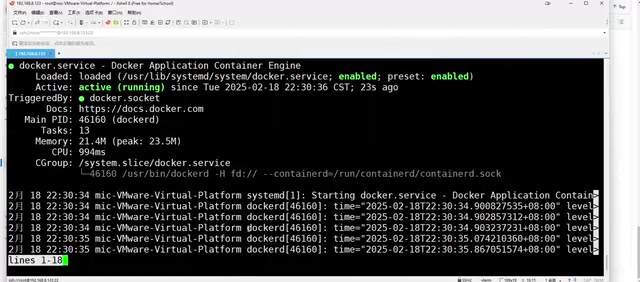
DeepSeek+Ollama+AnythingLLM本地RAG知识库部署全攻略
手把手教你用Ollama+AnythingLLM+DeepSeek在Ubuntu环境搭建本地私有RAG知识库,详解Docker部署、模型下载、远程访问配置及常见踩坑,打造专属行业大模型。
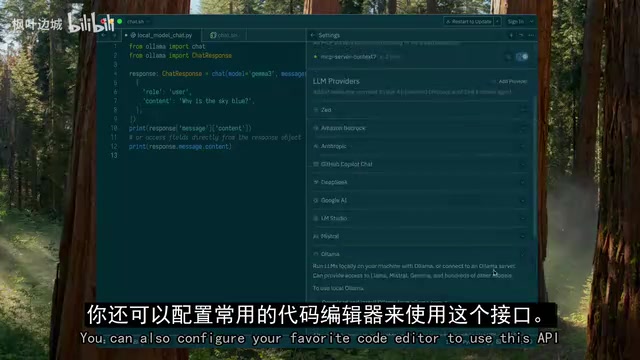
本地开源大模型跑代码实测:Qwen 3.5 够用吗?
海外资深开发者实测本地开源大模型 Qwen 3.5 跑代码:9B 小模型复杂任务翻车、小任务表现不错,397B 云端版本则轻松过关。附 Ollama 与 LM Studio 本地部署要点与显存门槛分析。
llama.cpp 新增 GLM-5.3-Flash 支持:本地跑智谱新模型
开发者 timkhronos 向 llama.cpp 提交 PR #27773,新增对智谱 GLM-5.3-Flash(GLM5-Next)的支持,用户将可在家用电脑本地运行该模型。本文解析这一进展对本地大模型部署的意义。

本地AI部署8大误区:参数越大真的越强吗?
本地AI部署的8大常见误区解析:参数越大不等于越强,激活参数≠总参数,高精度未必更好,本地≠隐私,买硬件≠省钱。教你用小型试镜和检索方案在现有电脑上跑通本地大模型工作流。

Ollama入门指南:零基础本地免费运行AI大模型
Ollama 零基础入门教程:无需互联网、API 密钥和费用,在本地笔记本电脑上运行开源 AI 大模型。本文讲解 Ollama 的用途、安装运行、应用搭建及硬件局限。
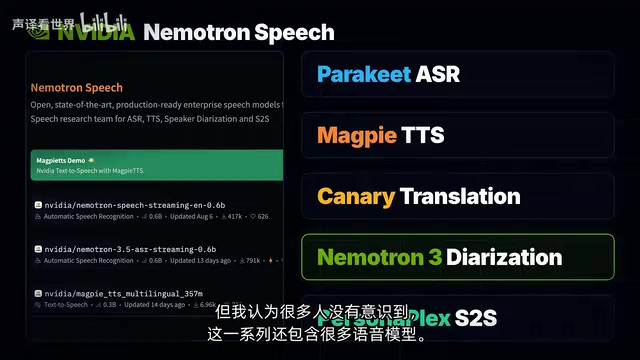
NVIDIA Nemotron 3 说话人分离实测:8人混音精准识别
NVIDIA 新发布的 Nemotron 3 说话人分离模型仅需4GB显存,支持多达8位说话人识别,可与任意ASR模型配合并完全本地部署。本文详解其能力、DER评估标准及8人混音实测表现。

英伟达Jetson本地跑Qwen3 27B:NVFP4+投机解码实测解析
英伟达在Jetson平台针对Qwen3 27B稠密模型做本地推理优化,采用NVFP4量化叠加投机解码的最优组合,让高端大模型在边缘设备上从能跑到能用。本文解析其技术原理与本地部署价值。

Unsloth 0.1.900 更新:Laya 决策模型与统一媒体库上线
Unsloth 发布 v0.1.900 版本,新增 Laya 决策模型支持、统一媒体库与文档查看器,图像视频生成提速约 4.5 倍,并带来大量 Apple Silicon 与训练推理优化。
Qwen3 Flash Next本地实测:142 tokens/s的私有编程助手怎么搭
海外博主实测Qwen3 Flash Next本地运行跑出142.6 tokens/s。本文详解从Unsloth安装、编程任务实操到推测解码与MTP多token预测的完整搭建思路,教你打造私有的本地代码修复助手。

Hermes Agent 完全指南:本地部署、技能系统与对比 OpenClaw
Hermes Agent 是 Nous Research 推出的 MIT 开源自改进 AI 智能体,支持自动生成技能、持久记忆与多平台接入。本文详解其特性、基于 Ollama 的本地部署方法、技能系统运作原理,以及与 OpenClaw 的对比。

