#本地部署
共 432 篇相关文章
Mac Studio本地实测DeepSeek V4.1 Flash:本地大模型能跑多远
在Mac Studio M3 Ultra上本地实测DeepSeek V4.1 Flash:550亿参数、N-gram机制、思考模式取舍与Deep SWE基准全解析,探讨本地大模型的能力边界与瓶颈。
HF热榜盘点:DeepSeek-V4.1-Flash登顶,端侧与本地部署全面爆发
Hugging Face真实热榜盘点:DeepSeek-V4.1-Flash以552B MoE多模态旗舰登顶,MiniCPM5 2B抢占端侧,Qwen3.8 27B GGUF量化版成本地部署首选,解析开源模型三大趋势。
Qwen3.8 27B 本地实测:性能碾压旗舰,配置才是关键
海外博主深度实测 Qwen3.8 27B 本地部署:Artificial Analysis 跑分达 52 分紧追 GLM 5.2。文章详解 FP8、NVFP4 量化版本选择、推理档位设置及 vLLM 与 SGLang 引擎速度对比,SGLang 可达约 200 tokens/秒。
MiniMax H3 开源视频模型本地部署实测:8G显存即可玩转
MiniMax H3 最新开源视频生成模型本地部署实测教程,支持文生视频、图生视频与首尾帧控制。8G显存即可运行,含ComfyUI部署流程、量化版本选择与实际应用效果分析。
LTX2.5开源本地部署实测:AMD显卡最低8G显存跑视频生成
开源视频生成模型 LTX2.5 本地部署实测:AMD 7900XTX 显卡在 Windows 11 环境下最低 8G 显存可运行,2 分钟生成 5 秒视频。附五套工作流对比与整合包、手动部署教程。
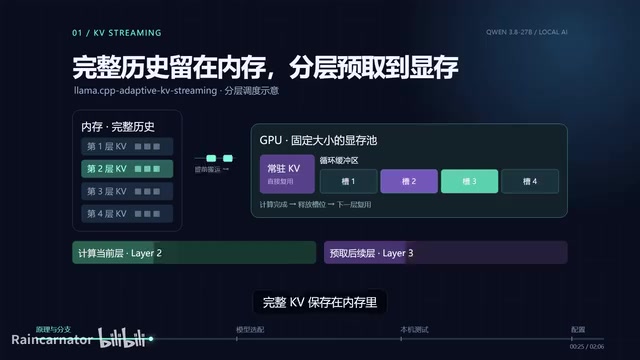
16G显存跑Qwen3 27B:192K上下文+视觉实测
在16G显存显卡上部署Qwen3 27B模型,通过llama.cpp Adaptive KV Streaming实现192K超长上下文与视觉能力。本文详解KV缓存瓶颈原理、量化版本选择及RTX 5080实测速度与任务能力。
MiniMax H3本地部署实测:开源视频模型效果与完整教程
MiniMax H3 开源视频模型本地部署实测:涵盖硬件要求、ComfyUI 完整部署教程,以及文生视频、图生视频的真实生成效果与耗时,适合想入门本地 AI 视频生成的用户参考。
用GPT和Grok搓出本地AI视频生成器,真能跑起来吗?
海外博主纯靠 GPT、Grok 和 Cursor,不写专业代码从零搭建本地 AI 视频生成应用,最终真的跑通了「威尔·史密斯吃意面」测试。本文拆解其构建全过程、14B 模型带来的质变,以及本地部署的现实门槛。
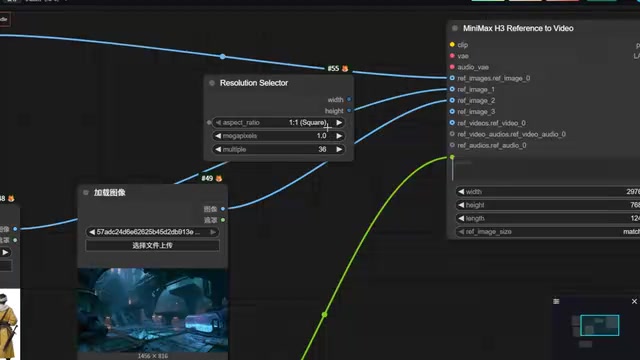
MiniMax H3本地部署教程:8G显存跑通开源视频模型
详解MiniMax H3开源视频模型本地部署工作流:从三图输入、参数化时长控制到Clip/UNet/VAE模型加载,重点讲解8G显存优化的lowvram、分块处理与内存节约三大节点,附ComfyUI采样合成完整链路。
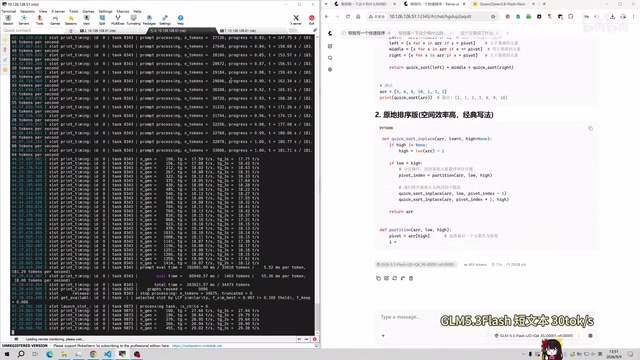
8卡2080Ti 22G本地部署GLM-5.3-Flash实测:TP2 PP4并行方案解析
8卡2080Ti 22G本地部署GLM-5.3-Flash实测:通过TP2 PP4混合并行方案,短文本达30tok/s,33K长文解码18tok/s、预填充180tok/s。深度解析多卡推理的并行策略与推测解码适用性。
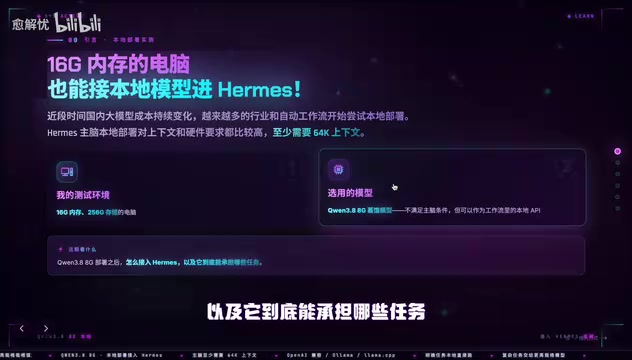
Hermes接入Qwen3-8B本地部署:低配电脑也能跑自动化工作流
在16G内存电脑上部署Qwen3-8B蒸馏模型并接入Hermes自动化工作流的实测记录。详解OpenAI兼容接口、Ollama、llama.cpp三种接入方式,以及低配设备下主脑调度加本地执行的分工模式。
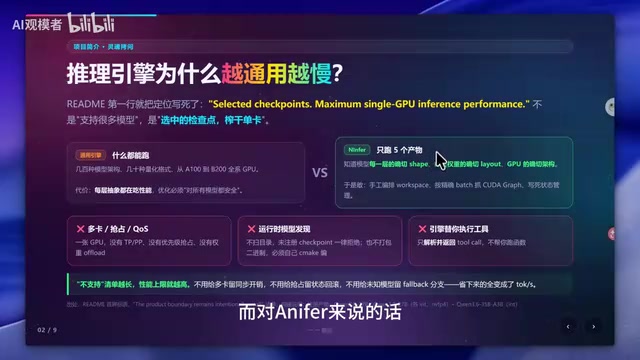
Anifer开源推理引擎实测:单卡5090狂飙150 token/s
开源推理引擎 Anifer 用 C++/CUDA 深度优化,单张 RTX 5090 上 Qwen3.8 27B 单并发实测稳定 144~150 token/s,8 并发官方跑分冲到 1147 token/s。本文解析它为何比 vLLM、llama.cpp 更快及实测数据。
本地部署私人DeepSeek全攻略:联网+知识库+隐私安全
手把手教你用Ollama、Chatbox、AnythingLLM搭建纯本地、可联网、带知识库的私人DeepSeek。涵盖蒸馏版模型选择、RAG知识库原理与API调用,隐私安全零门槛部署全流程干货。
DeepSeek v4.1 Flash本地部署真相:23秒才吐一个token
DeepSeek v4.1 Flash以MIT许可证和顶尖基准成绩引发本地部署热潮,但实测每token需23秒、510GB存储、1.9万美元集群四年才回本。本文拆解MoE架构下「选择性计算不等于选择性存储」的真相,帮你算清本地部署的真实成本。
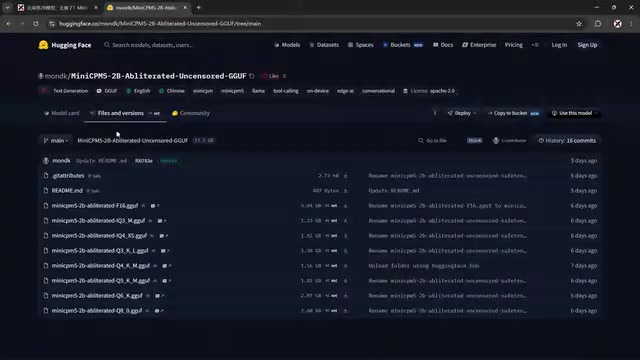
MiniCPM-2B无审查版本地部署教程:接入llama.cpp与Hermes全流程
MiniCPM-2B 本地部署完整教程:涵盖 GGUF 模型下载、llama.cpp 配置、启动脚本编写及接入 Hermes 客户端全流程。支持 131K 上下文,普通电脑即可运行的国产轻量级大模型部署指南。

4千美元淘到全新DGX Spark:本地部署大模型的性价比之选
一位Reddit用户以4000美元在Craigslist淘到全新DGX Spark,用于本地托管AI模型。本文解析这笔交易背后的性价比、二手交易安全,以及本地部署大模型的兴起趋势。
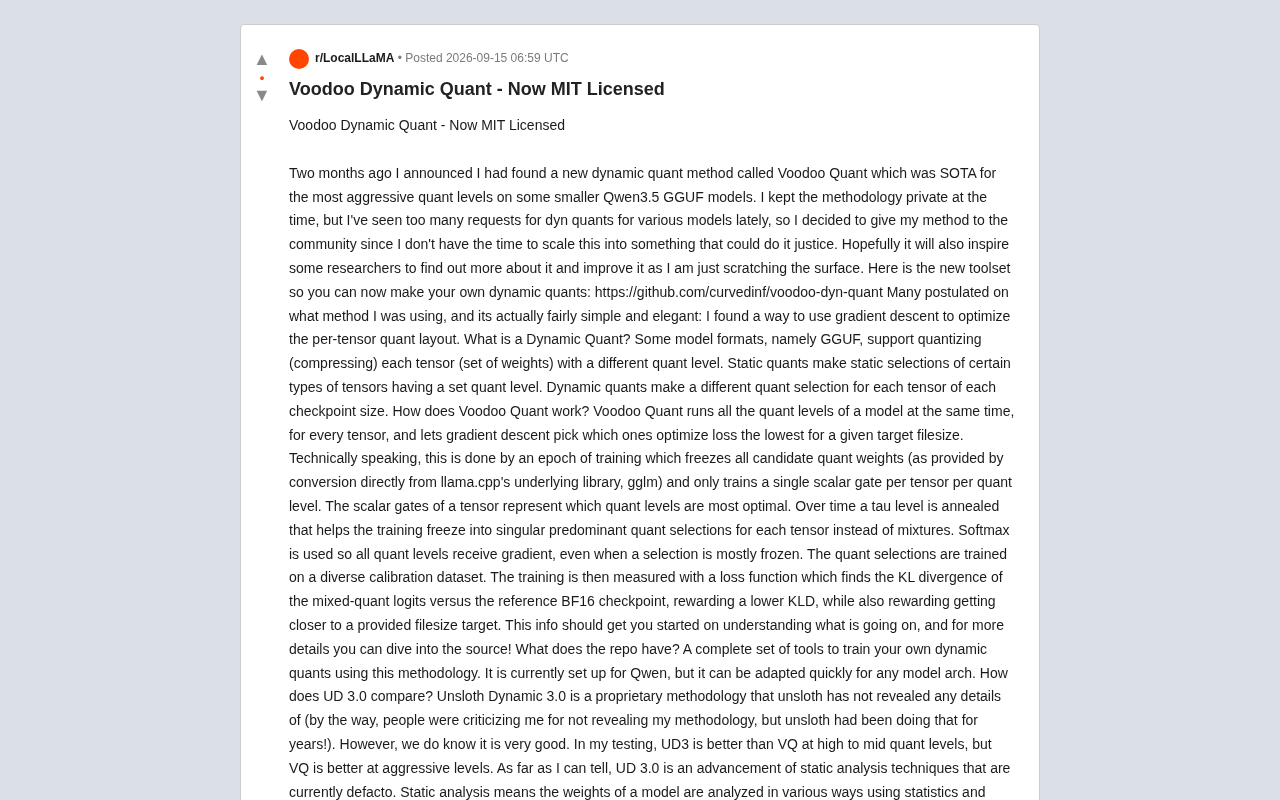
Voodoo Dynamic Quant开源:用梯度下降优化模型量化
开发者开源动态量化方法 Voodoo Dynamic Quant,采用 MIT 协议。它用梯度下降优化 GGUF 模型的逐张量量化布局,在激进低比特档位优于 Unsloth Dynamic 3.0,为低显存本地部署提供新工具。
Portable Computer登陆Windows:RTX GPU本地跑A…
Portable Computer登陆Windows:RTX GPU本地跑AI Agent
Portable Computer现已支持搭载NVIDIA RTX GPU的Windows PC,可在本地运行AI harness、agents和模型,无需上传云端即可处理本地文件与连接应用,并在需要时调用前沿云端模型。