#本地部署
共 415 篇相关文章
实战微调gpt-oss-20b:Unsloth训练到Ollama部署全流程
手把手实战:用 Unsloth 以 QLoRA 单卡微调 gpt-oss-20b,仅需约 14GB 显存,并导出 GGUF 部署到 Ollama。重点解析 Harmony 聊天模板与 <|return|> 停止符如何避免模型输出乱码或无限生成。

10-16GB显卡本地LLM实测排名:哪款模型最值得跑?
一份针对10-16GB显卡的本地大语言模型实测排名,涵盖Gemma 4、Qwen 3.6、GLM-4.7等十余款模型,从速度、连贯性、套路率等维度评测,并总结各厂商模型性格差异与运行配置建议。

birdjournal:全离线开源AI听声识鸟工具实测解析
birdjournal 是一款全离线开源 AI 听声识鸟工具,结合 BirdNET 与 Ollama 本地大模型,无需联网即可识别鸟类并自动生成多语言观鸟日记。本文解析其技术架构、实测表现与小模型幻觉应对经验。

LiteLLM 实战:用一个代理统管所有本地与云端大模型
LiteLLM 把 Homelab 里散乱的本地与云端大模型统一成一个 OpenAI 兼容网关,支持瀑布式故障转移、负载均衡与成本控制。本文详解其核心概念、路由策略、部署方式与实战配置。
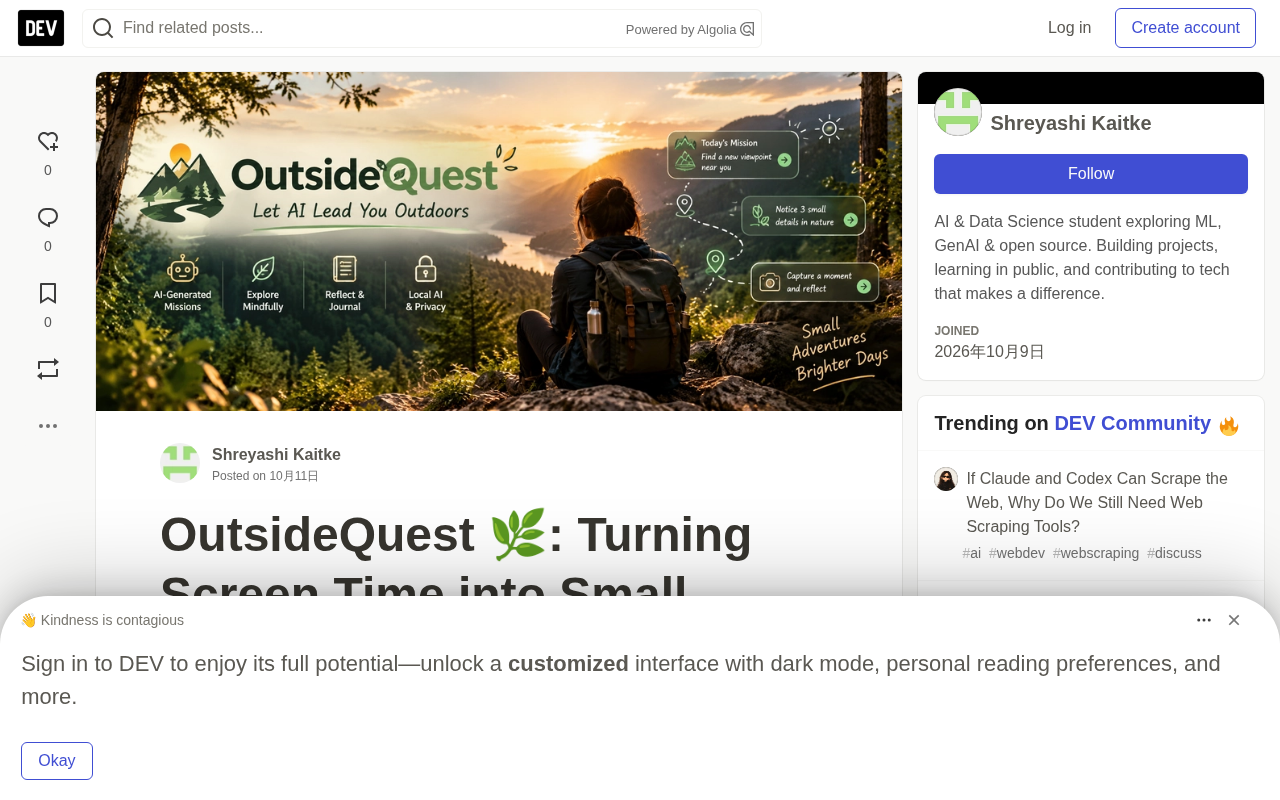
OutsideQuest:用本地AI把屏幕时间变成户外探险
OutsideQuest是一个开源AI户外探险助手,基于Python、Streamlit和本地Qwen2.5 3B模型,帮用户把屏幕时间变成实际的户外小任务。本文解析其技术栈、本地推理设计与开源创新理念。

Qwen-Image-2.1-Turbo本地部署指南:真实显存需求与避坑要点
Qwen-Image-2.1-Turbo被称作7B模型,但完整管线实为16.2B、下载量32.4GB。本文详解各精度下的真实显存需求、diffusers与ComfyUI运行方式、两大配置陷阱及非商业许可证限制。

4张R9700搭建本地AI服务器:1.8万美元支撑10人团队实测
一位开发者分享为10人初创团队搭建的本地AI推理服务器:4张AMD Radeon R9700共128GB显存,总价1.8万美元,实测Qwen3在16并发下聚合吞吐与长上下文性能数据,附完整硬件配置与功耗管理经验。

本地单卡748 token/s:Bonsai2+Ninfer+KVMem极值实践
本地单卡实测Ninfer+Bonsai2+KVMem组合,投机解码融合带来748 token/s解码与3.8K预填充的极值表现,并深入分析KVMem显存卸载、雷霆大思考死循环问题与小模型的框架化用法。

AI速报:Liquid决策模型与Saluki 27B本地部署盘点
AI速报本期盘点Liquid AI开放权重决策模型、IQ2量化约7.89GB的Saluki 27B、GitHub热榜Agent工具及Anthropic Claude Haiku 5.5降价75%,聚焦本地部署与低成本落地。

DigUp:本地运行EmbeddingGemma 2的Mac语义搜索工具
DigUp 是一款开源免费的 Mac 应用,本地运行 Google EmbeddingGemma 2 模型,支持对文本、图像、音频、视频进行跨媒介语义搜索,数据不出本机,兼顾隐私与实用。

Ollama 入门指南:本地部署开源大模型的核心工具
Ollama 是一款开源免费的本地大模型管理工具,支持 Windows、Mac、Linux 和 Docker 跨平台部署。本文介绍 Ollama 的核心作用、特点及典型应用场景,帮助零基础用户理解如何将 DeepSeek 等开源模型部署到本地使用。

Ollama是什么?本地部署开源大模型的入门指南
Ollama是什么?本文系统介绍这款开源大模型管理工具的作用、特点与应用场景,涵盖本地部署、跨平台支持、API调用、CPU/GPU资源利用等核心内容,帮助零基础用户理解如何把DeepSeek等开源模型部署到本地使用。

本地AI编程模型实测:18G显存能否跑赢Opus?
国外UP主实测七款本地AI编程模型,覆盖16/24/32/64GB四档显存。揭秘18GB模型「跑赢Opus」背后的基准测试陷阱,附Qwen、Gemma、GLM选型速查表与四条验证法则。

Meta重返开源:30B模型Muse Glimmer单张24G显卡可跑
Meta重返开源,推出30B参数的开放权重模型Muse Glimmer,单张24GB显卡即可运行,采用Apache 2.0许可证,支持多模态与推测解码加速。海外博主实测其编程、建模与前端设计能力,带你了解这款亲民本地大模型的真实表现。

Google EmbeddingGemma 2 本地部署教程:四模态AI搜索实战
Google EmbeddingGemma 2 本地部署完整教程,支持文字、图片、视频、音频四模态跨模态语义搜索,模型仅1.49GB普通电脑可装。从Python环境安装到四模态搜索实测全流程详解。

开源智能体本地部署实战:免费写代码、画图、生音乐
一套开源组合如何在本地部署多模态智能体,实现免费写代码、文生图、图像编辑高清放大与音乐转换?本文解析其部署思路、ComfyUI 接入方法与硬件门槛,带你搭建本地版多模态创作工作站。

开源AI下云端:10款本地部署神器深度盘点
海外AI博主盘点10款可本地部署的开源AI神器,涵盖Airllm推理引擎、LocalAI、Codex编码智能体、Beads记忆层等,推动开源AI从云端迁回本地桌面,兼顾隐私、成本与可控性。

本地部署Qwen3 Next实测:128G显存跑MoE大模型的真实体验
本地部署Qwen3 Next MoE大模型实测体验:128G显存设备上解码速度达241-274 token/秒,运行丝滑。本文梳理硬件平台、性能数据与智能体建模测试,并对内容可信度做客观分析。