#前沿研究
共 6583 篇相关文章

AI用15分钟破解戴尔显示器固件:逆向工程门槛正在消失
漏洞研究员用AI在约15分钟内完成戴尔S34R显示器固件的逆向与解密,过去需一周。本文解析AI如何提取DLL密钥、还原代码并用MD5自校验,以及固件密钥分发给用户的设计缺陷对硬件安全的含义。
松下相机固件逆向:软件层受阻,转向硬件飞线破解
LumX松下相机固件逆向项目最新进展:SEM2软件逆向遇瓶颈,转向拆机飞线读取固件镜像;初代S5已解锁200Mbps片门全开,二代机蓝牙链路逆向进行中。

AI让黑客15分钟攻破显示器固件,逆向工程门槛崩塌
一位漏洞研究者用AI在约15分钟内完成戴尔显示器固件逆向,从XE升级包提取镜像、定位硬编码密钥并解密验证。本文解析AI在逆向工程中的具体作用、固件加密的设计缺陷,以及漏洞研究门槛降低对安全行业的冲击。

MicroAGI:以轻量路线加速具身AGI落地
MicroAGI 项目在 Hacker News 引发讨论,主张用轻量、实时的微型模型加速具身AGI落地。本文分析其核心思路、具身智能的三道落地障碍,以及小模型路线与规模法则之间的分歧。
AI机器人安全隐患:秘密触发词如何将其变成危险武器
Hacker News讨论揭示AI机器人存在秘密触发词漏洞,攻击者可利用语音指令绕过安全约束执行危险动作。本文分析攻击原理、物理风险及防御策略,探讨AI安全的前置设计。

Terminal X用GPT-6.1匹配资深投资人判断达88.6%
Terminal X 的 Eval Agent 基于 GPT-6.1 Sol,用 54 条标准 rubric 评估投资组合是否符合基金授权,与资深投资人判断一致率达 88.6%,偏离项捕获率提升 25%。本文解析其工作方式、能力边界与对垂直评估产品的启示。
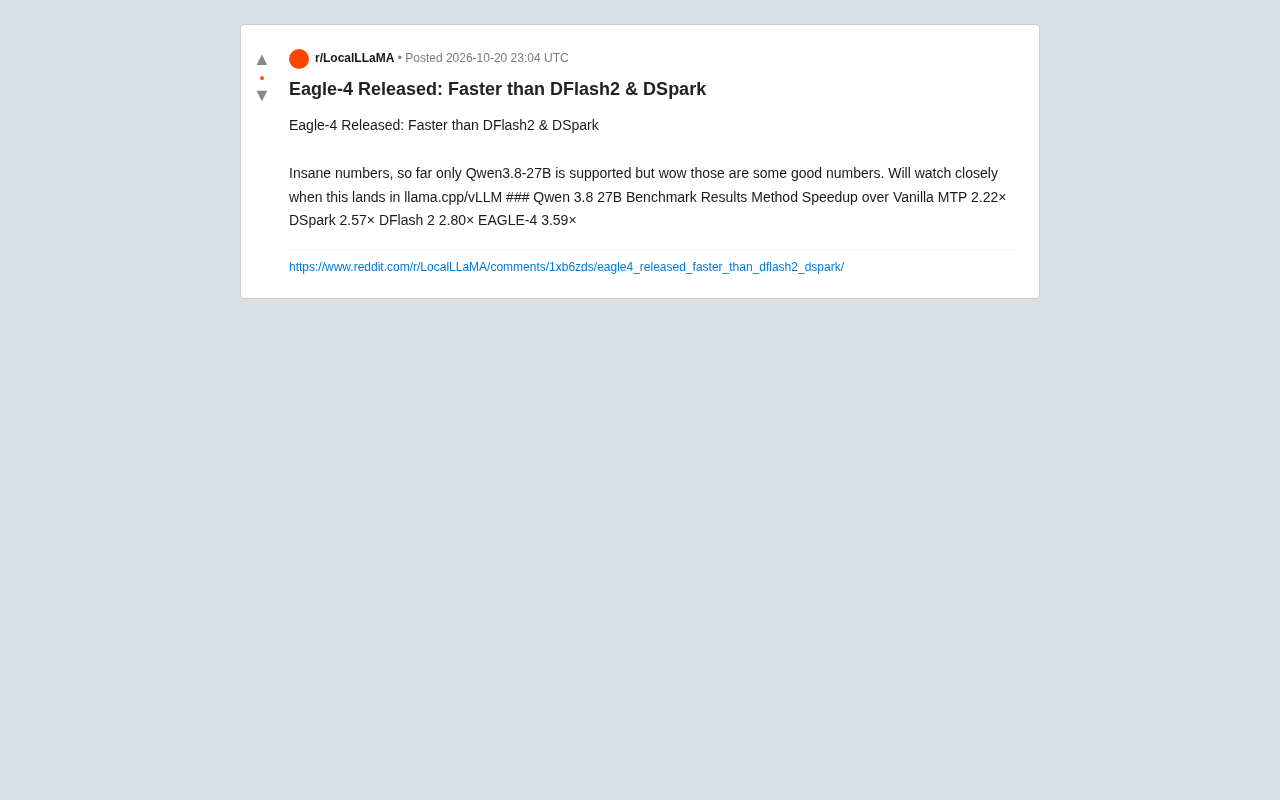
Eagle-4 发布:推理速度超 DFlash2 与 DSpark,Qwen3.8-27B 实测 3.59 倍加速
Eagle-4 正式发布,在 Qwen3.8-27B 上实现 3.59 倍推理加速,全面超越 DFlash2 和 DSpark。本文解读 benchmark 数据、技术背景及 llama.cpp/vLLM 集成前景。

从DQI到C-DQI:LLM自动生成编码手册评估议会话语质量
研究提出从DQI到C-DQI的完整协议,利用大语言模型自动生成并评估议会话语质量编码手册,对比理论驱动与数据驱动方案,实验显示数据驱动编码在模型间一致性上更优。

LLM为何接受泛化陈述?心理语言学因素揭示模型判断机制
研究测试12个LLM对泛化陈述的接受度,发现模型像人类一样权衡属性常见性与区分度,但忽略strikingness,且高度依赖事实真实性。隐藏状态操控实验提供因果证据。

极性盲区:LLM安全护栏的隐形漏洞
一项系统性研究揭示LLM安全护栏的「极性盲区」:否定和反义词替换可绕过有害意图识别。研究覆盖10个模型、3种语言、260条提示,最脆弱模型平均危害评分达4.12(0-5量表),且跨语言普遍存在,提示语义鲁棒性是安全对齐的底层短板。

ACE-Compression:压缩大模型的能力画像新评估框架
ACE-Compression 是一个能力中心的大模型压缩评估框架,从程序性推理、知识真实性、社会认知与人格保真四个维度评估量化与剪枝后的能力保留情况,揭示压缩如何重新分配模型能力画像。

多模态大模型分阶段训练:能力互斥还是协同进化?
一项针对84亿参数多模态模型的研究发现,分阶段训练中数学蒸馏会覆盖金融知识,领域阶段更多是修复而非安装能力,最佳检查点取决于任务,对检查点保留和调度策略提出新挑战。

CollabSciReM:科学对话对齐新框架,分解奖励破解LLM科研协作难题
CollabSciReM提出科学感知奖励分解框架,将LLM科研对话对齐拆分为对话质量、科学严谨性与结构效率三个维度,在SciQuality评测中匹配长度下取得65.3%胜率,专家盲测幻觉更少。

从Token到文件:多粒度检测AI参与代码的新框架
新框架在token级别建模AI作者身份,通过双LoRA适配器计算似然比,实现行、块、文件多粒度AI代码检测与定位。内部测试72.4宏F1,外部基准行级F1达62.5,真实人类代码误报率低于1%。

人类与多模态LLM的联想创造力差异:抽象视觉刺激实验
研究比较人类与多模态大模型在难以命名视觉刺激下的联想创造力,发现人类描述更具多样性、语义距离更大,并在高难度时转向低层视觉属性,而模型仍依赖语义联想。

UvA-MT的WMT26机器翻译方案:LLM推理时优化策略
UvA-MT团队在WMT26通用机器翻译任务中提交全LLM推理时方案:用顺序采样加精炼提示生成候选池,再以LLM成对评判和循环投票选出最佳译文,覆盖全部23个翻译方向。
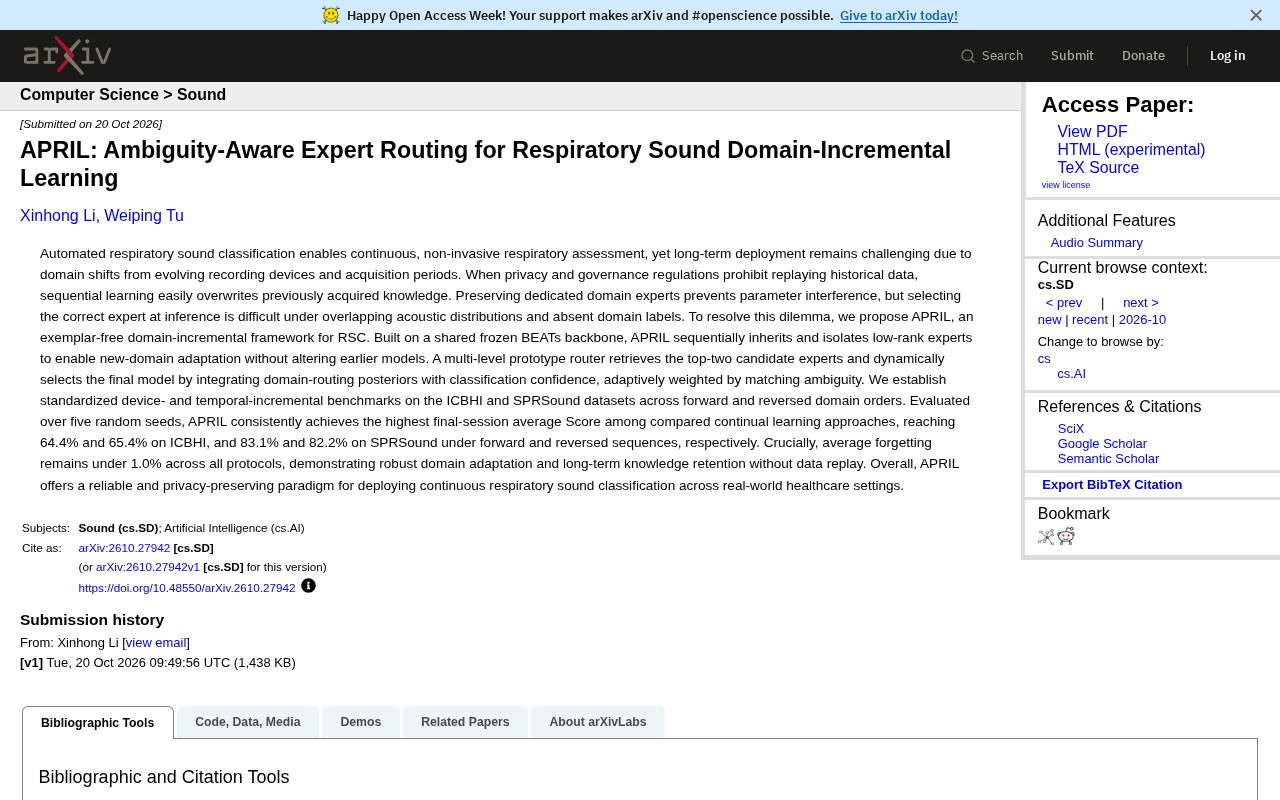
APRIL:呼吸音分类的免回放增量学习新框架
APRIL框架提出免回放域增量学习,通过低秩专家隔离与歧义感知路由解决呼吸音分类中的域偏移和灾难性遗忘,在ICBHI和SPRSound上实现低于1%的遗忘率。

SciDiagBench:按图类型评估科学图表的新基准
SciDiagBench 是一个按图表类型分类的科学图表评估基准,包含 11 种类型、165 张图表,通过人类偏好引导让自动评估更贴近专家判断,弥补现有 VLM 基准的通用标准缺陷。

