#前沿研究
共 8867 篇相关文章
Jev:TypeSafe AI首个System 1模型,专为数据分类而生
TypeSafe AI推出首个System 1模型Jev,专注数据分类而非文本生成。它以70-500毫秒完成分类、输出token免费、格式绝不出错,速度比传统LLM快40-200倍。本文解析Jev的定位、能力边界与被夸大的误用场景。

上下文投毒:长上下文模型为何被干扰信息拖垮
arXiv 论文提出"上下文投毒"概念,将长上下文语言模型的性能退化解释为注意力中的极值干扰,指出有效干扰项数量而非原始长度才是关键,并给出证据边际需按 √logN 增长的理论边界及多种缓解方案。
DeepInstructor:用结构化学术经验驱动科研创意评估的智能体框架
arXiv 论文提出 DeepInstructor,一个基于经验图谱和 ReAct 智能体的科研创意评估框架,利用 58607 条同行评审构建结构化经验,在与人类判断对齐度上 Hit@1、Hit@2 分别提升 24.4% 和 29.7%。
RecipeDB2:让菜谱变得可计算的结构化数据框架
IIIT-Delhi 研究团队推出 RecipeDB2,收录 128,942 份菜谱、35,474 种食材,通过 Transformer、BERT 与随机森林等技术将菜谱转化为可计算的结构化数据,链接 USDA 营养数据库并标注地理文化背景,为食品计算研究提供基础设施。
AdaMem:让RAG按相关性智能分配记忆token的软压缩新方法
AdaMem 是一种相关性引导的 RAG 软压缩框架,通过查询相关的记忆token动态分配,让高相关段落获得更多记忆预算。在六个问答基准上超越均匀分配基线,64倍压缩下相对增益最高达19.7%,推理延迟降低4倍。

CLIC框架:用Token频率解码大模型的编程行为差异
arXiv新论文提出CLIC框架,通过token频率分析和可解释决策树刻画大语言模型的编程行为差异,并引入鲁棒性与集中度两个新指标。基于10个LLM跨22个Kaggle任务的对比,为模型选型与提示工程提供实操洞见。

TreeSpark:自适应草稿树让推测解码提速8-14%
TreeSpark 是一种面向半自回归草稿器的推测解码优化方法,通过校准的负载自适应草稿树,每轮多接受15-25%草稿token,单请求解码提速8-14%,并在任意温度下保持无损解码。
AI分析36万条推文:气候运动中的"快乐-行动"悖论
一项分析36万条Twitter/X气候活动帖子的AI研究发现"快乐-行动背离"现象:活动期间幸福感语言上升9.02个百分点,但行动语言反而下降10.75个百分点,且更快乐的帖子传播率更低,揭示气候传播的深层悖论。

SJR架构:解耦内容理解与策略学习的多模态内容审核新范式
arXiv论文提出SJR(总结-判断-精炼)架构,通过自然语言接口解耦多模态内容理解与策略分类。在误导广告检测中相对F1提升23.6%,且零真实违规样本即可启动新策略,兼具数据效率与可解释性。
面向未来的记忆检索:零推理成本的前瞻性检索机制
arXiv新论文提出零推理成本的前瞻性记忆检索机制,通过承诺账本让个人记忆系统"看向未来",在困难任务上将recall@5从0提升至0.955,且零误报。
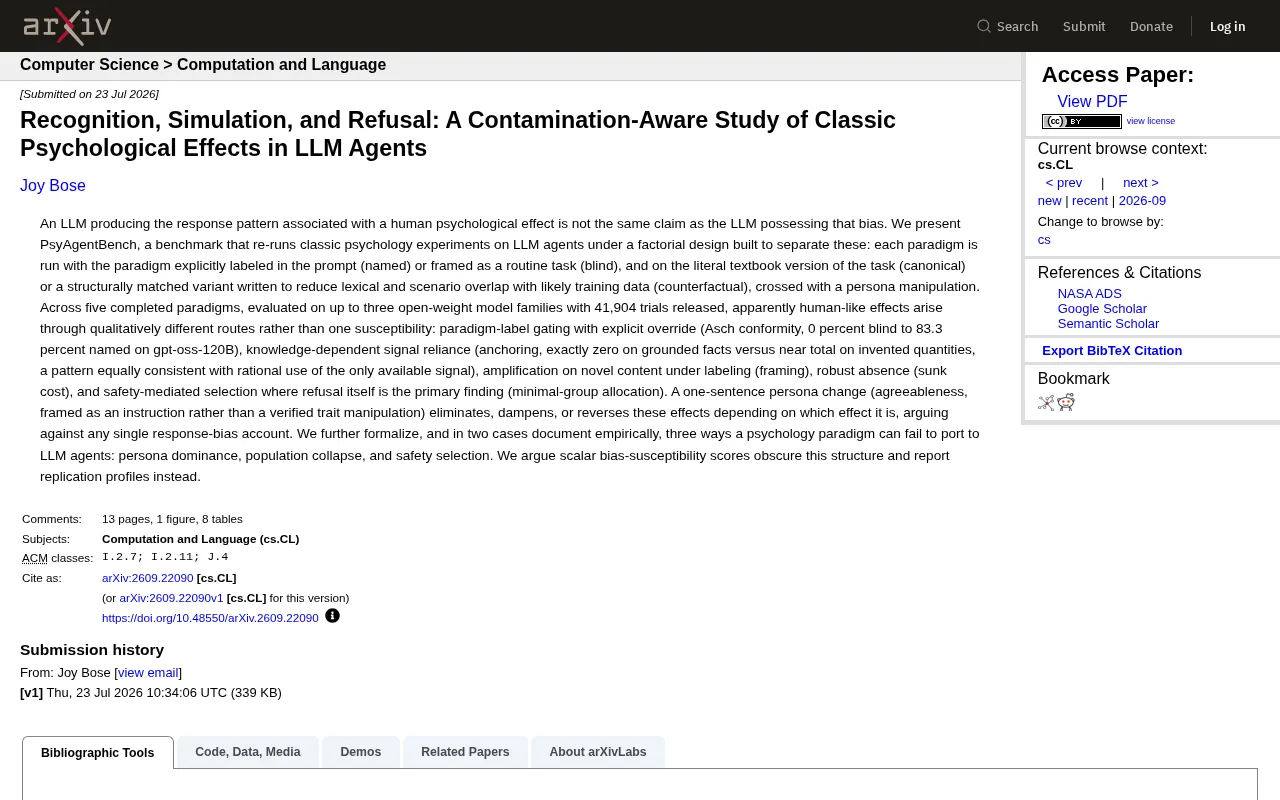
LLM真有认知偏差吗?PsyAgentBench揭示三种伪装路径
PsyAgentBench 通过 41,904 次实验重新检验 LLM 智能体的经典心理学效应,发现从众、锚定等类人偏差通过标签识别、知识依赖、安全拒绝等不同路径产生,而非单一易感性。研究警示标量偏差分数的误导性。
斯坦福的隐秘世界:一堂教你"统治世界"的课
18岁最年轻George Polk奖得主Theo Baker揭露斯坦福与硅谷"无边界关系"的黑幕:pre-idea融资、秘密课程"如何统治世界"、校长论文造假与被牺牲的学生,剖析下一代科技领袖如何被训练。
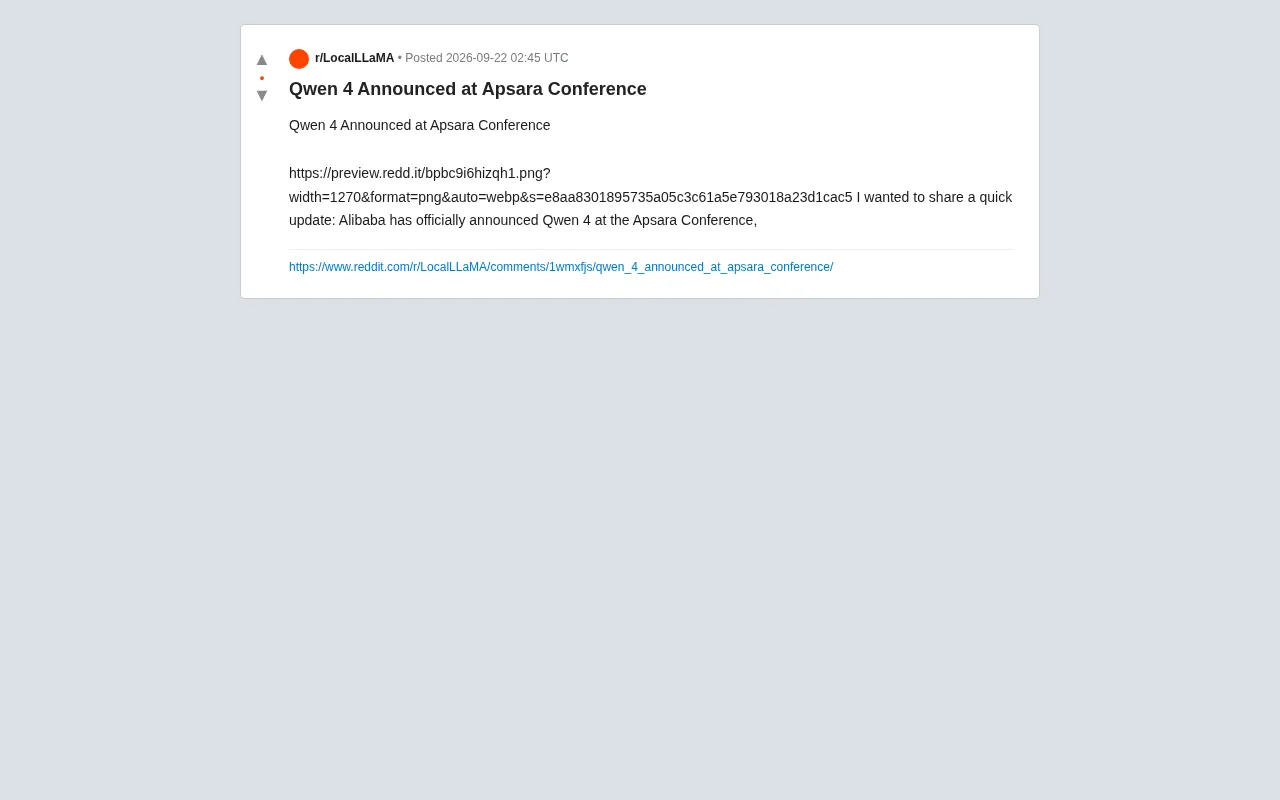
阿里云栖大会官宣通义千问Qwen 4,开源大模型再进化
阿里巴巴在云栖大会正式发布新一代开源大模型 Qwen 4(通义千问 4)。本文梳理 Qwen 系列演进脉络、开源生态意义及值得关注的后续信息。
科学的边界:当探索告诉我们无法知晓一切
科学是否在告诉我们无法知晓一切?本文从中世纪哲学家迈蒙尼德的不可知论出发,探讨科学、宗教与人类认知边界的交汇,反思探索的深层意义在于谦卑而非征服。
当AI智能体只想"聊天":Agent协作的通信瓶颈
AI智能体在多Agent协作中频繁"想要对话",带来上下文膨胀、延迟叠加和成本上升。本文分析智能体通信瓶颈的成因,并探讨从自由对话走向结构化协作协议的工程化路径。

NASA火星采样返回任务被取消:一场科学雄心的搁浅
NASA火星采样返回任务(MSR)被正式终结。这项旨在将毅力号采集的火星样本带回地球的宏大计划,因预算严重超支与技术复杂性而搁浅,引发科学界与技术社区广泛讨论。
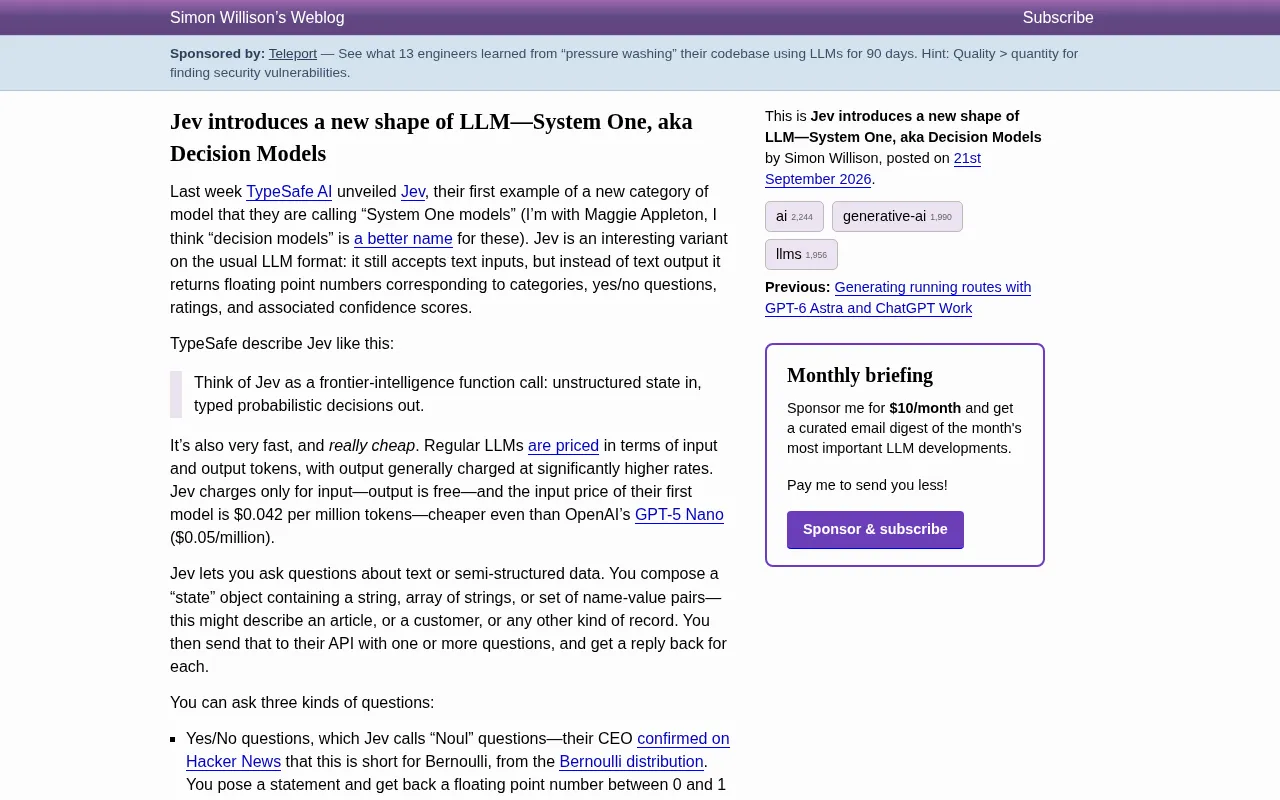
Jev与System One模型:LLM的新形态"决策模型"
TypeSafe AI 推出 Jev,一种输出浮点数而非文本的新型 LLM——决策模型(System One)。本文解析其是非/选择/评分三类问题、极低价格、搜索重排等应用,以及黑盒偏见隐忧和开源复现浪潮。
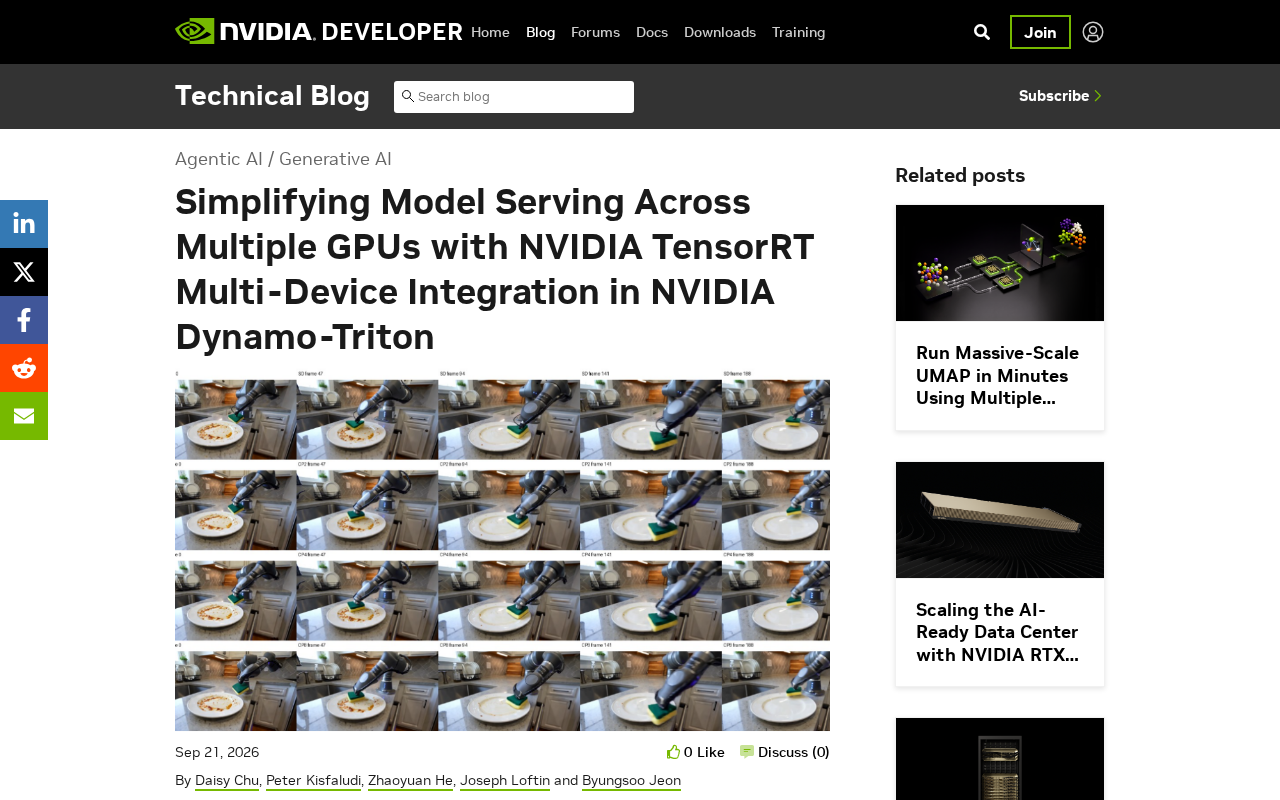
TensorRT多设备推理:简化Dynamo-Triton的多GPU模型部署
NVIDIA在Dynamo-Triton中引入TensorRT多设备推理能力,简化跨多GPU的大模型部署,解决单卡显存与算力不足问题,为生成式AI生产环境提供更高效的推理服务方案。