#开源工具
共 11644 篇相关文章
OpenAI Agents API解析:开源Codex背后的资源变现逻辑
OpenAI上线Agents API,将开源Codex Harness封装为云端智能体服务。本文解析其Sandbox云端环境、超长上下文压缩、工具搜索、多智能体并行三大增值能力,以及开源+收费背后的资源变现商业逻辑。
Qwen3 Max最新版实测:分数升了,为何有的能力反降?
海外博主实测阿里 Qwen3 Max 最新 0902 检查点:整体跑分升至 86.25% 登榜单第三,却在电梯、弓箭等前端交互题上退步,全靠一道 3D 手表题的首个满分拉动。附与 Gemini 3.8 Flash、Muse Spark 1.3 的横向对比。
双卡RTX4090跑通Qwen3-Next:8并发满血长上下文实测
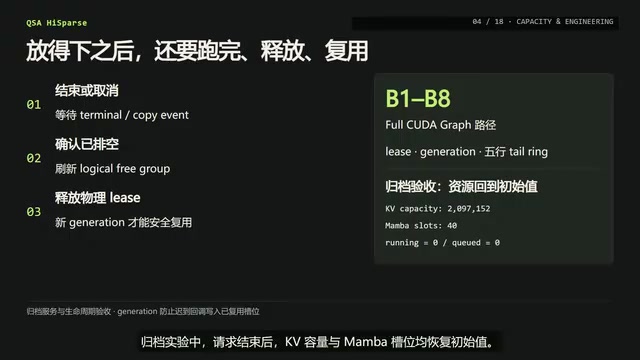
用两张48GB RTX 4090跑通Qwen3-Next的8并发长上下文推理,通过KV热缓存卸载省下约84%显存。实测涵盖显存账本、快路径吞吐、真实终端记录与多代理任务交付,附完整数据与免责说明。
Cursor工程师揭秘:AI协作的真正瓶颈是信任而非模型
Cursor团队工程师深度分享:AI Agent协作的真正瓶颈不是模型能力,而是信任体系。从验证技能、Eval评估到强约束CI架构,揭秘如何让Agent自动合并PR、单月提交近千个PR的完整方法论。
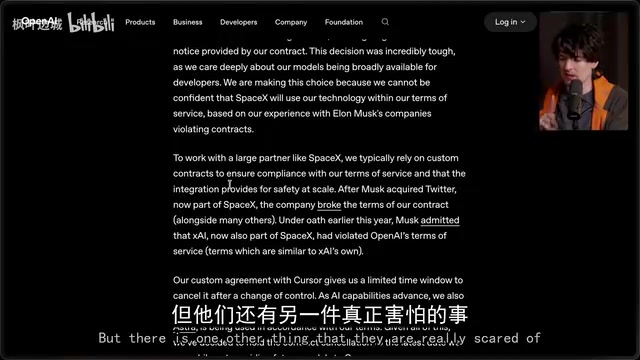
OpenAI对Cursor断供内幕:SpaceX收购引发的模型战争
OpenAI宣布终止与Cursor合作,将于11月12日切断模型访问。本文深度解析SpaceX收购Cursor引发断供的真正原因——模型蒸馏、数据争夺与即将发布的Astra,以及开发者的应对方案。

Cline+MCP搭建AI编程自动化工作流保姆级教程
一份基于B站实操教程的Cline+MCP搭建指南,详解MCP模型上下文协议原理,并手把手配置搜索、浏览器自动化、百度地图、本地文件与MySQL数据库五类MCP服务,打造AI编程自动化工作流。
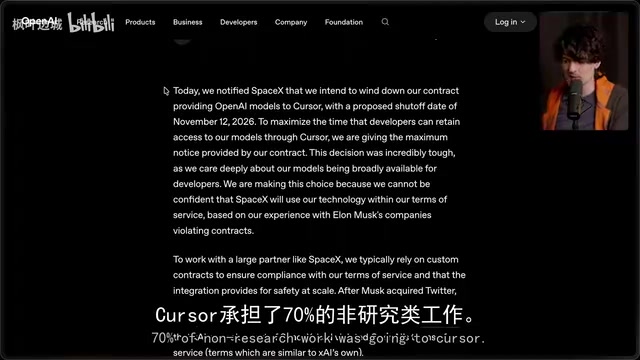
OpenAI与Cursor决裂内幕:模型访问将于11月切断
海外科技博主爆料OpenAI与Cursor决裂内幕:因Cursor被SpaceX收购引发数据蒸馏担忧,OpenAI将于11月12日切断模型访问,新模型Astra成关键。附用户应对方案。

X法律施压致Nitter与XCancel再度关停
隐私友好型X前端Nitter和XCancel在X升级法律行动后再度关停。本文解析X从技术封锁转向法律施压的策略变化,以及开源第三方前端面临的长期生存困境。

Fugleramme:能听鸟叫并画出19世纪风格插画的电子墨水相框
Fugleramme 是一个登上 Hacker News 的开源项目,用电子墨水相框监听鸟鸣、识别鸟类,并以19世纪博物学插画风格展示。本文拆解其声音识别、生成式插画与e-ink显示技术,探讨边缘AI的创意应用。

在服务端 Swift 中调用 WorkOS API 的实践指南
本文介绍如何在服务端 Swift 应用中调用 WorkOS API,涵盖类型化资源、结构化错误处理、自动重试及基于 AsyncSequence 的分页四大核心能力,帮助开发者构建可靠的企业身份认证集成。

Show HN上的AI进步讽刺短作:一场关于技术狂热的冷思考
Hacker News上出现名为「Loss.」的微型讽刺项目,以极简方式调侃AI进步狂热。本文解析这类技术社区自省文化的价值,探讨在AI爆发期保持批判性思考的意义。

GRP-Obliteration:单个提示词即可解除大模型安全对齐
GRP-Obliteration 宣称仅用单个未标注提示词即可解除大模型的安全对齐。本文解析其核心思路、对开源模型安全的启示,以及在信息有限下如何理性看待这类权重级去对齐攻击。
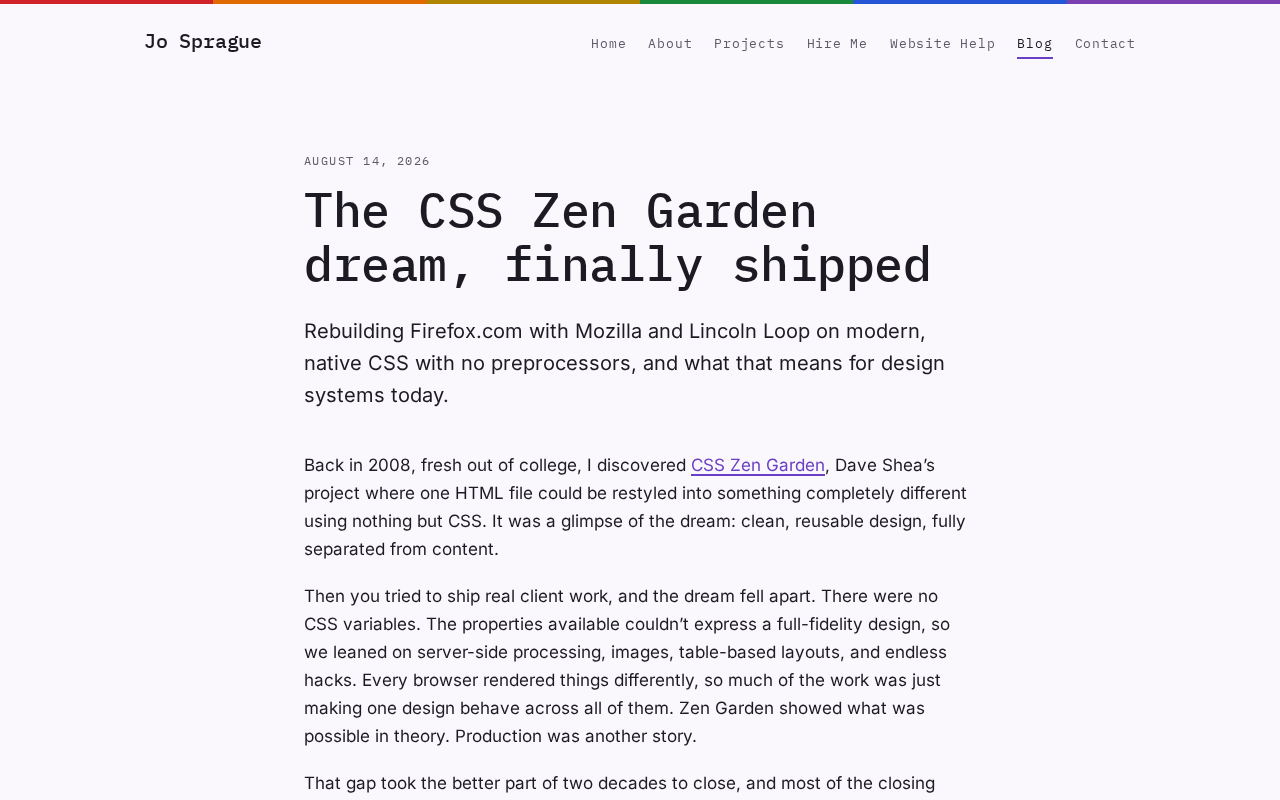
CSS Zen Garden的理想终成现实?聊聊内容与样式分离
Hacker News 热帖「The CSS Zen Garden dream shipped」引发讨论。本文回顾 CSS Zen Garden 内容与样式分离的设计理想,分析现代 CSS 如何让这一梦想落地,以及组件化时代理想与现实之间的张力。
开源AI落后前沿模型仅4.4个月:差距正在缩小
开源AI落后前沿模型仅4.4个月:差距正在缩小
一份《State of Open Source》报告指出开源AI模型平均仅落后前沿闭源模型4.4个月。本文解读这一时间差指标的意义、背后驱动力,以及它对企业、开发者与闭源实验室的影响。
让AI审查自己的文档:验证CLAUDE.md真伪的开源工具包
RAG Techniques仓库作者开源了一套工具,用于验证AI Agent读取的CLAUDE.md和项目文档中哪些是猜测、哪些被代码证伪。文章解析其置信度标注机制、与Claude Code /init的对比及局限性。
19.8MB的LLM:44M参数模型如何在CPU上跑出1900 tok/s
开发者QLNI从零训练出仅19.8MB、44M参数的量化语言模型SHADOW-50M,采用三元权重和冻结指纹词表,CPU上跑出约1900 tok/s。它把计算交给专用电路、记忆交给磁盘索引,在精确计算与可靠检索任务上超越同级模型。
LangGraph生产环境三大隐患:CVE漏洞、85%存储膨胀与静默循环
LangGraph智能体在生产环境存在三类隐蔽的checkpoint可靠性问题:CVE-2026-71433越权漏洞、85%存储膨胀与崩溃后的静默循环。本文解析成因、可测量的成本数据及实用应对策略。
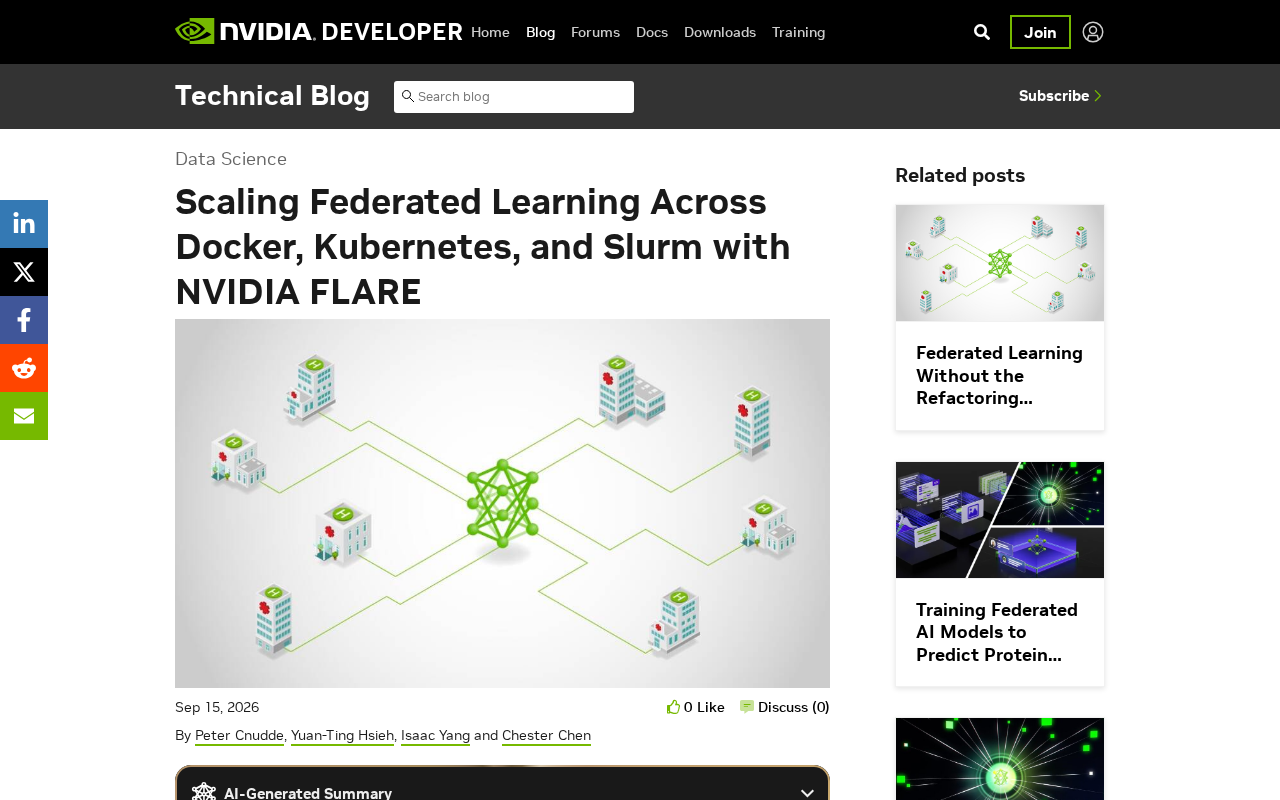
NVIDIA FLARE联邦学习实战:跨Docker、K8s与Slurm扩展部署
NVIDIA FLARE开源联邦学习框架支持跨Docker、Kubernetes与Slurm部署,解决异构基础设施下的FL扩展难题,助力医疗、金融等隐私敏感行业从原型走向生产落地。