#深度学习
共 63 篇相关文章

可训练激活函数能否提升语音识别系统?
可训练激活函数能否提升语音识别系统的性能?本文解析 PReLU、可训练 Swish 等方案的原理、对 ASR 任务的潜在收益,以及参数开销与过拟合等实际权衡。

SW-KAN:用q-正交多项式破解KAN的域不匹配难题
SW-KAN 提出用 Stieltjes-Wigert q-正交多项式构建 Kolmogorov-Arnold 网络,通过 exponential-of-tanh 映射和三项递推解决多项式 KAN 的域不匹配难题,在图像分类与函数逼近上实现更优的精度-效率权衡。
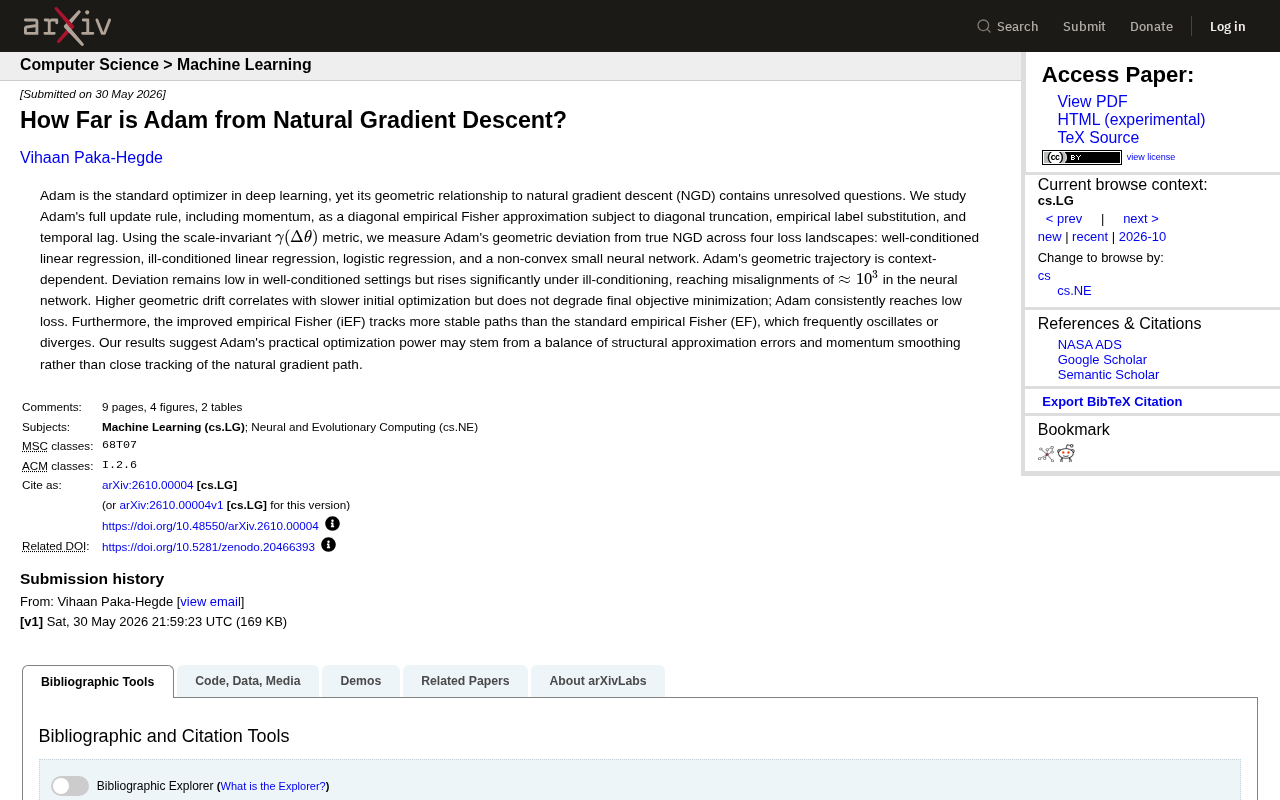
Adam优化器与自然梯度下降的几何距离有多远?
一篇arXiv新研究用尺度不变的几何度量,系统分析了Adam优化器与自然梯度下降(NGD)的距离。结果显示Adam在病态和非凸场景下偏差可达10^3量级,但最终收敛不受影响,其威力源于近似误差与动量平滑的平衡。
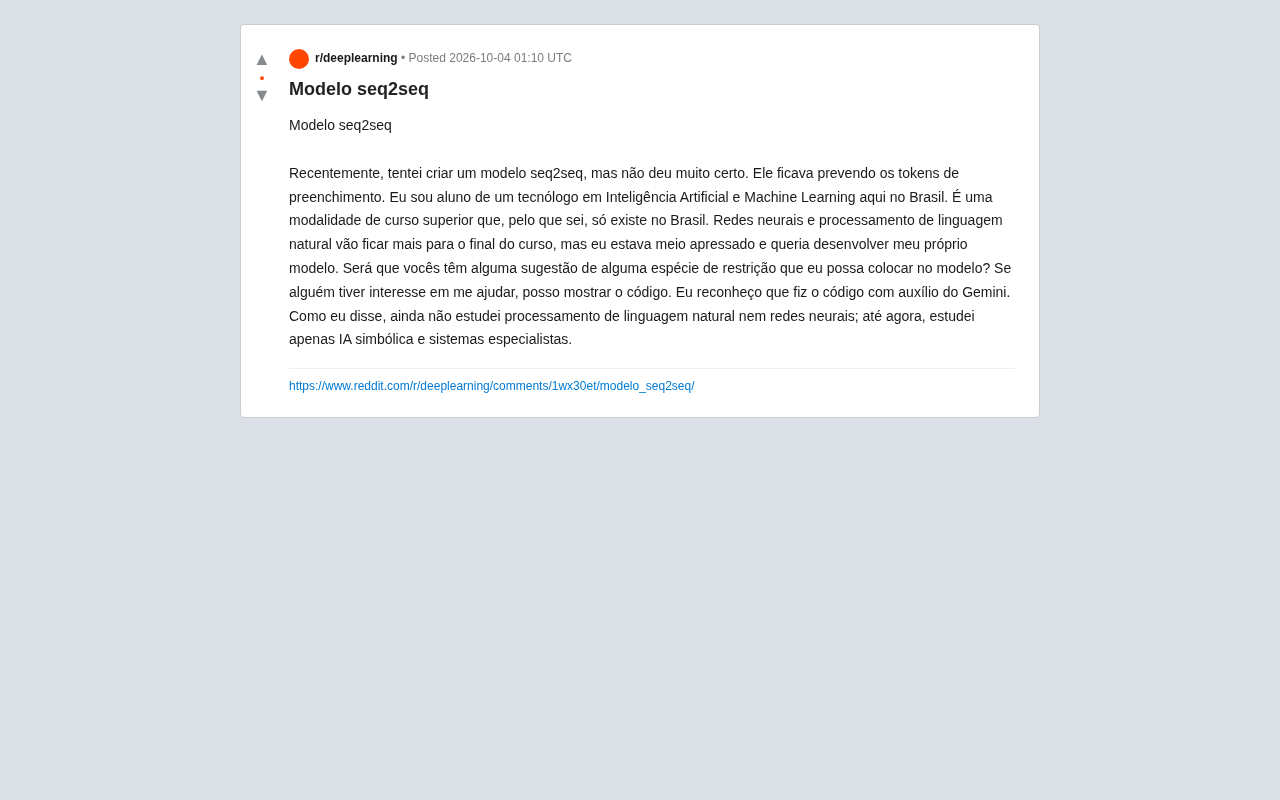
Seq2Seq模型只会预测填充符?常见问题与修复思路
seq2seq模型训练时只预测填充token是新手常见问题。本文分析其根源——损失函数未屏蔽padding、数据失衡,并给出loss masking、teacher forcing等训练与解码层面的修复建议。

拓扑域外泛化:让AI预测系统从未见过的动力学突变
NeurIPS论文提出拓扑域外泛化方法,通过特征分离与物理稀疏先验修复分层DSR模型缺陷,使AI能在不知控制参数的情况下预测系统分岔与动力学突变,适用于PLRNN和Neural ODE。

深度学习为何十年攻不下表格数据?Frank Hutter的解答
AutoML专家Frank Hutter解析深度学习为何十年难以攻克表格数据:脏数据、无法跨表迁移是核心障碍,而上下文学习通过模式级迁移终于带来突破。深度剖析TabNet失败原因与TabPFN范式。
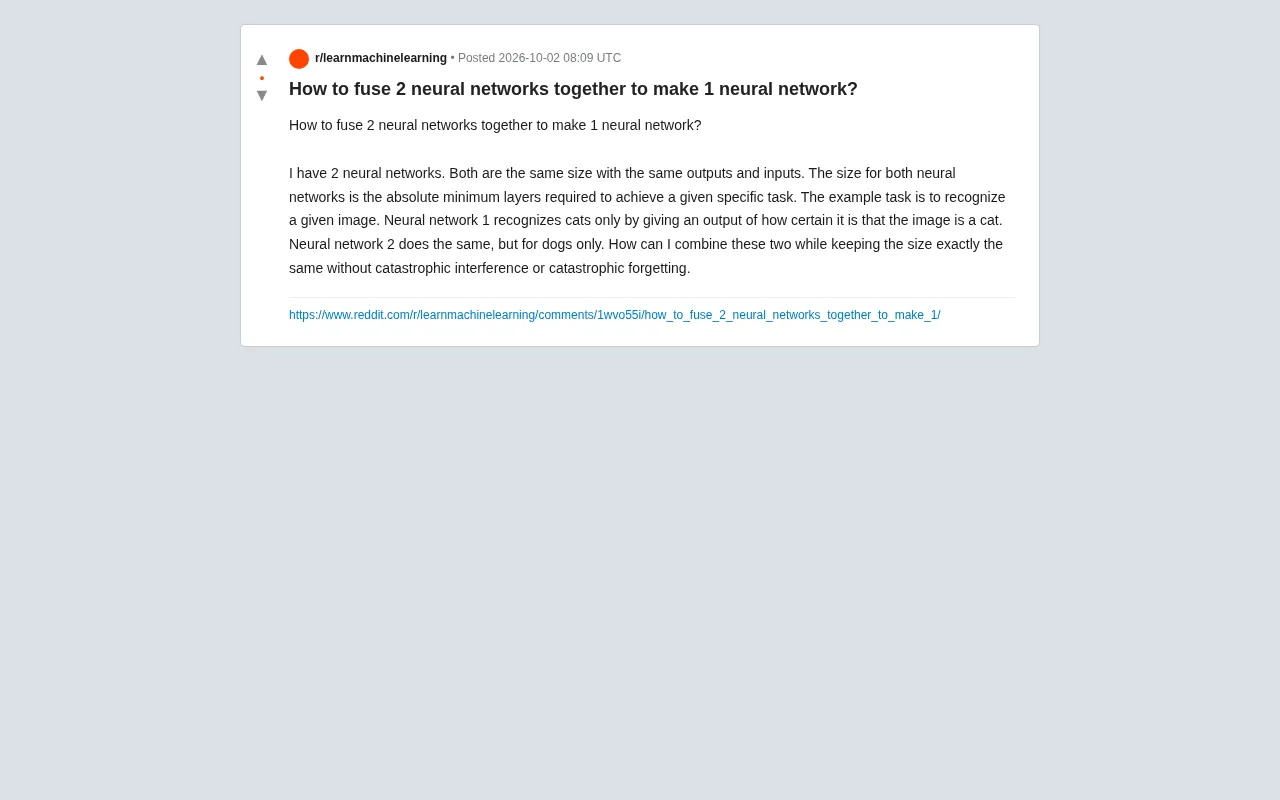
如何融合两个神经网络?模型合并与灾难性遗忘详解
如何将两个专精的神经网络(识别猫与识别狗)融合为一个模型,同时避免灾难性遗忘?本文解析模型合并的技术难点,介绍知识蒸馏、神经元对齐、多头联合训练等可行方案。
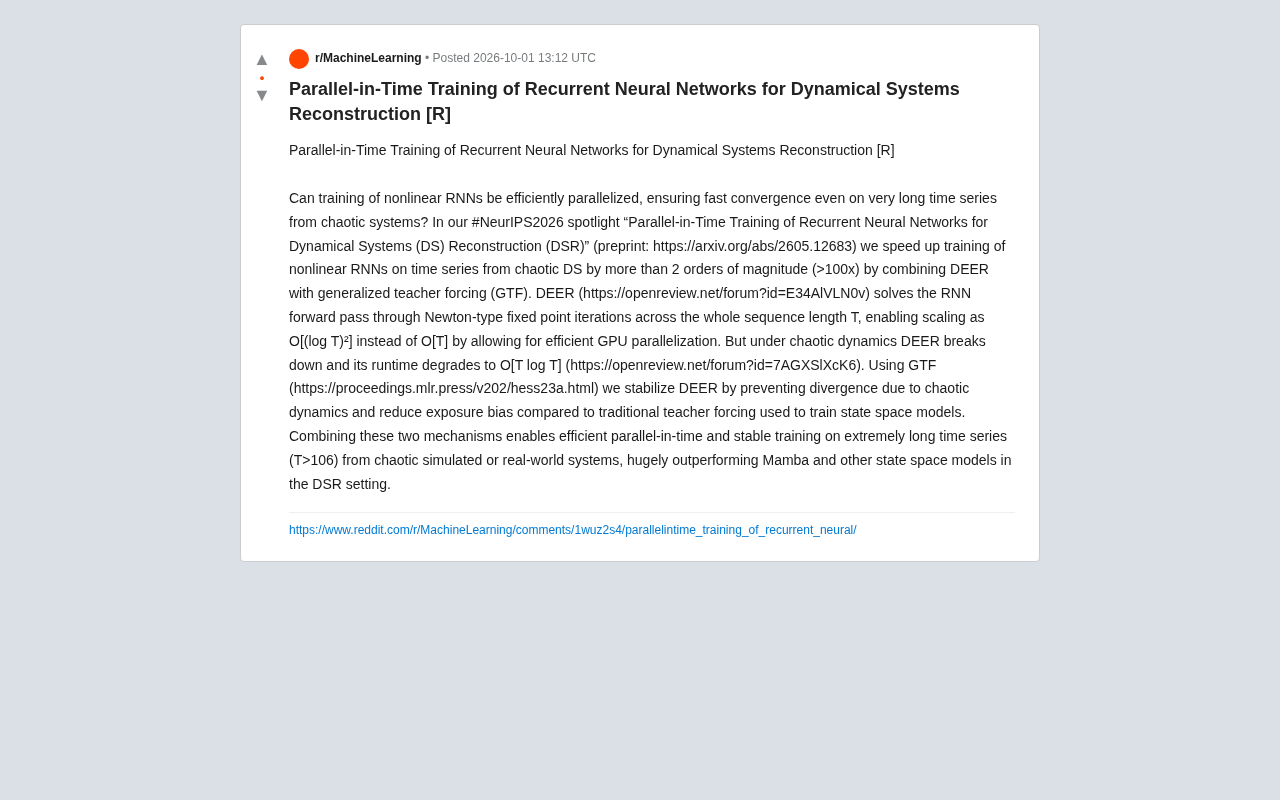
RNN训练提速100倍:时间并行方法攻克混沌系统重建难题
NeurIPS 2026 Spotlight论文提出时间并行训练方法,结合DEER与广义教师强制(GTF),将混沌动力学系统上的RNN训练提速超100倍,并在动力学系统重建任务中超越Mamba等状态空间模型。

AI Agent能自动生成项目,还需要学深度学习代码吗?
AI Agent能自动生成完整深度学习项目,还需要学底层代码吗?B站UP主钱玉通过猫狗分类demo演示AI一键建项目,并用数据泄漏案例说明为何读懂代码、把控流程的能力在AI时代反而更重要。
文本分类模型演进:从词袋到Transformer的可视化解析
从词袋模型到RNN、CNN与Transformer,本文以可视化视角梳理文本分类模型的技术演进,并深入探讨准确率、效率与校准之间的权衡,帮助开发者做出合理的模型选型。

视觉大模型入门指南:从预训练到下游任务全解析
视觉大模型入门系统教程:解析预训练与下游任务适配两大板块,梳理从BERT到GPT-4V的大模型演进,讲解LLM、VLM分类及从通才到专才的迁移学习路径,附学习前置要求与算力建议。

什么是VAE?变分自编码器通俗解析
VAE(变分自编码器)到底是什么?本文用通俗方式解析VAE的原理、与普通自编码器的区别,以及它在Stable Diffusion等图像生成模型中的关键作用。
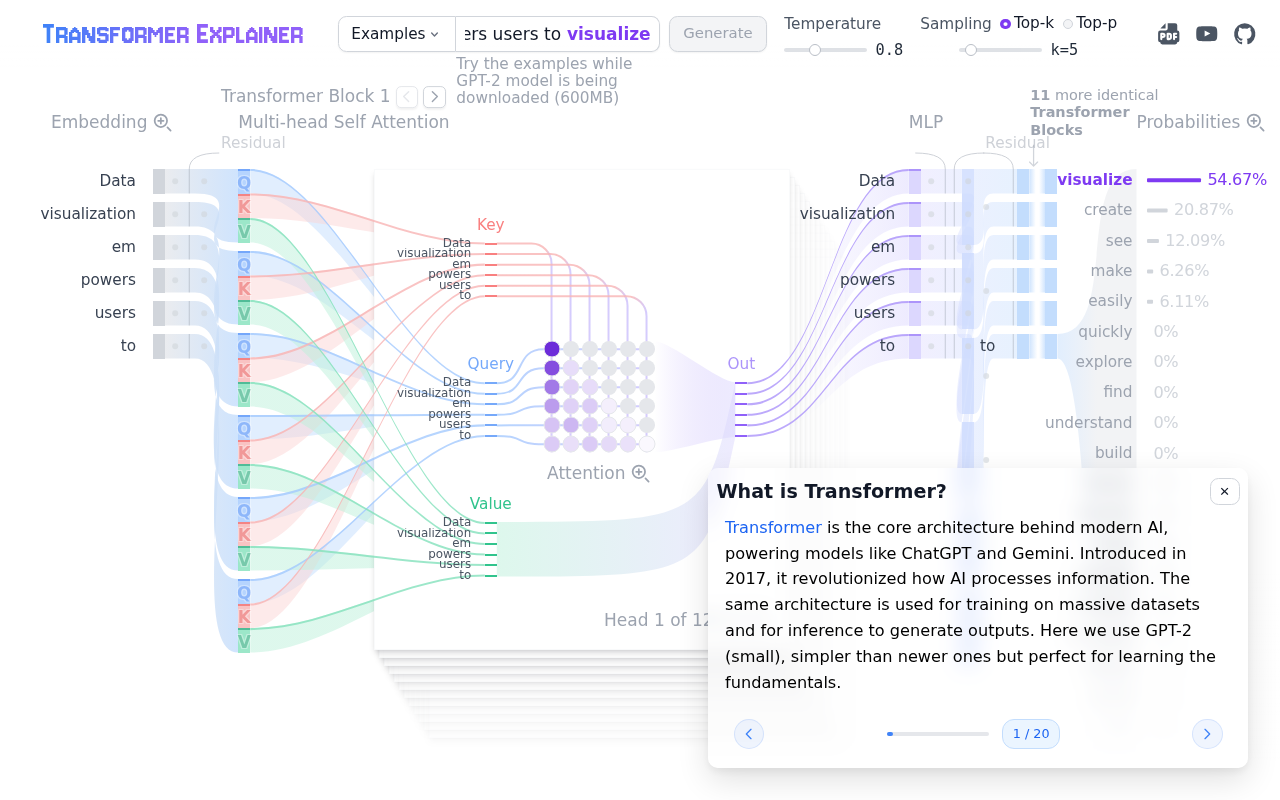
可视化理解Transformer:拆解大模型背后的核心架构
用可视化方式拆解Transformer架构,深入浅出讲解自注意力机制、多头注意力、位置编码与编码器-解码器结构,帮助AI学习者建立对大模型底层原理的直观理解。
TinyTorch:自己动手实现PyTorch,从张量到Transformer
TinyTorch 是一个免费开源的机器学习教学课程,引导你从零构建一个可运行的深度学习框架,覆盖从张量、自动微分到 Transformer 的完整链条。本文解析它的学习路径与价值,帮你从调库者变成真正理解框架原理的工程师。
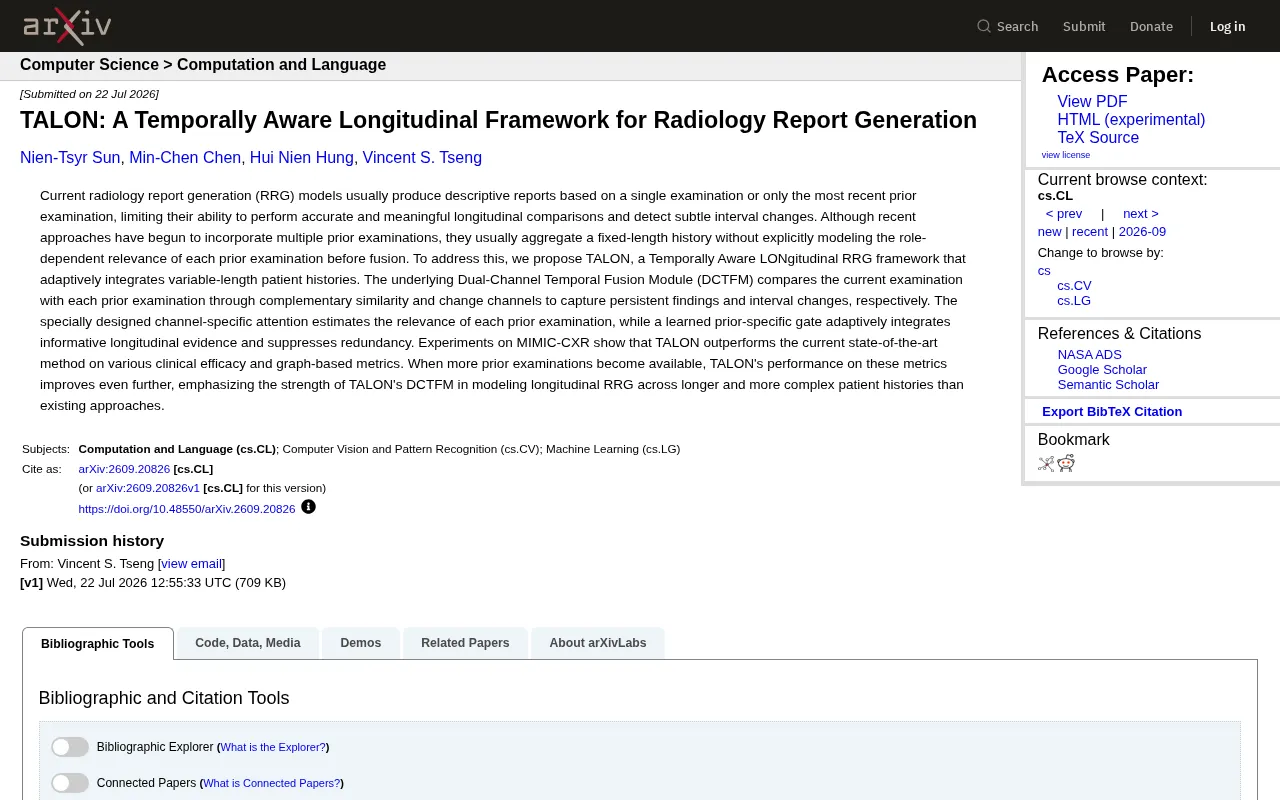
TALON框架:时序感知让放射学报告生成更懂"变化"
TALON是一个时序感知的纵向放射学报告生成框架,通过双通道时序融合模块(DCTFM)自适应整合可变长度患者病史,在MIMIC-CXR数据集上超越现有最先进方法,且病史越长表现越好。

FlashAttention与Muon是如何诞生的?拆解突破性论文背后的方法论
FlashAttention和Muon Optimizer这类突破性论文是如何诞生的?本文从领域交叉、问题重述、系统性试错等角度,拆解顶尖AI研究成果背后的方法论,解答'为什么事后看这么简单'的疑惑。
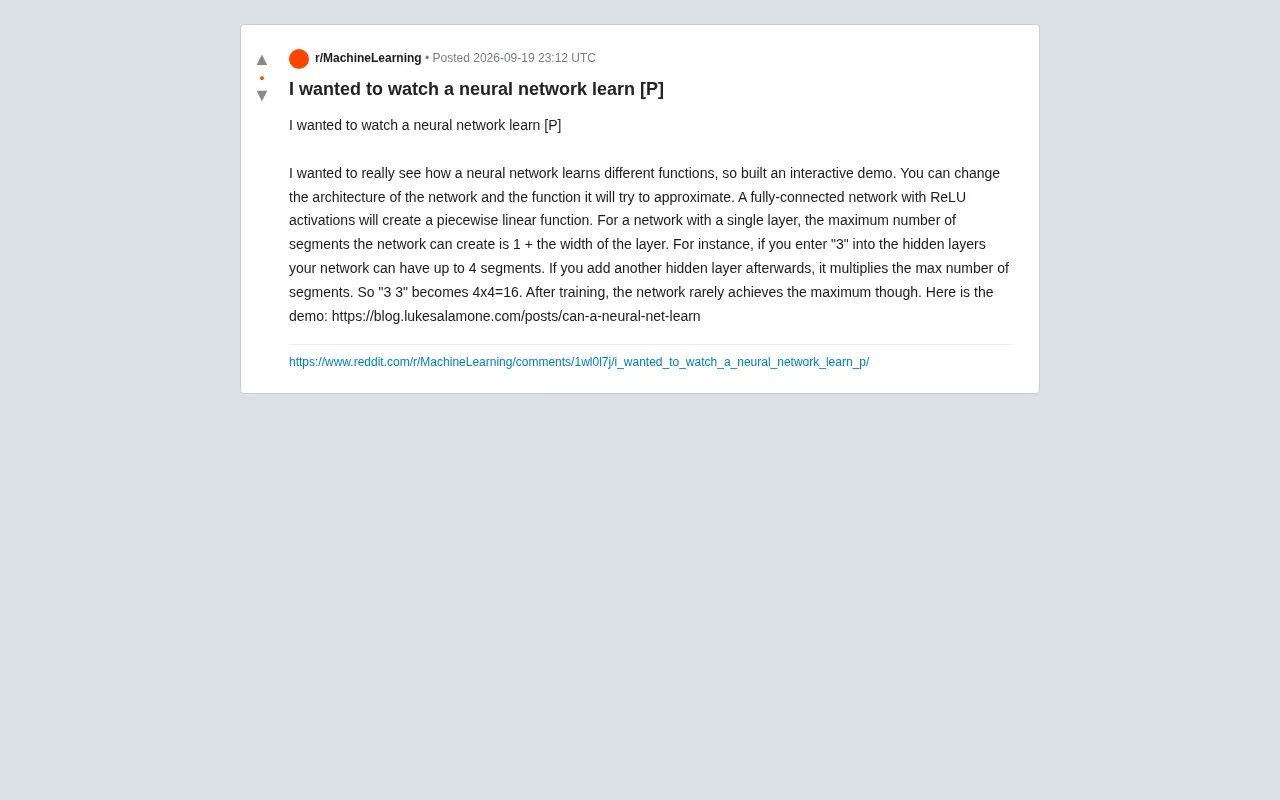
可视化神经网络学习:ReLU如何拟合任意函数
开发者构建交互式演示,可视化神经网络的学习过程。文章解析 ReLU 全连接网络如何用分段线性函数逼近目标,探讨网络宽度、深度与最大段数的关系,以及理论容量与实际训练之间的差距。
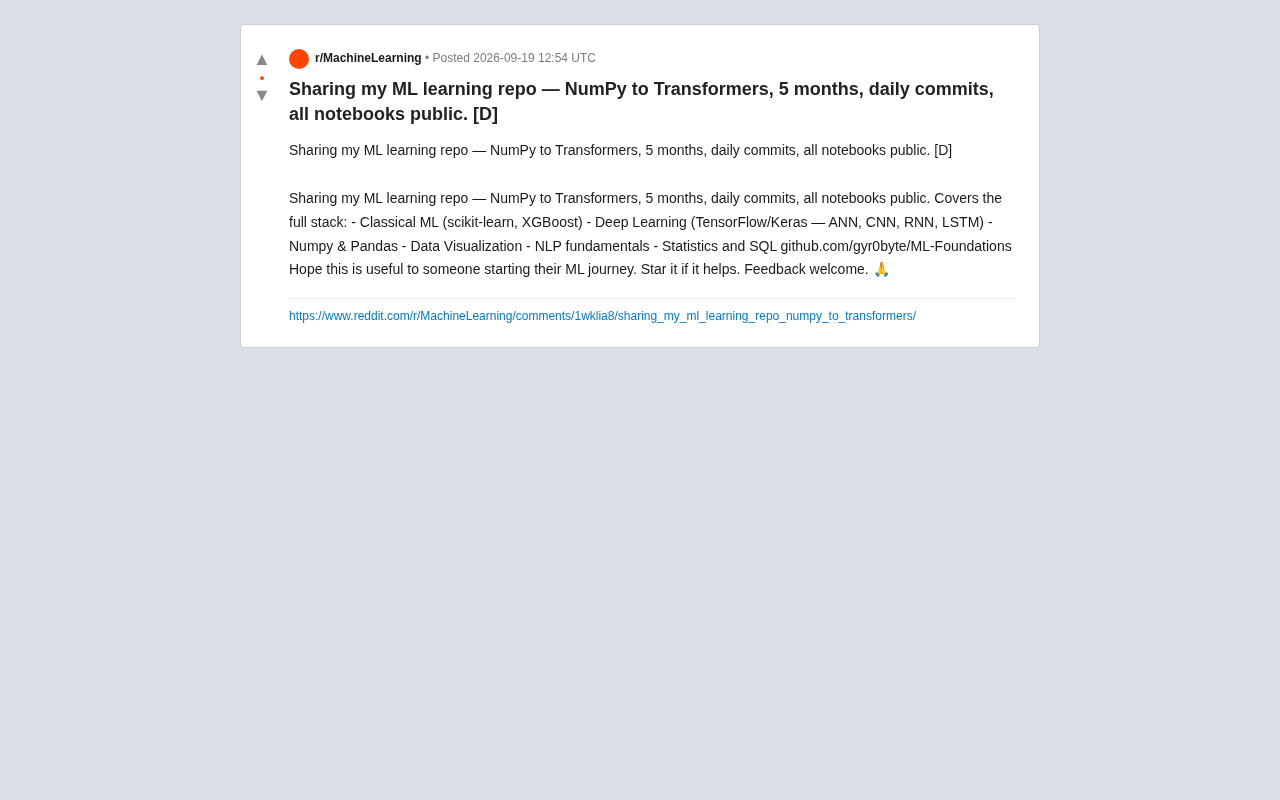
从NumPy到Transformer:一份5个月机器学习自学路线图开源分享
一位开发者在Reddit开源了5个月每日提交的机器学习自学仓库ML-Foundations,覆盖NumPy、Pandas、scikit-learn、XGBoost到CNN/RNN/LSTM及NLP和Transformer基础,是入门者值得参考的学习路线图。