深度
AI 领域长篇解读、行业观察、技术分析 —— 慢下来读一篇。
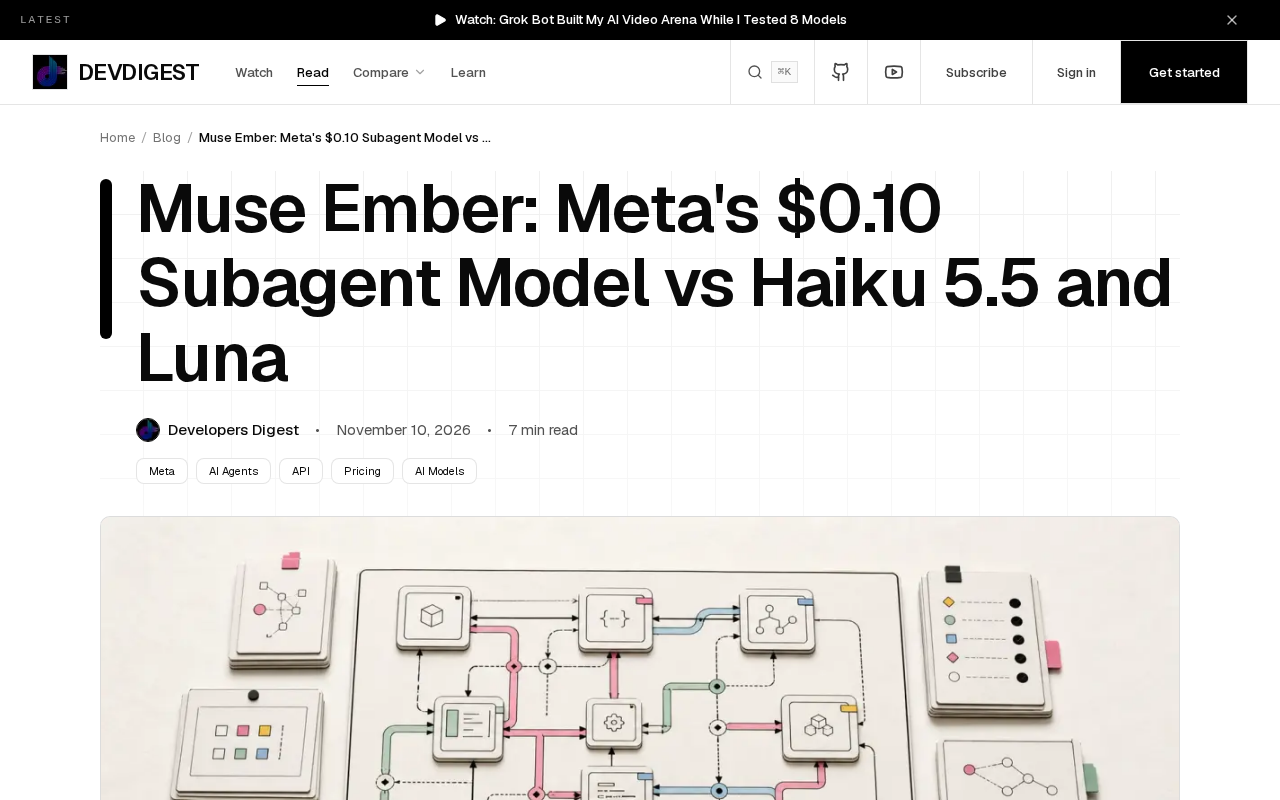
Muse Ember:0.10美元级子代理模型的三方对决
Meta 的 Muse Ember 以每百万 token 输入 0.10 美元、输出 0.50 美元的定价对标 Haiku 5.5 和 GPT-6 Luna。本文分析三款低价子代理模型在生态协同、稳定性和通用推理上的差异,帮助开发者做出选型判断。

AlphaProof Code发布:三百万行Lean证明验证Signal加密
AlphaProof Code代理为Signal核心加密编写三百万行Lean证明,展示AI自动化形式化验证的进展。本文分析其对软件工程流程的意义、规格正确性依赖以及证明可维护性等落地挑战。

GitHub日报·11月10日:Agent Skills 生态大爆发
Agent Skills 生态集中爆发, 官方规范, 生产实践, 个人配置三层同时上榜; Matt Pocock 个人技能仓库单日涨一千七百多星, 反映市场对可信技能配置的强烈需求; sherlock 老项目突然翻红, 单日涨幅居前, 说明榜单混合了技术趋势与社会热点
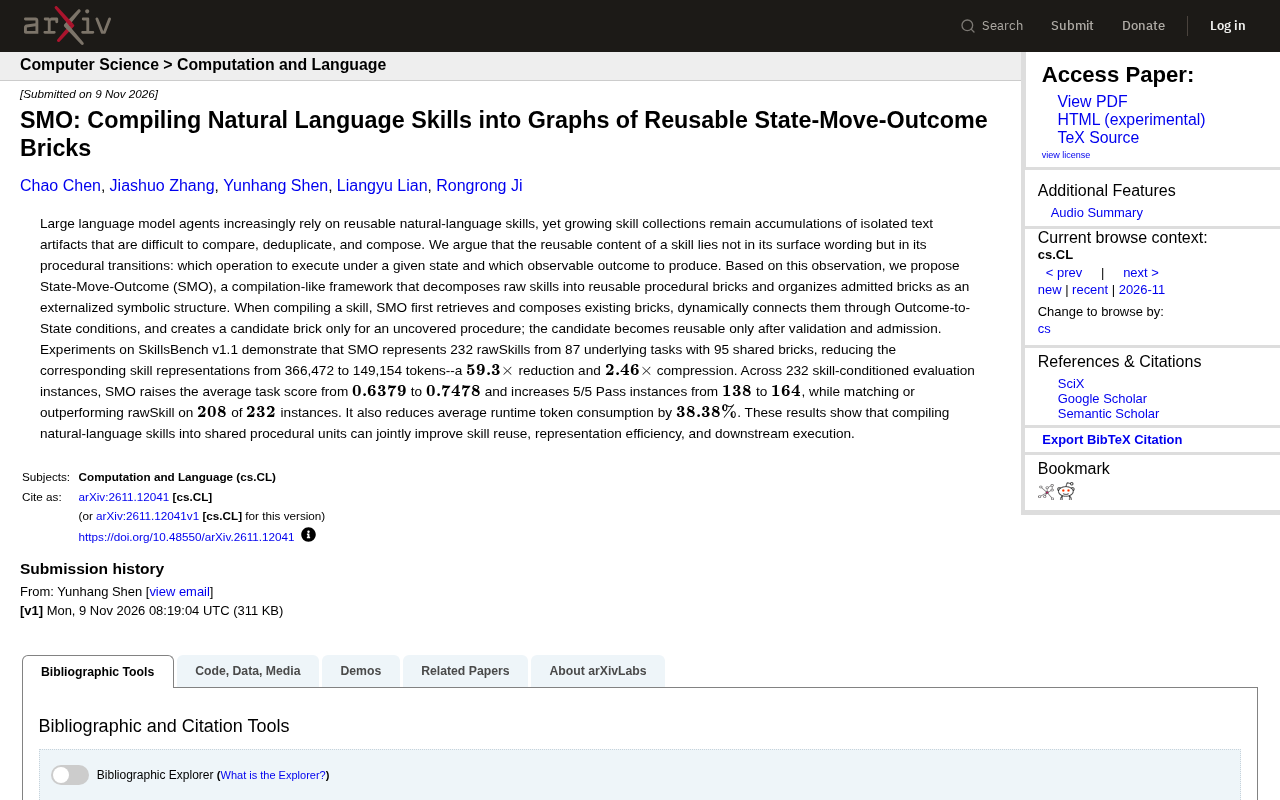
SMO框架:将自然语言技能编译为可复用图结构
SMO框架将自然语言技能编译为状态-动作-结果砖块图,在SkillsBench v1.1上实现59.3倍表示缩减,平均任务得分从0.6379提升至0.7478,运行时token消耗降低38.38%。
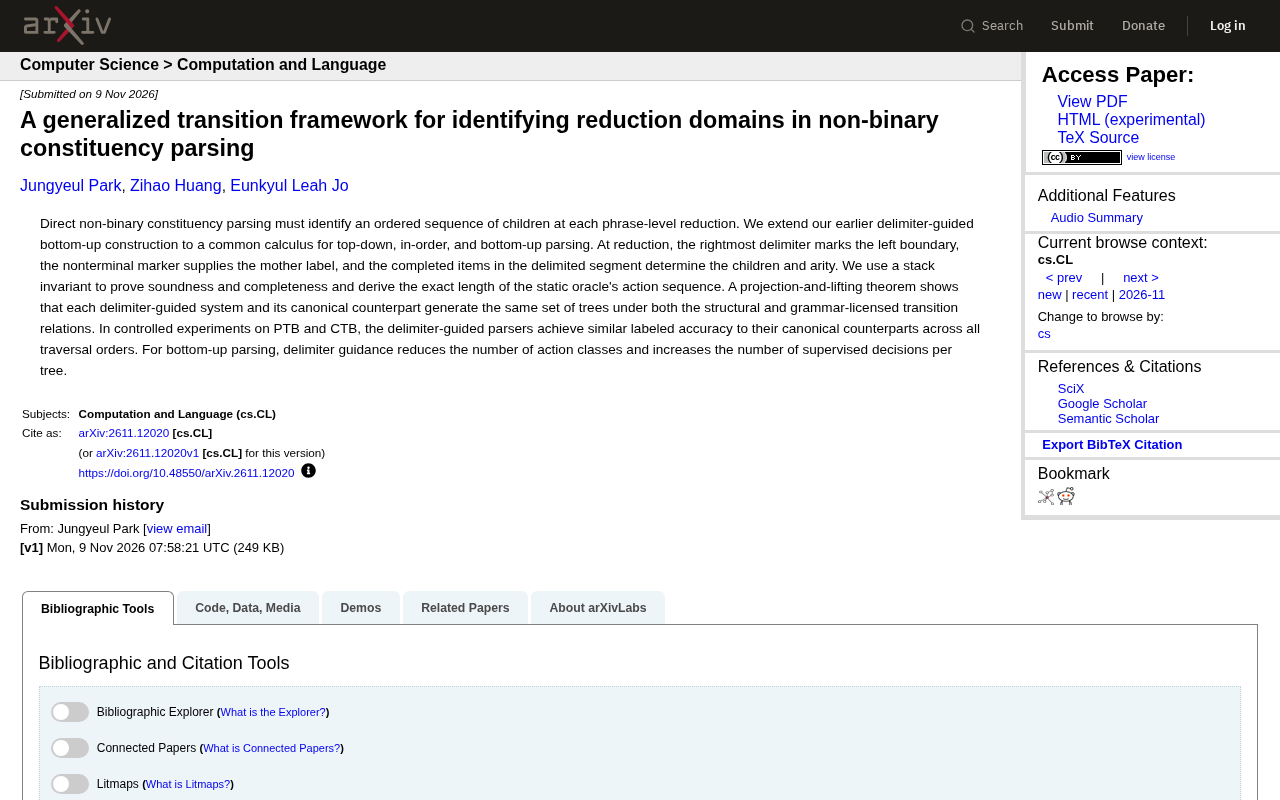
广义转移框架:非二元成分句法分析中的归约域识别
本文介绍一种广义转移框架,用于非二元成分句法分析中的归约域识别,统一了自顶向下、中序和自底向上分析,并在PTB和CTB上验证了有效性。
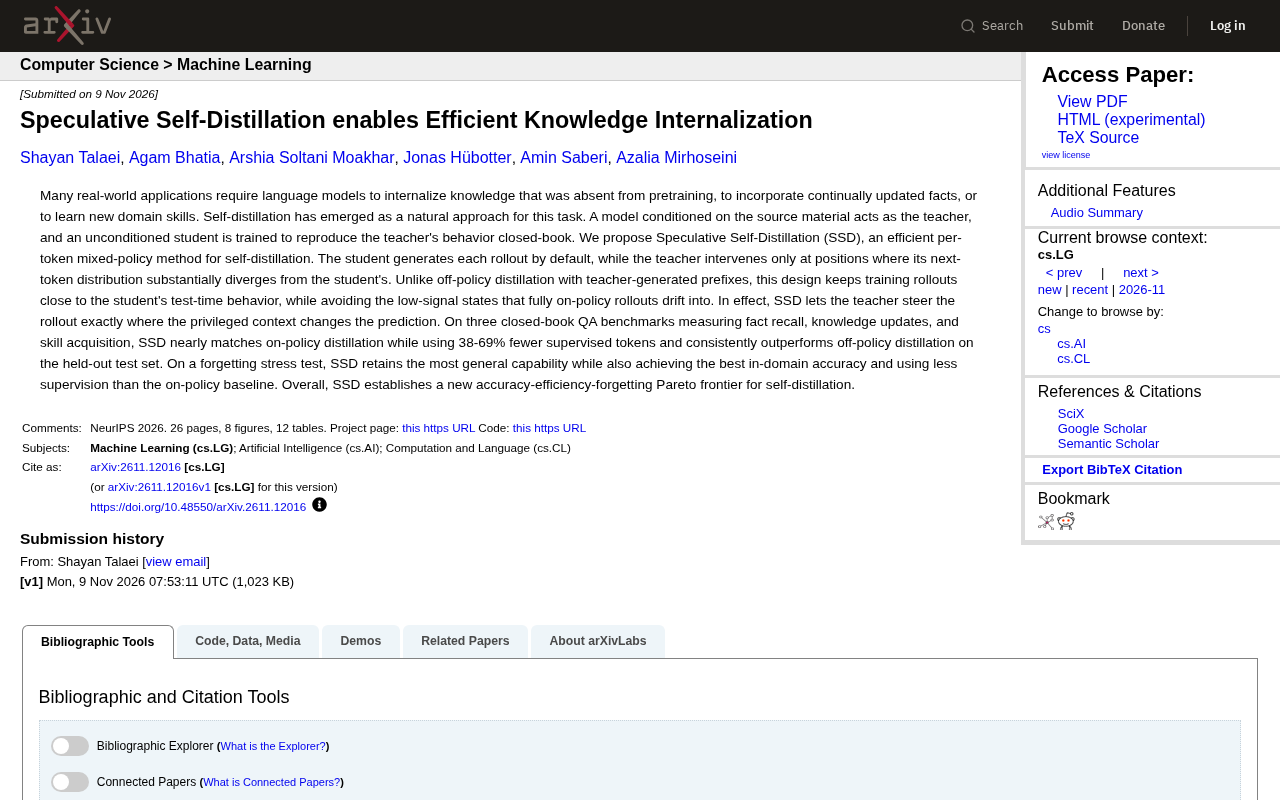
投机自蒸馏:高效知识内化的新范式
投机自蒸馏(SSD)通过逐token混合策略,让教师仅在学生预测显著分歧时介入,在减少38-69%监督token的同时几乎匹配全策略蒸馏性能,并在遗忘测试中表现最佳,为知识内化设立新帕累托前沿。
RDS-MOPD:用鲁棒优化破解多教师蒸馏的域分配难题
多教师在线策略蒸馏中,按学习进度分配预算无法保障落后领域。本文解读 RDS-MOPD 如何用分布鲁棒优化优先最差领域,并通过噪声阈值、异常界约束和最坏情况重定义三处改动解决信号噪声问题。

EmoHarness:元框架进化提升小模型多模态情感理解
EmoHarness 通过外挂框架组织视觉、转录和韵律证据,显著提升小模型多模态情感识别率。实验显示音频证据贡献主要增益,而元框架进化效果有限。

当音视频误导AI:多模态情感识别鲁棒性审计
一项多模态情感识别审计发现:Omni模型加入真实音视频可提升准确率,但无关音视频替换在全部18组比较中显著降低准确率,揭示模型对误导性输入的脆弱性。

Infrathon基准:AI智能体长周期优化真实基础设施
Infrathon基准评估语言智能体在真实AI基础设施上的长周期优化能力,发现模型排名随评估周期变化,智能体可超越人类设计基线,并揭示任务违规、测试不可靠等持续改进障碍。

CHO-Bench:上下文提示如何影响LLM广告排名?
CHO-Bench将LLM广告中的上下文提示设计定义为优化问题,通过超119万次配对评估发现:上下文提示能提升广告排名,但嵌入与LLM排序器偏好不同信息维度,且提示预算存在边际递减。

自闭症大脑语言处理:跨模态神经影像元分析揭示左偏侧化减弱
一项整合45项fMRI和PET研究的元分析发现,自闭症大脑使用相似的左偏侧化语言网络,但左侧化减弱,左侧perisylvian皮层活动降低、右侧颞极活动增强,且口语与书面语、儿童与成人之间存在差异。

BharatSynthQA:印度寺庙遗产问答数据集,LLM表现如何?
BharatSynthQA是一个聚焦印度寺庙与宗教遗产的问答数据集,包含近10万问答对,揭示当前LLM在该领域知识薄弱,提供源段落时F1从0.18-0.30提升至0.73-0.77,支持文化 grounded QA与RAG研究。

GOPR-CAD:操作图渐进推理实现高精度文本到CAD生成
GOPR-CAD提出操作图渐进推理方法,让语言模型作为决策代理构建CAD操作图,再由确定性编译器生成模型,在MHCAD基准上达到82.7%结构良率,显著提升文本到CAD的结构保真度。

让传播器学会排序:学习式优先级提升约束求解效率
一项研究将约束编程中传播器优先级分配建模为学习排序问题,使用自注意力模型和运行时偏好训练,在XCSP3基准上使Choco求解器多解20个实例,中位运行时间降低27.93%。

RealEmbedBench:大模型在嵌入式应用层开发中的真实表现
RealEmbedBench 基准包含 5,142 个样本,评估大语言模型在嵌入式应用层代码生成、状态机建模与跨系统翻译中的真实表现,揭示上下文影响与翻译方向性差异。

OPD容忍多大的训练-推理不匹配?实证预算与FP8加速方案
本文解读OPD对训练-推理不匹配的容忍度研究:量化、异步rollout带来的mismatch存在经验预算,OPD比RL更稳定,并给出FP8配方与准入检查实现1.62倍加速。

通用AI智能体能否读懂手术场景?新基准给出答案
新研究提出两阶段框架评估通用多模态大模型的手术场景理解能力,SurgKnowBench基准揭示关系与流程理解短板,SurgAgentGym智能体环境显示推理增强仅对感知任务有效。

Claude Fable 5.2 设计PCB?三款原型引热议
Anthropic 称 Claude Fable 5.2 与 Diode Computers 合作设计了三款可工作的电子原型。本文拆解 claude pcb design 研究中的厂商报告成分,分析哪些结论可验证、构建者如何自行测试 AI 的 PCB 设计能力。

一句提示词让AI重构代码:Claude 5.2所有权机制揭秘
Anthropic 文档揭示 Claude 5.2 的所有权提示机制:声明代码归属可将重复代码合并概率从不到十分之一提升至约一半,本文解析其原理与开发者实践启示。