#开源工具
共 11894 篇相关文章

Claude Code 终于支持 AGENTS.md:AI编程配置走向标准化
Anthropic 为 Claude Code 增加 AGENTS.md 支持,AI编程工具的项目配置正走向标准化。本文解析这一变化对开发者协作与工具互操作性的实际影响。
Yue2 音乐模型 LoRA 实测:400 步复刻名人音色
一个基于 Yue2 音乐模型、用 AI-Toolkit 仅 400 步训练出的名人音色 LoRA 在 Reddit 走红。本文解析其技术意义、效果局限与背后的音色克隆版权伦理问题。
低显存本地大模型对决:Bonsai 2量化版为何胜出
Reddit 用户在 RTX 5090 上横评 Bonsai 2 27B、Gemma 4 12B 与 Qwen 3.5 9B。基于三元量化的 Bonsai 用 7.2GB 显存实现更优的日式体素宝塔渲染效果,展现低显存本地大模型的量化新趋势。

ComfyUI适配新模型引热议:疑似Krea 2带图像编辑能力
Reddit社区热议一款支持文生图与图生图的新图像模型,kijai正为其开发ComfyUI适配。讨论聚焦VAE架构、7B参数规模及显存占用,疑似为带图像编辑能力的Krea 2。

Claude Code v2.1.277更新解析:新增AGENTS.md支持与大量稳定性修复
Claude Code v2.1.277版本更新详解:新增AGENTS.md配置文件支持、企业网关代理能力,并修复大量崩溃、挂起及Edit/Grep等工具问题,同时强化子代理安全与VS Code、Web端体验。
x86模拟的困境:ARM设备运行x86程序为何如此艰难
FEX-Emu团队深度剖析ARM平台上模拟x86架构的技术困境,涵盖内存模型差异、标志位处理、浮点精度等核心难题,解读x86到ARM二进制翻译背后的工程挑战与行业趋势。
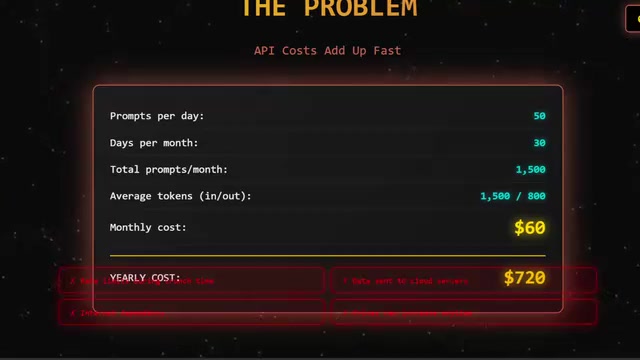
Qwen 27B 本地部署实测:开源大模型能否替代 GPT-4?
Qwen 27B 开源大模型本地部署实测:一条命令用 Ollama 安装,混合注意力支持 262K 长上下文,代码审计任务响应快于 GPT-4,三年成本对比显示本地方案更省钱。开发者本地 AI 部署完整指南。
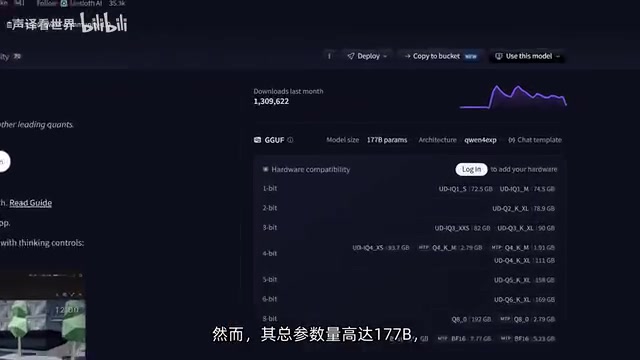
177B大模型跑在廉价显卡上?Qwen3 Flash Next本地部署实测
B站UP主实测用两块廉价显卡加32GB内存本地运行177B参数的Qwen3 Flash Next模型,通过将51B Ngram表卸载到SSD,实现22 tokens/s推理速度。本文解析其架构拆分、llama.cpp部署参数与性能表现。
MiniMax H3登陆Draw Things:Mac/iPad本地跑开源最强音视频模型指南
开源最强音视频模型MiniMax H3已在苹果AI工具Draw Things正式支持。本文详解首尾帧与参考生成两种版本、加速LoRA选择、M系列芯片硬件门槛及LLM提示词技巧,帮Mac/iPad用户判断能否本地运行。

Herder:像高手一样管理多智能体的开源终端复用工具
Herder 是一款面向 AI Agent 的开源终端复用工具,相当于加了 Agent 支持的 tmux。支持会话持久化、状态指示、CLI 编程控制与 SSH 远程连接,让你像高手一样并行管理 Claude Code、Codex 等多个 AI 编程 Agent。

Unsloth v0.1.811发布:Docker多用户与AMD ROCm支持全解析
Unsloth v0.1.811-beta 正式发布,带来全新 Docker 镜像、多用户账户隔离、AMD RDNA1/2 ROCm 支持及 FP8/INT8 扩散推理提速。本文解析这款开源大模型微调工具的核心更新与实际价值。
无需框架:用Python+Ollama打造本地ReAct AI Agent
不依赖 LangChain 等框架,用纯 Python 配合本地 Ollama 从零打造具备工具调用能力的 ReAct AI Agent。100% 本地运行、无需 API 密钥,深入理解智能代理的推理循环与消息管理机制。
海外博主实测DeepSeek新Flash模型:KV缓存效率暴涨337倍
海外博主实测DeepSeek新Flash模型,KV缓存效率相比V1提升337倍。文章详解其架构重构、视觉生成、原生目标检测与AutoML能力,以及harness选择对性能的关键影响与实际适用场景。
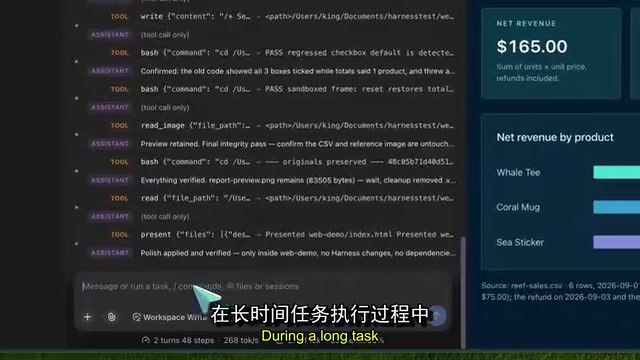
DeepSeek V4.1 Flash编程工具实测:原生图像与缓存复用大升级
DeepSeek V4.1 Flash编程工具链迎来重大升级,新增原生图像输入、缓存复用优化、文件预览与智能体控制。本文详解开源Harness架构、安装配置及两个实测案例。

本地大模型运行器怎么选?五大工具横评指南
llama.cpp、Ollama、LM Studio、vLLM 和 Lemonade Server 五大本地大模型运行器全面对比。搞懂模型文件、量化和显存三个概念,按硬件和场景选对工具,附完整决策路径。

给DeepSeek Harness装记忆:OpenViking实测Token降91%
字节开源上下文数据库OpenViking为DeepSeek Harness补齐跨会话记忆,采用L0/L1/L2三层加载,官方实测Token降34%~91%,本文含真实机器实测数据与接入方式。

MiniMax Code CLI 开源:与 DeepSeek Harness 有何不同?
MiniMax Code CLI 在 GitHub 正式开源,本文对比它与 DeepSeek Harness 的核心差异:一个是集成终端工作台、支持多模态接入,一个是万物可替换的组装框架并优化前缀缓存,帮你选出适合的 AI 编码工具。
本地运行AI模型全指南:从原理到四种实操方式
一篇通俗的本地运行AI模型完整指南:讲清模型文件、量化、推理引擎与硬件四大核心模块,并演示LM Studio、Ollama、Docker Model Runner和纯代码四种运行方式,帮你在自己电脑上跑起第一个大模型。

