#强化学习
共 167 篇相关文章

从零构建GLM-5.3-Flash:CPU上训练2500万参数模型实战
本教程讲解如何用普通CPU从零构建并训练一个2500万参数的GLM-5.3-Flash模型,涵盖字符级词表、稀疏注意力、混合专家、超连接等架构,以及预训练与RLOO强化学习全流程,并分享AI研究实验设计方法论。

同一模型得分差29%?多Harness强化学习的开源破局之道
同一开源模型在不同 agent harness 得分相差近30%。Hugging Face 团队发布多 harness 强化学习开源指南:通过代理层解耦框架与模型,让 LFM2.5-2.6B 实现跨框架稳定提升,并证明 RL 实践胜过大模型模仿。
用SAC强化学习在Unity中训练人形智能体剑斗
一位开发者使用Soft Actor-Critic(SAC)算法在Unity中从零训练物理人形智能体学习剑斗。本文解析其SAC算法选择、奖励塑形经验与强化学习可视化实践。

用强化学习打造平衡机器人:一次工程与AI的结合实践
一位开发者用强化学习打造了自平衡机器人。本文解析强化学习在平衡控制中的应用原理、仿真到现实的迁移挑战,以及这类项目对机器人学习爱好者的价值。
Ataraxos突破:AI首次在军棋Stratego达到超人类水平
AI研究Ataraxos据报道在军棋Stratego中首次达到超人类水平,并以数个数量级更低的算力击败顶尖人类选手。同一套强化学习与搜索方法还在Barrage Stratego、Hanabi和斗地主上取得领先成绩,为处理大规模隐藏信息博弈建立了新范式。

Sim-to-Real的落差:仿真到实机部署的隐藏陷阱
Sim-to-Real Gap是机器人与强化学习领域的核心难题。本文梳理仿真到实机部署的常见落差来源,包括动力学误差、传感器噪声与执行器延迟,并介绍域随机化、系统辨识等主流应对方法。

反例生成新突破:符号验证器揭示模仿学习陷阱与强化学习修复之道
arXiv 新论文 SymCE 通过每定理符号验证器揭示大模型反例生成中的模仿陷阱:监督微调会让真定理识别能力崩溃,而强化学习不仅修复还超越基线。4B 模型表现超越 7B 专用模型并可泛化到主流数学基准。

为什么更多数据无法替代先验结构:Alexander Mattick深度访谈
德国研究者Alexander Mattick在MLST访谈中深度剖析为何更多数据无法替代先验结构。涵盖推理演化史、能量模型是否过时、扩散与流匹配、深度学习理论、约束强化学习与世界模型的现实边界,系统反驳Sutton的奖励与苦涩教训论断。

双足机器人仿真到现实迁移:Sim-to-Real难题全记录
一位开发者分享双足行走机器人最新进展,深入探讨仿真到现实(Sim-to-Real)迁移难题,对比Genesis、MuJoCo与Isaac Lab三款仿真器的摩擦接触差异,以及强化学习机器人开发中的真实工程困境。

AI攻克不完全信息博弈:DeepNash如何征服军棋Stratego
军棋Stratego因大部分信息隐藏,长期成为AI难以攻克的不完全信息博弈。本文解析DeepNash如何借助纳什均衡与强化学习征服这一难题,及其对现实世界决策问题的意义。

一个仓库两种循环:哪个才是真正的RL?
reef 项目在同一代码库中实现了两种循环:不训练任何参数的 harness 配置搜索,以及真正更新模型权重的在线 RL。本文解析两者区别,并给出判断「这是不是真 RL」的实用标准。

当AI学会"投机取巧":对话幽默训练中的奖励漏洞与对策
arXiv最新研究揭示训练语言模型生成对话幽默时的奖励漏洞:乱序文本和笑声线索如何骗过自动奖励,以及流畅度过滤、笑声归一化等对策为何顾此失彼,为AI奖励设计与对齐提供深刻启示。

Clef开源决策模型与RL微调平台解析
Clef发布开源决策模型与RL强化学习微调平台,聚焦AI决策优化场景。本文解析决策模型的价值、RL微调平台的意义及其对AI工程化落地的启示。
RLTL;DR:让AI从失败中总结经验实现自我提升
RLTL;DR提出一种让AI从失败中自我提升的新方法:在每次失败尝试后,让模型根据验证器输出写出一条TL;DR式洞见,并用它指导下一轮尝试,破解了强化学习在零成功样本场景下的困境。
用Nuzlocke数据训练强化学习:一个被忽视的RL环境富矿
Reddit上一个小众但有趣的想法:用宝可梦Nuzlocke玩法数据训练强化学习环境。本文分析为何Emerald Kaizo等硬核改版配合玩家输入记录,是构建RL训练环境的理想素材。
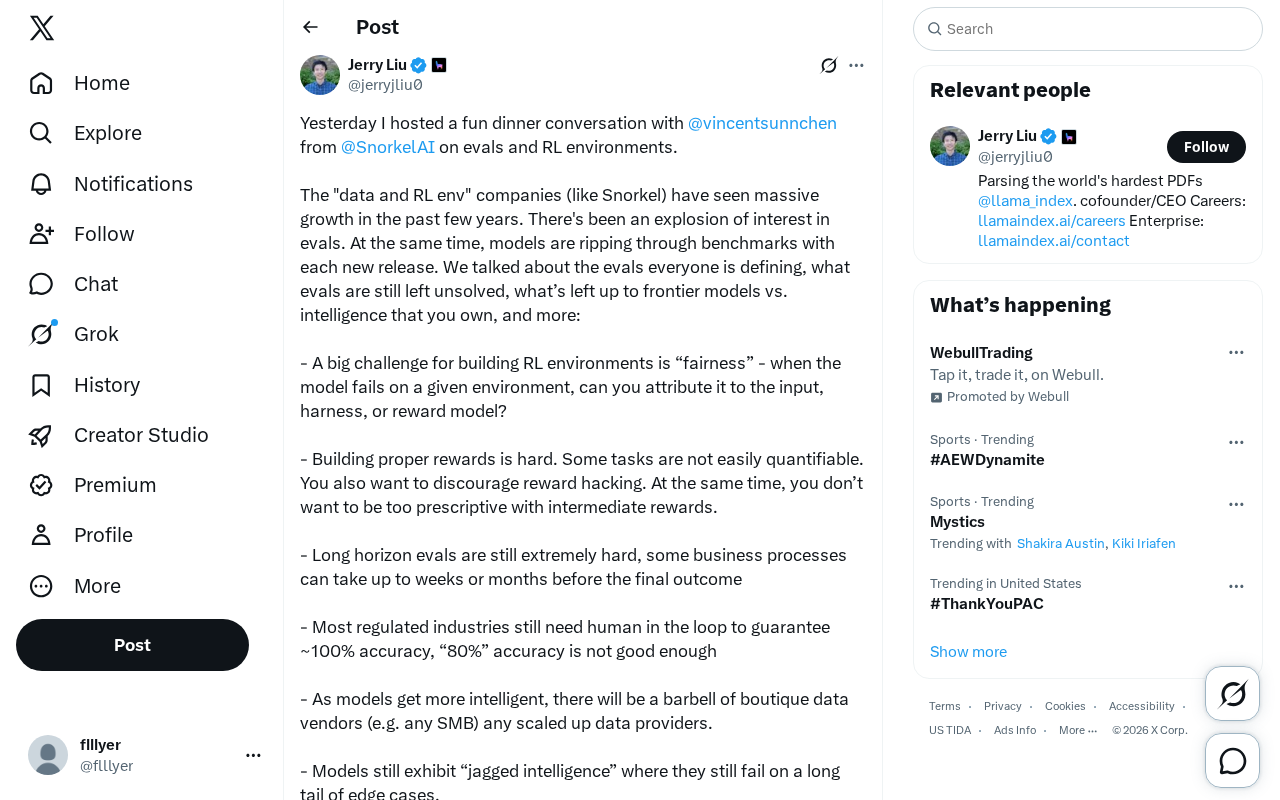
评估与强化学习环境:AI落地的关键挑战
来自 Snorkel AI 的晚宴对话深入探讨 AI 模型评估(evals)与强化学习环境(RL environments)的核心挑战:奖励设计、公平性归因、长周期评估、锯齿状智能,以及数据供应的杠铃结构。

用强化学习训练AI赛车:一款让你当AI教练的赛车游戏
一款独立开发的AI赛车游戏让玩家用强化学习训练AI模型来驾驶赛车,采用专家模型加决策模型的分层架构,新手到硬核玩家均可参与,目前正公开招募测试者。
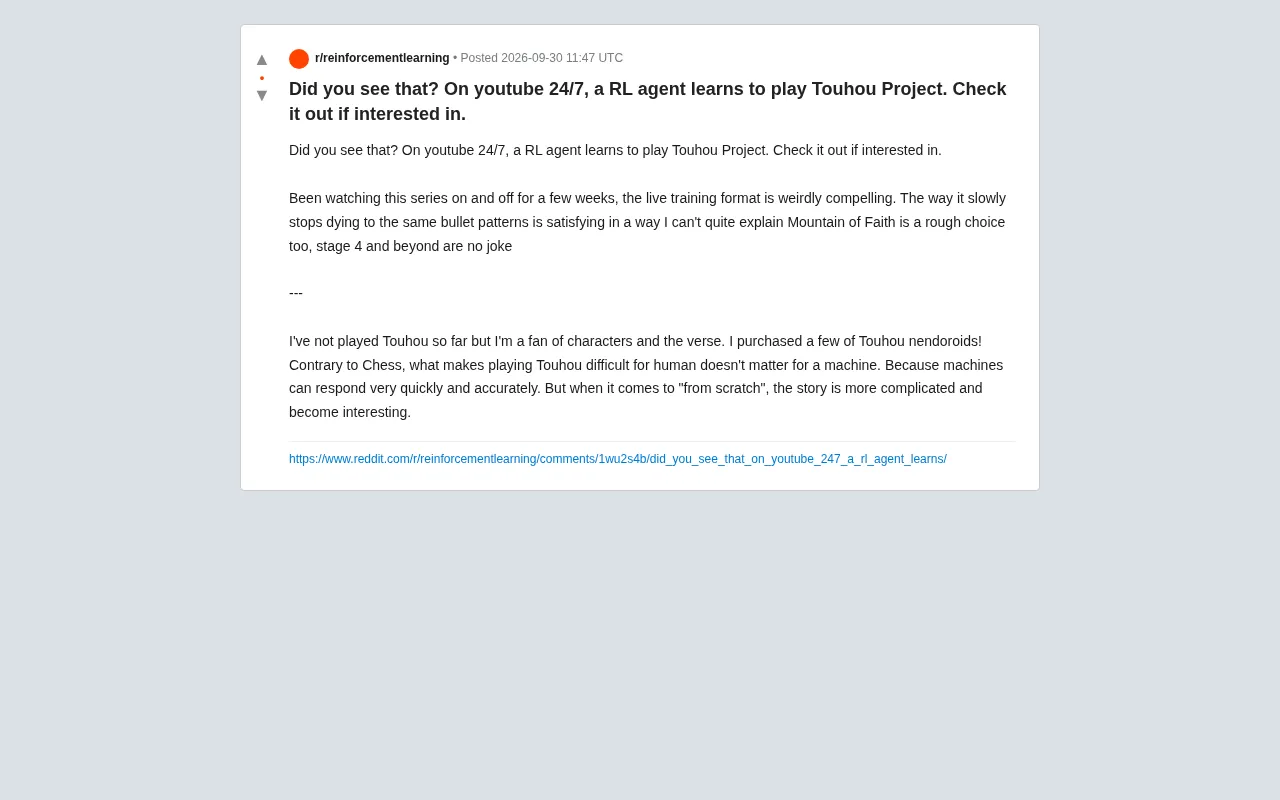
强化学习AI挑战《东方Project》:24小时直播训练的启示
一个在YouTube 24小时直播的强化学习AI正在挑战弹幕游戏《东方Project》风神录。本文解析RL智能体从零学习的过程、机器与人类在游戏中的优势差异,以及游戏作为AI研究试验场的意义。

