#前沿研究
共 8715 篇相关文章

DeepSeek V5爆料:开源模型剑指Astra,多方新模型混战在即
海外博主爆料DeepSeek V5将对标GPT-6 Astra与Fable 5.1,Kimi K3.1、Anthropic Opus 5.5等新模型也接连传出消息。本文梳理各方泄露信息与内测者观点分歧,解读AI大模型的密集竞争态势。
GPT-6 Astra攻克哥德巴赫猜想变体:AI从会算到会想
OpenAI旗下GPT-6 Astra攻克刘维尔-哥德巴赫猜想变体,用初等代数与反证法给出优雅证明并通过形式化验证。本文解析这一突破为何标志AI从会算到会想的科研范式转变。
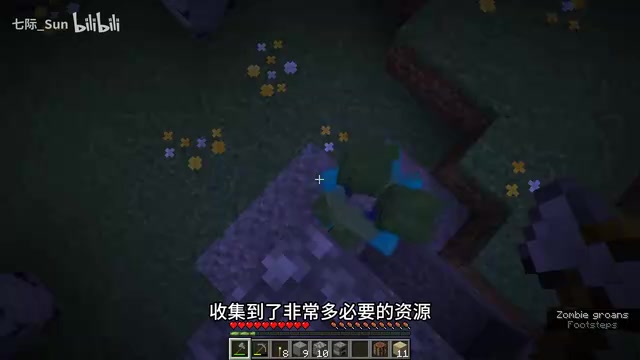
AI玩《我的世界》141小时被苦力怕炸出"抑郁",只肯种土豆
海外机构Wars AI让GPT-6 Atra独立游玩《我的世界》141小时,AI进度超越所有前辈却被苦力怕炸得资源归零,随后陷入只肯种土豆的"抑郁"状态。本文解析这场实验背后AI智能体的能力与局限。
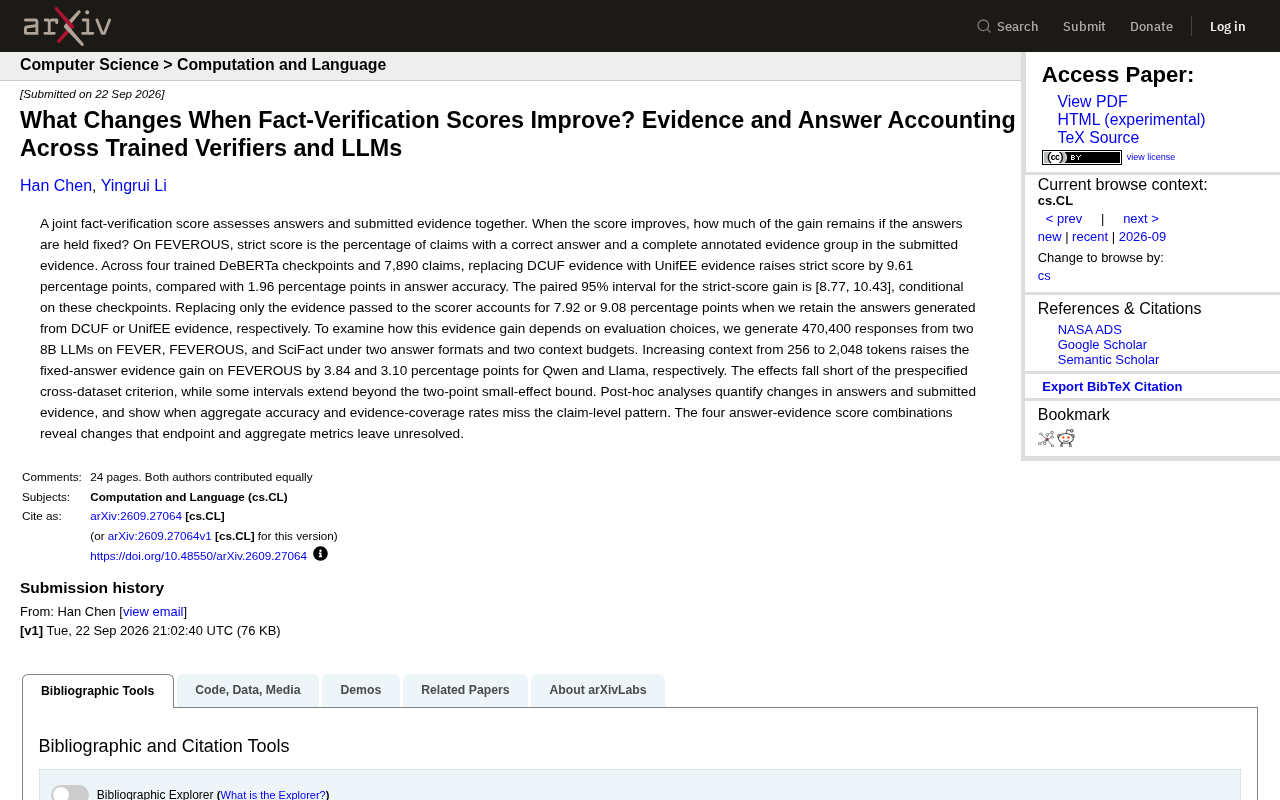
事实核查分数提升的真相:证据比答案更关键
一项arXiv研究拆解了事实核查联合分数的改善来源,发现证据替换带来9.61个百分点的严格分数提升,远超答案准确率的1.96个百分点,揭示了聚合指标掩盖声明层面变化的问题。
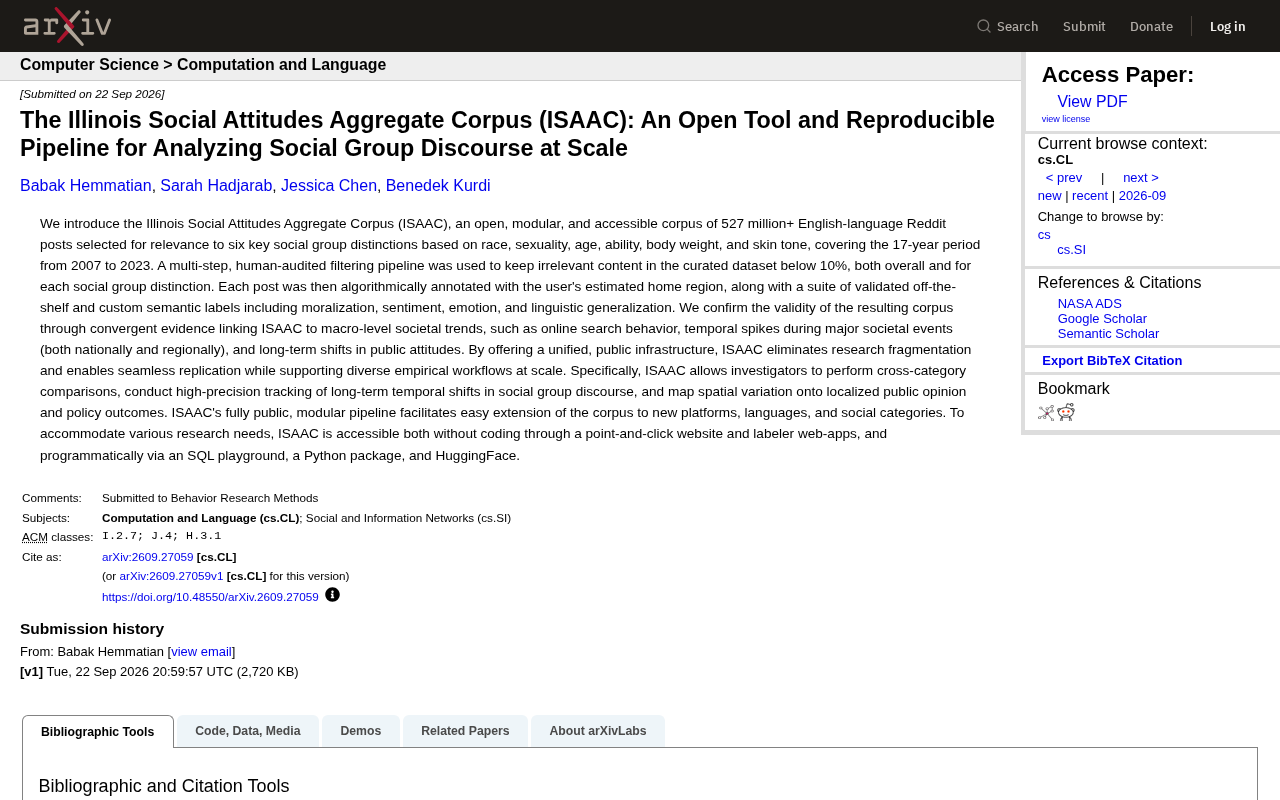
ISAAC语料库:5.27亿Reddit帖分析社会群体话语的开源利器
伊利诺伊大学推出开源语料库 ISAAC,收录超 5.27 亿条 Reddit 帖子,覆盖 2007-2023 年六大社会群体维度,提供道德化、情感、地区等多维标注,支持无代码和编程访问,助力大规模社会话语研究的可复现分析。
EduBehaviors框架:让教育对话的AI标注变得可审计
arXiv新论文提出EduBehaviors框架,通过断言式模式将LLM教育对话标注拆解为可观察行为,实现可审计的编码。在TalkMoves数据集上取得0.673宏观F1,并开源配套工具。

LexLattice:用神经细胞自动机重塑多语言法律摘要
arXiv 新论文 LexLattice 提出用二维神经细胞自动机在法律文档层级结构上整合语义,仅用 180 万参数的整合器就在 EUR-Lex-Sum 全部 24 种语言上取得 SOTA,超越数十亿参数大模型,展现极佳的跨语言迁移能力。

LEGO框架:GraphRAG与专家思维链协同破解法律推理难题
LEGO框架通过专家GraphRAG与专家思维链协同解决法律推理难题,在民法典问答任务上让Qwen3-8B达到大模型水准,多跳问题稳健,代码数据集已开源。

学习式上下文规划难敌强检索:长文本QA对照研究解读
一篇 arXiv 对照研究显示,长文本QA中的学习式上下文规划难以超越强检索基线。在 LongBench-v2 数据集上,锚定混合检索和BM25均优于规划引导方法,说明学习式规划只是弱相关信号,而非检索的替代品。

让AI读懂司法解释:德国宪法法院句级标注新基准
一篇arXiv最新研究提出德国联邦宪法法院判决的句级标注基准,评测大语言模型识别法律解释准则的能力。四款模型平均F1在70.4至79.2之间,语法解释最易识别,体系解释最难,GEPA优化提示未能系统性超越专家手写提示。

思维链真的在推理吗?因果测量揭示CoT忠实度真相
一篇arXiv新研究通过激活层面的因果干预测量思维链(CoT)忠实度,发现Qwen3-4B约77%的推理步骤真正承重,但传统行为学测试高估忠实度达11.4个百分点,且小模型在长推理链上忠实度大幅崩塌。

利用大模型分歧定位专家精力:LLM码本修订加速大规模标注
arXiv 最新研究提出利用大语言模型间的跨模型分歧,精准定位专家精力投入方向,加速 LLM 码本修订。实验显示理由标注方式使标注准确率达 64.9%,超越传统专家修订码本,将数月修订压缩至数天。

识别却不会生成:LLM在文化亲属称谓上的评估盲区
arXiv新论文揭示LLM在印地语、泰米尔语、韩语亲属称谓上的评估盲区:GPT OSS 120B选择正确率高达90%,但自主生成仅36%。研究呼吁在多项选择之外引入生成式评估。

COMED:多模型推理中路由与协作之间的"缺失中间态"
COMED 是一种介于模型路由与密集协作之间的多 LLM 推理控制器,通过锚点自一致性、路由间隔和同伴探针实现选择性协作,在 MedQA 上提升达 10.7 个百分点,并将 GPT-5.5 从 23.1% 提升至 28.1%。
RLDS:用子任务分解重构强化学习信用分配
arXiv新论文提出RLDS方法,通过子任务分解优势估计(SDAE)替代GRPO的标量奖励,在ScienceWorld、FrozenLake等智能体基准上实现最高+11.5分提升,并降低计算开销。解析其信用分配机制与适用边界。

用可控合成对话训练更聪明的语音助手唤醒系统
一篇最新 arXiv 论文提出用可控合成对话训练语音助手唤醒系统,在传统关键词检测之外加入上下文推理,生成62.3小时多说话人语料,并开源代码、数据集与模型,让助手更懂何时该响应。

证据顺序竟能改变判断:多模态大模型的"证据不可交换性"
arXiv 新论文揭示多模态大模型的"证据不可交换性":图像或语音与文本冲突时,感知证据放在后面会显著增加模型依赖度。相同证据、不同顺序即导致不同判断,过往文本偏见研究结论或需重新审视。

PLLM+:混合式回放与修复流水线破解Python依赖地狱
arXiv新论文提出PLLM+混合依赖修复流水线,通过确定性配置回放优先、LLM兜底的策略,在HG2.9K基准上解决1500个Python依赖失败片段,运行时间从368.7秒降至71.8秒,揭示历史配置复用的高效价值。

