#前沿研究
共 8755 篇相关文章
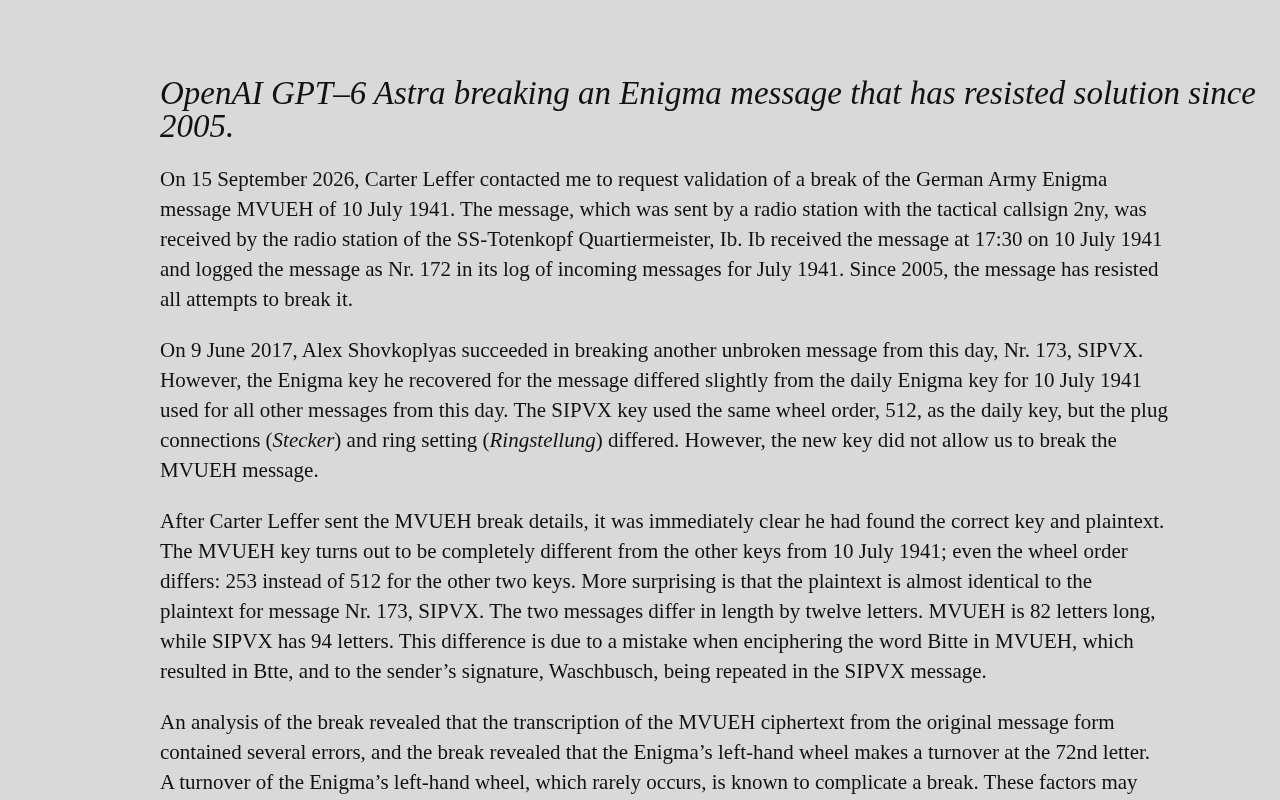
GPT-6 Astra破解2005年悬而未决的恩尼格玛密码?
有消息称OpenAI的GPT-6 Astra破解了一条自2005年以来悬而未决的恩尼格玛密码。本文分析该声明的技术可能性、大语言模型在密码破译中的角色,以及为何应保持理性审慎。
训练OpenAI的AI因用AI训练AI被解雇:一场荒诞的循环
为OpenAI提供AI训练数据的标注员因使用AI工具辅助工作被解雇。这一荒诞事件折射出RLHF人类反馈的真实性危机、模型坍缩风险与数据标注产业的结构性困境。
小米开源MiMo-V2.6:全模态智能与公开训练的野心
小米开源全模态模型MiMo-V2.6,Pro与Flash双版本支持文本、图像、音频、视频与100万token超长上下文,面向长周期智能体任务,并同步开放技术报告、RL环境与训练代码。
NVIDIA DLSS 5发布:3D引导神经渲染与RTX Kit新能力解析
NVIDIA发布DLSS 5,引入3D引导神经渲染技术,配合NVIDIA ACE更新与RTX Kit新能力,为游戏开发者提供更逼真的光照材质与更精细的画面控制。本文解析这次更新的技术要点与行业意义。
别被AI炒作迷惑:最新突破与恐慌或许言过其实
DAIR执行主任Timnit Gebru与语言学教授Emily M. Bender指出,AI最新突破与末日恐慌可能更多是炒作而非现实。本文剖析AI炒作叙事背后的逻辑与真实问题。
AI智能体正在吞噬开源?开源生态的生存之问
AI编程智能体正在改变开发者使用开源软件的方式,甚至可能取代传统开源库。但这些智能体本身正是靠开源代码训练而来。本文剖析AI Agent与开源生态之间的共生与博弈,探讨开源在AI时代的生存之路。
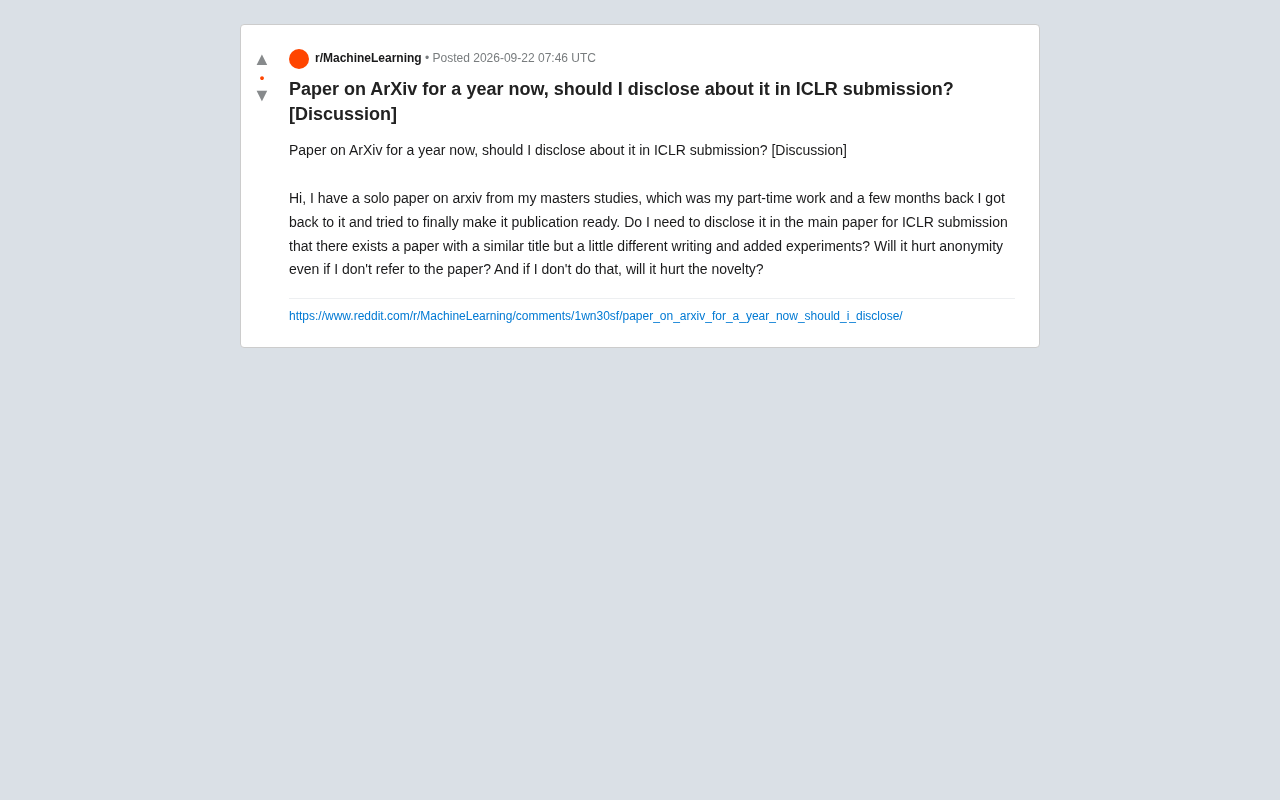
ArXiv预印本与ICLR双盲评审:该不该披露一年前的旧稿?
一年前挂在 arXiv 的预印本,投稿 ICLR 时该不该披露?本文解析 ICLR 双盲评审政策、匿名性风险与新颖性认定,给出用第三人称引用旧稿等实用建议。
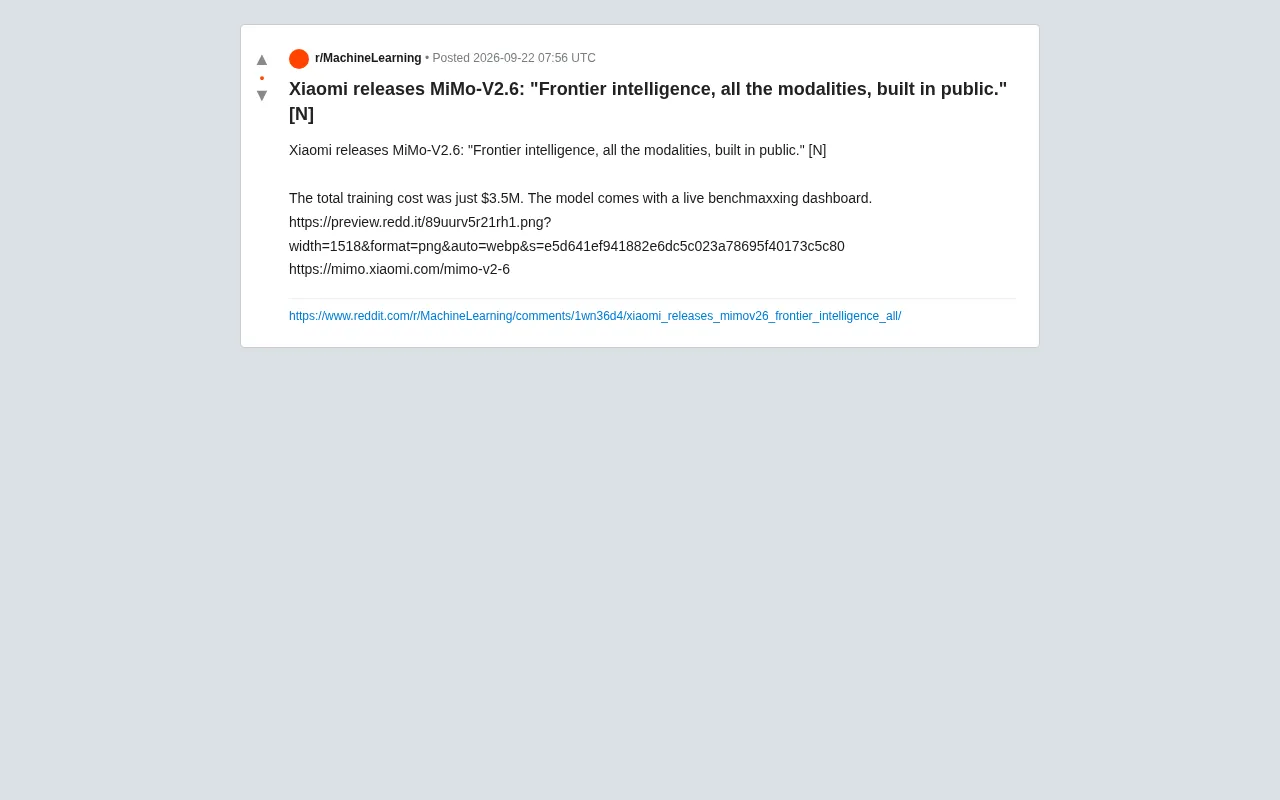
小米发布MiMo-V2.6:350万美元打造的全模态开源模型
小米发布多模态大模型MiMo-V2.6,主打前沿智能、全模态与公开构建,总训练成本仅350万美元,并配备实时评测仪表盘。本文解析其成本、定位与生态意义。
Jev:TypeSafe AI首个System 1模型,专为数据分类而生
TypeSafe AI推出首个System 1模型Jev,专注数据分类而非文本生成。它以70-500毫秒完成分类、输出token免费、格式绝不出错,速度比传统LLM快40-200倍。本文解析Jev的定位、能力边界与被夸大的误用场景。

上下文投毒:长上下文模型为何被干扰信息拖垮
arXiv 论文提出"上下文投毒"概念,将长上下文语言模型的性能退化解释为注意力中的极值干扰,指出有效干扰项数量而非原始长度才是关键,并给出证据边际需按 √logN 增长的理论边界及多种缓解方案。
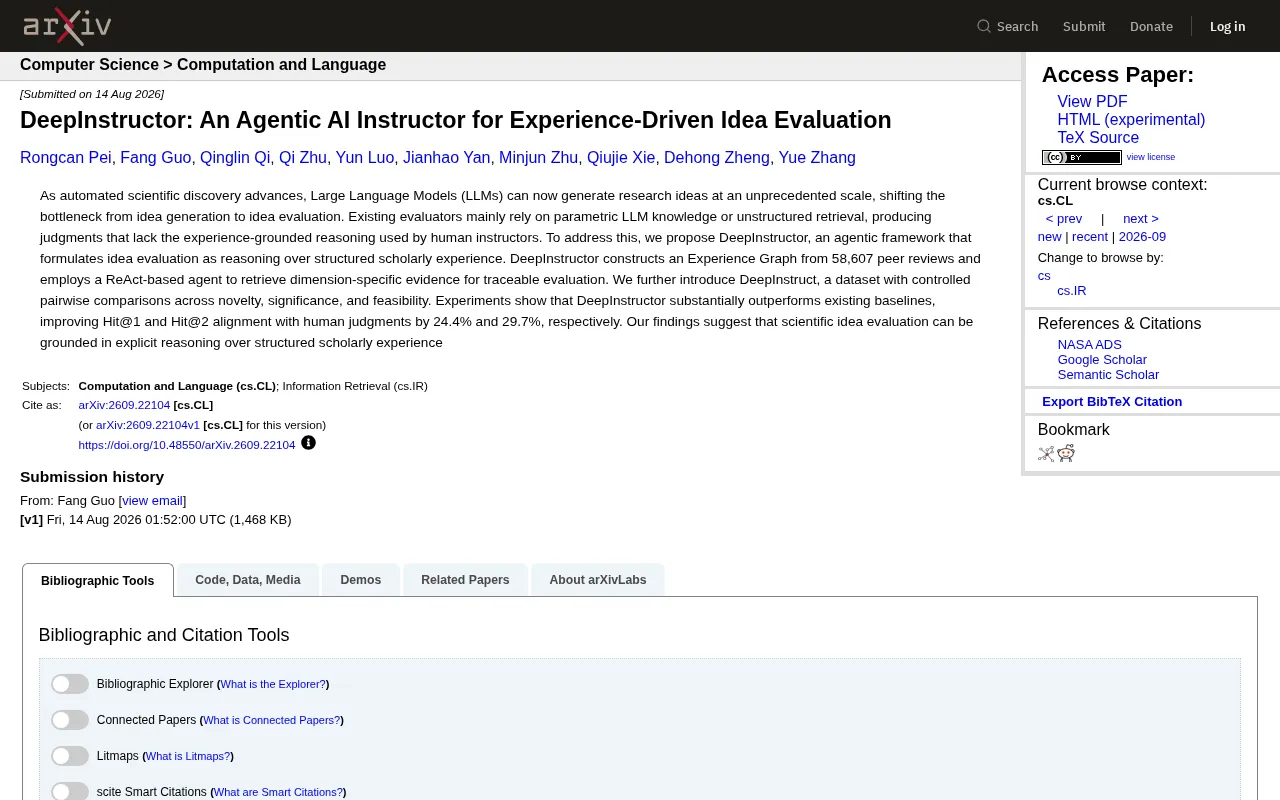
DeepInstructor:用结构化学术经验驱动科研创意评估的智能体框架
arXiv 论文提出 DeepInstructor,一个基于经验图谱和 ReAct 智能体的科研创意评估框架,利用 58607 条同行评审构建结构化经验,在与人类判断对齐度上 Hit@1、Hit@2 分别提升 24.4% 和 29.7%。
RecipeDB2:让菜谱变得可计算的结构化数据框架
IIIT-Delhi 研究团队推出 RecipeDB2,收录 128,942 份菜谱、35,474 种食材,通过 Transformer、BERT 与随机森林等技术将菜谱转化为可计算的结构化数据,链接 USDA 营养数据库并标注地理文化背景,为食品计算研究提供基础设施。
AdaMem:让RAG按相关性智能分配记忆token的软压缩新方法
AdaMem 是一种相关性引导的 RAG 软压缩框架,通过查询相关的记忆token动态分配,让高相关段落获得更多记忆预算。在六个问答基准上超越均匀分配基线,64倍压缩下相对增益最高达19.7%,推理延迟降低4倍。

CLIC框架:用Token频率解码大模型的编程行为差异
arXiv新论文提出CLIC框架,通过token频率分析和可解释决策树刻画大语言模型的编程行为差异,并引入鲁棒性与集中度两个新指标。基于10个LLM跨22个Kaggle任务的对比,为模型选型与提示工程提供实操洞见。

TreeSpark:自适应草稿树让推测解码提速8-14%
TreeSpark 是一种面向半自回归草稿器的推测解码优化方法,通过校准的负载自适应草稿树,每轮多接受15-25%草稿token,单请求解码提速8-14%,并在任意温度下保持无损解码。
AI分析36万条推文:气候运动中的"快乐-行动"悖论
一项分析36万条Twitter/X气候活动帖子的AI研究发现"快乐-行动背离"现象:活动期间幸福感语言上升9.02个百分点,但行动语言反而下降10.75个百分点,且更快乐的帖子传播率更低,揭示气候传播的深层悖论。

SJR架构:解耦内容理解与策略学习的多模态内容审核新范式
arXiv论文提出SJR(总结-判断-精炼)架构,通过自然语言接口解耦多模态内容理解与策略分类。在误导广告检测中相对F1提升23.6%,且零真实违规样本即可启动新策略,兼具数据效率与可解释性。
面向未来的记忆检索:零推理成本的前瞻性检索机制
arXiv新论文提出零推理成本的前瞻性记忆检索机制,通过承诺账本让个人记忆系统"看向未来",在困难任务上将recall@5从0提升至0.955,且零误报。