#大模型推理
共 45 篇相关文章

昇腾950PR单卡推理DeepSeek V4-Flash实测:208 TPS并已开源
华为昇腾950PR单卡实测运行裁剪版DeepSeek V4-Flash,128GB显存下解码峰值达208 TPS,支持800K上下文,并已开源。本文解析显存分配、MXFP4/8精度测试与Agent自动适配等关键细节。

AI MAX+ 395部署Qwen3大模型:GFX1151引擎实测优化解析
B站UP主防暴键盘更新GFX1151 engine引擎,针对AMD AI MAX+ 395平台部署Qwen3大模型。本文解析MOE内核优化、HGN/GGUF双格式支持、分页KV与并发能力及本机实测数据。

显卡涨疯了怎么办?统一内存+独显异构加速部署大模型
RTX 5090和Pro 6000显卡价格翻倍,本地部署大模型成本飙升。本文解析统一内存+独显异构加速开源方案,拆解Prefill与Decode分工原理,实测三条路径数据,4万美元跑DeepSeek V4.1 Flash成本降至五分之一。
百万级上下文窗口的工程挑战:VRAM碎片与动态KV缓存
百万级上下文窗口对大模型推理提出严峻的显存挑战。本文解析VRAM碎片化与动态KV缓存两大工程难题,探讨分页式缓存、显存池、分层卸载等架构应对策略。

vLLM v0.30.0 发布:混合注意力与推测解码全面升级
vLLM v0.30.0 正式发布,带来混合注意力热点路径优化、HiSparse 分层稀疏解码、Model Runner V2 推测解码增强、内容水印与 Fast Start 快速启动等多项更新,并新增多款模型支持。

vLLM v0.30.1rc0发布:新增AMD MI355 NVFP4与MoRI内核支持
vLLM 发布 v0.30.1rc0 候选版本,新增对 AMD MI355 加速卡的 dense NVFP4 量化内核与 MoRI 内核镜像支持,进一步扩展 ROCm 生态下的大模型推理能力。
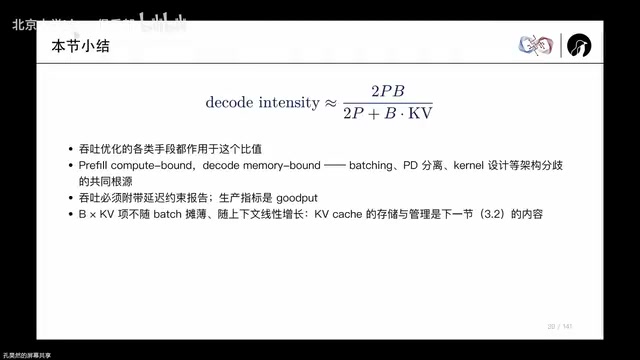
深入LLM推理:从KV Cache到PD分离的Serving全景解析
深入解析LLM推理与Serving技术栈:涵盖KV Cache原理、Prefill/Decode两阶段计算形态、PagedAttention、PD分离、EP并行、投机解码等核心机制,剖析大模型推理系统的关键工程权衡与优化思路。
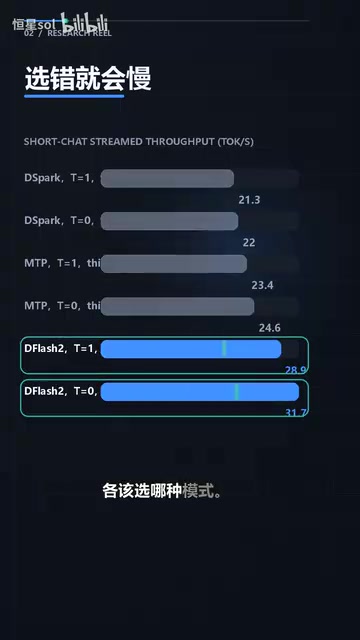
DGX Spark部署Qwen3 27B实测:三种模式怎么选
DGX Spark部署Qwen3 27B实测:D-Spark、MPP、D-Flash2三种模式在代码、短聊、长文场景下的吞吐对比。D-Spark代码51.5,D-Flash2长文25.4、16路并发总吞吐227.6,MIT开源可一行Curl调用。

深入理解大模型推理:为什么生成如此之慢,又该如何加速
深入解析大语言模型推理为何内存受限、生成为何缓慢,系统梳理 KV 缓存、GQA、MLA、状态空间模型、扩散模型、量化剪枝与投机解码等推理加速技术,基于斯坦福大模型课程推理讲座。

vLLM v0.30.0 发布:修复 DeepGEMM CUDA 12.9 构建问题
vLLM v0.30.0 正式发布,核心修复 DeepGEMM 在 CUDA 12.9 环境下的发布构建问题(PR #57554)。本文解析该修复的背景、影响及对大模型推理部署用户的升级建议。

递归语言模型如何实现真正推理:跳出分布外泛化困境
一篇 arXiv 新论文提出反直觉观点:限制语言模型的可见范围反而能提升分布外推理能力。递归语言模型通过上下文隔离排除捷径依赖,挑战了经典学习理论中'覆盖正确规则即可学会'的假设。
vLLM v0.30.0rc2 发布:修复NIXL通知请求处理问题
vLLM 发布 v0.30.0rc2 候选版本,核心修复 NIXL 传输层对通知类请求的处理逻辑,避免冗余接收报告。本文解读该更新内容、NIXL 作用及对分离式推理部署的影响。

SGLang v0.5.20 发布:高性能LLM推理引擎再迭代
开源LLM推理框架 SGLang 发布 v0.5.20 版本。本文介绍 SGLang 的核心特性、v0.5.x 系列的迭代意义以及升级获取方式,帮助开发者了解这款高性能大模型推理引擎的最新进展。
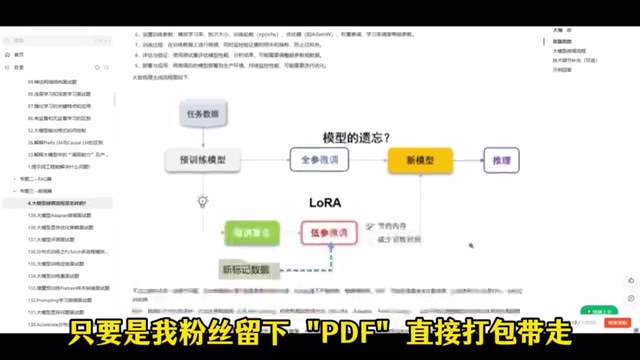
KV Cache为何撑爆显存?大模型推理优化全解析
长对话导致显存爆炸?本文深入解析KV Cache如何存储历史信息加速推理,为何会撑爆显存,以及PagedAttention、FlashAttention、KV量化等主流优化方案,附大模型面试满分回答模板。
vLLM v0.30.0rc1发布:修复FlashInfer BF16自动调优隔离问题
vLLM 发布 v0.30.0rc1 候选版本,核心修复为隔离 FlashInfer BF16 自动调优逻辑(PR #57285)。本文解读该修复的技术背景、FlashInfer 与 BF16 调优机制及对推理部署的实际影响。
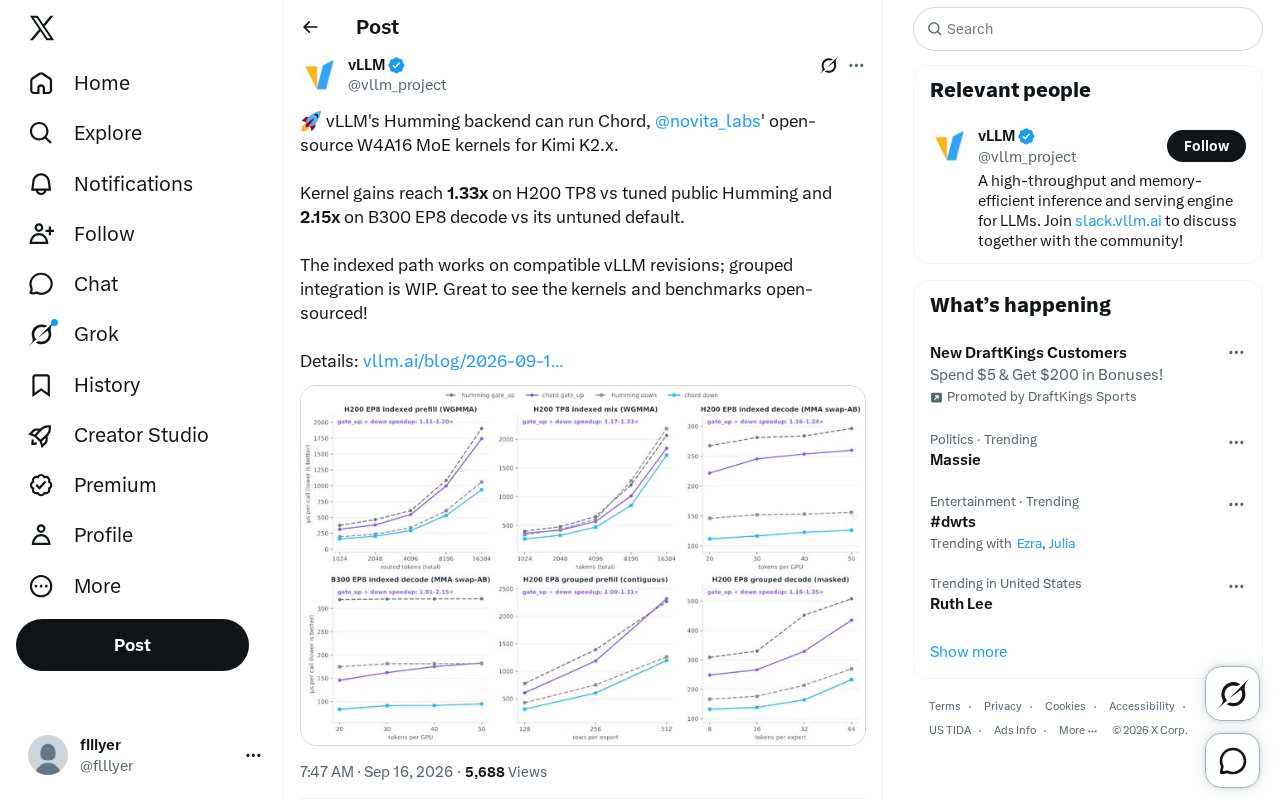
vLLM 集成 Chord 内核:Kimi K2.x 推理加速最高 2.15 倍
vLLM 的 Humming 后端现已支持 Novita Labs 开源的 Chord W4A16 MoE 内核,针对 Kimi K2.x 优化。H200 TP8 加速 1.33 倍,B300 EP8 解码加速最高 2.15 倍,indexed 路径已可用。

KV缓存该放在哪?GPU/CPU/SSD分层放置策略实测解析
一篇arXiv研究通过离散事件模拟器,系统对比GPU/CPU/SSD三级存储下KV缓存的放置策略。结论显示分层可使单GPU并发会话数提升73倍、成本降62倍,但收益主要来自容量而非策略,预取与预测复用被证明得不偿失。
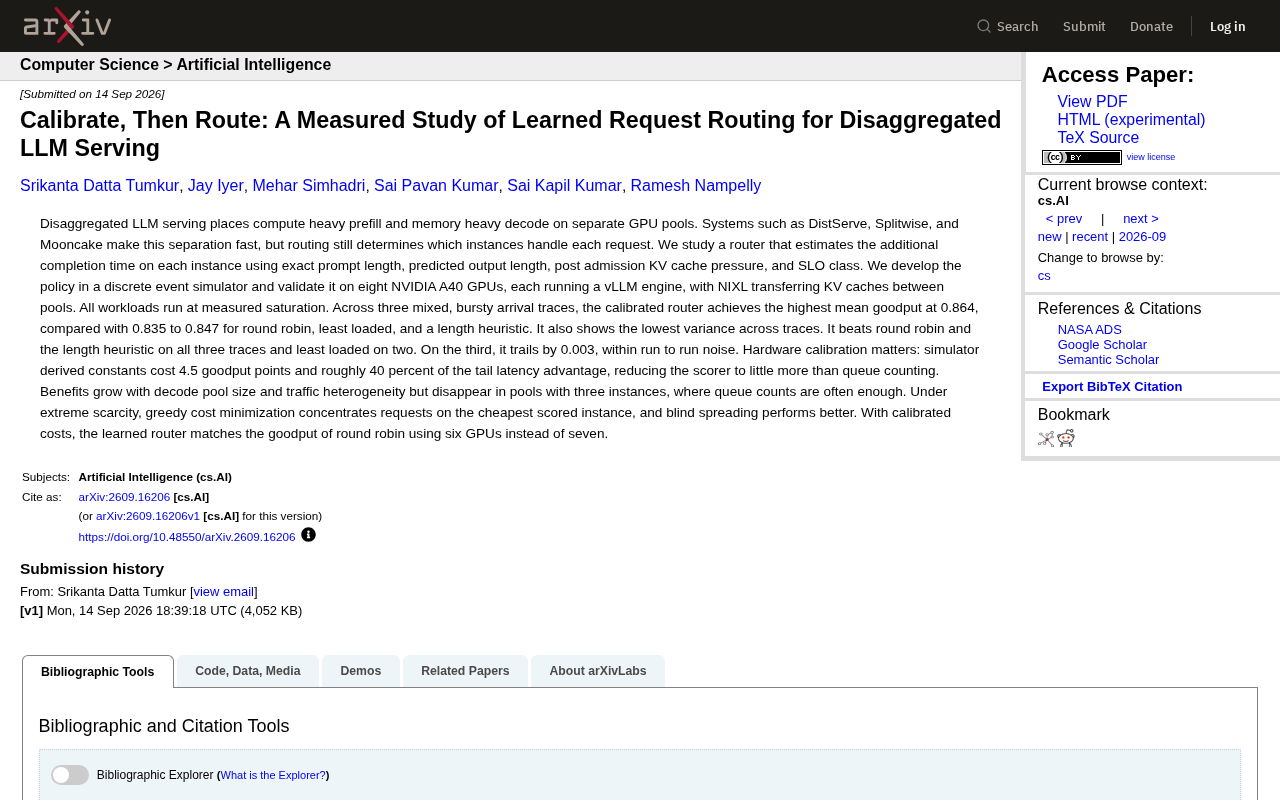
校准后再路由:分离式LLM服务的智能请求调度研究
arXiv 新论文《Calibrate, Then Route》研究分离式 LLM 服务的学习型请求路由。在八块 A40 GPU 实测中,校准后的路由器取得 0.864 的最高 goodput,并能用六块 GPU 达到轮询七块卡的效果。硬件校准是关键。
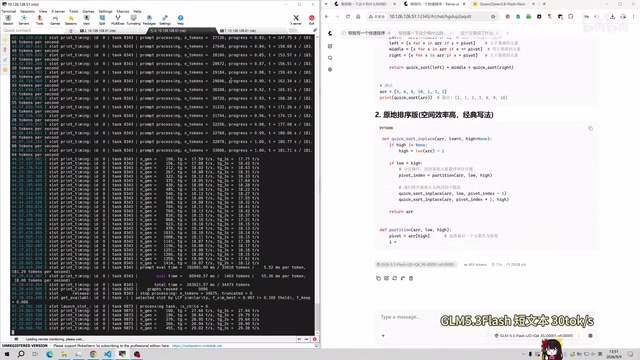
8卡2080Ti 22G本地部署GLM-5.3-Flash实测:TP2 PP4并行方案解析
8卡2080Ti 22G本地部署GLM-5.3-Flash实测:通过TP2 PP4混合并行方案,短文本达30tok/s,33K长文解码18tok/s、预填充180tok/s。深度解析多卡推理的并行策略与推测解码适用性。
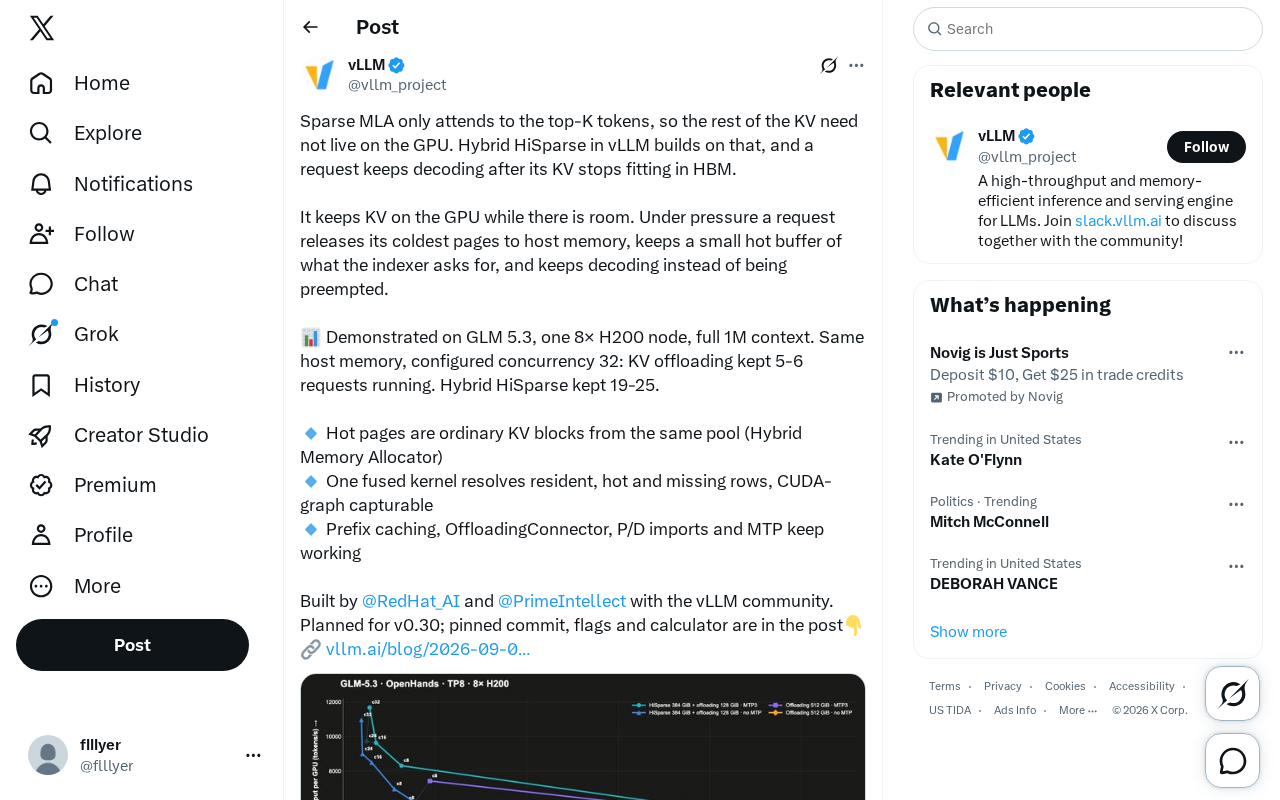
vLLM Hybrid HiSparse:稀疏MLA破解长上下文显存瓶颈
vLLM 社区推出 Hybrid HiSparse,基于稀疏 MLA 与分级内存调度,让长上下文请求在显存不足时持续解码。GLM 5.3 实测显示,8×H200 节点上并发请求数从 5-6 提升至 19-25,将集成于 vLLM v0.30。