#前沿研究
共 6865 篇相关文章
检索片段训练法:406M小模型在会议摘要上媲美1.2B系统
arXiv 新论文提出检索片段训练法,让 406M 参数的会议摘要模型在 QMSum 上媲美 1.2B 系统,参数量仅三分之一、显存不到一半。文章解析其统一评测框架、消融分析与对小模型部署的实践启示。
情绪弧线预测货币政策:央行沟通形状比语气更重要
一项新研究提出用"情绪弧线"分析欧洲央行与美联储新闻发布会,发现情绪在声明中的排序与强调方式比平均语气更能预测利率决策、通胀预期与预测者分歧,指出沟通设计是一阶政策信号。
同量不同答:语言模型的数值表征不变性缺陷
arXiv 最新研究检验语言模型的数值表征不变性:同一数值以小数、分数、科学计数法等不同形式书写时,模型答案是否一致。研究揭示大部分「失败」实为评测器解析缺陷,并发现 Mistral Small 4 在单位换算中存在数量级级别的系统性错误。
计算方法追踪梵语语义演变:低资源古语言的NLP挑战
一篇arXiv论文系统测试了历时词向量在梵语这类古老低资源语言上的适用性,通过神经连声切分、词形还原和分时期训练,在21个语义变化中成功还原19个的文献学方向,为低资源语言NLP提供了可参考的完整方法链路。
用纯Rust训练语言模型:164美元实验背后的框架陷阱
一位独立研究者仅花164美元,用纯Rust(无PyTorch、无Python)端到端预训练了一个4亿参数的孟加拉语模型。报告详细记录了Candle和Burn框架作为训练后端的多个静默缺陷、梯度流验证方法及孟加拉语分词陷阱。
99%准确率的真相:假新闻数据集中的捷径学习审计
一项可复现的审计揭示,广泛使用的假新闻语料库上 99% 的准确率实际测量的是新闻来源与主题的可分性,而非真实性。研究通过泄漏通道分析、主题偏移测试和跨数据集验证,暴露了捷径学习问题。
IntLawNER:国际法领域首个命名实体识别数据集与基准
IntLawNER 是首个面向国际法的命名实体识别数据集与基准,涵盖 ICJ、联合国安理会与欧洲人权法院文本,揭示领域 NER 中的评估陷阱,Claude Opus 4.6 取得最佳表现。

LLM评审共识的陷阱:错误相关性如何夸大证据强度
arXiv最新研究揭示LLM评审共识的隐藏陷阱:评审错误存在显著相关性,十个评审仅相当于3.5个独立评审,高达28%的系统对比结论因忽略共享错误而被夸大。文章解读错误相关性对模型评测的影响及应对方案。
AI群体协商的智慧:多样性模型讨论如何超越单体判断
arXiv新研究将人类"协商智慧"范式迁移到大语言模型,在四个领域验证:多样性模型群体讨论能超越被动汇总,而克隆模型无法获益。多样性是协商机制的关键活性成分。
托管大模型行为评估的可复现性危机:测量方法比模型更影响结论
arXiv新论文揭示托管大模型行为评估的可复现性难题:以Regent Chess环境和Gemini系列为例,证明复现、测量敏感性与持续性可能在同一次评估中得出矛盾结论,呼吁按模型标识符、服务周期、测量工具与推理配置显式标注评估声明。
目标驱动的流程变体分类:用LLM连接行为与业务目标
一篇arXiv论文提出目标驱动的流程变体分类方法,反转传统「先聚类后赋义」的工作流,先构建目标模型再用LLM将流程变体归入业务类别,在三个公开日志上验证了其有效性与可控性。

从2D显微图像推断3D细胞生物物理特性的群体监督框架
一项arXiv研究提出群体监督框架,从2D红细胞显微图像推断3D生物物理特性,聚合出MCV、RDW、MCH等指标,与Sysmex分析仪相关系数达0.86-0.98,并对可识别性边界给出理论分析。
当AI也从众:社会信号如何塑造人工智能对科研的注意力分配
一项最新研究借鉴经典音乐实验室设计,用1000个AI智能体测试社会信号对科研注意力的影响。结果显示AI群体同样会从众:社会信息使选择更集中、覆盖面收窄,且早期随机优势能让论文选中率提升45个百分点。AI的选择与真实引用和下载量对应有限。
PAANI:端侧视觉证据融合,让河流机器人决策可解释
PAANI 是一套部署在 Arduino UNO Q 上的端侧感知-导航架构,融合 YOLO11n 检测与 MobileNetV3 分割,通过证据融合实现可解释的河流机器人导航。本文解析其技术设计、性能指标与局限。

88美元的AI智能盲杖:离线边缘智能如何重塑视障出行辅助
一篇arXiv论文提出仅88美元、完全离线的AI智能盲杖,基于树莓派Zero 2W融合RGB视觉与ToF测距,实现F1达0.82、延迟330毫秒的多模态视障出行辅助,验证低成本边缘原生辅助智能的可行性。
教材还是病例?数据类型如何塑造医疗大模型能力
一项 arXiv 新研究通过 token 对齐的对照实验,揭示教材数据与临床病历数据如何差异化塑造医疗大模型能力:临床数据迁移更广,教材数据偏重知识记忆,且存在知行鸿沟。医疗 LLM 数据策展应以应用为导向。

Delta:基于链式复制的高可用强一致存储系统解析
Delta 是采用链式复制(Chain Replication)架构的高可用强一致分布式存储系统。本文解析链式复制的读写原理、故障恢复机制及其在强一致与高可用之间的工程取舍,帮助理解这类存储系统的设计思路与适用场景。
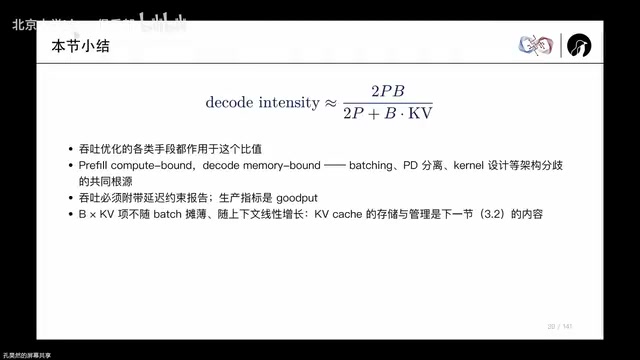
深入LLM推理:从KV Cache到PD分离的Serving全景解析
深入解析LLM推理与Serving技术栈:涵盖KV Cache原理、Prefill/Decode两阶段计算形态、PagedAttention、PD分离、EP并行、投机解码等核心机制,剖析大模型推理系统的关键工程权衡与优化思路。
Opus 5.5泄露定价更低!Qwen4、Kimi K3.1等国产大模型集中来袭
Anthropic Opus 5.5泄露:性能对标GPT-6 Astra但定价更低。同期StepFun Step5、MiniMax M3.1、阿里Qwen4与Kimi K3.1等国产大模型集中来袭,本文梳理这波密集发布背后的降本与开源趋势。
阿里云栖三颗炸弹:Qwen4、真武V900与20GW数据中心背后的成长豪赌
阿里云栖大会一天抛出Qwen4十万亿参数模型、真武V900自研芯片和20GW数据中心三大计划。本文拆解每颗炸弹的真实口径与含金量,并解析阿里为何是成长股而非公用事业。